
KNN-KG
zjunlp/KNN-KG加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下:当你问一个AI「爱因斯坦的母校在哪个城市」时,它不仅要靠参数化的知识(模型权重),还能实时查阅一个装满事实的「知识字典」,把两者结合给出更精准、更可靠的回答——这正是KNN-KG的核心思想。
大语言模型(LLM)虽然强大,但有一个根本性缺陷:参数化知识的容量与精度不可兼得。把海量知识硬编码进模型权重,模型会变得笨拙推理;精简参数,又会遗忘冷门事实。这个矛盾在知识图谱补全(Knowledge Graph Completion, KGC)任务中尤为突出。
知识图谱由「实体-关系-实体」三元组构成,例如 (爱因斯坦, 毕业于, 苏黎世联邦理工学院)。传统知识图谱嵌入方法(TransE、RotatE等)靠一个数学向量来表示每个实体,但无法利用实体的文本描述(如Wikipedia摘要)。同时,模型在训练时见过的知识表现好,没见过的新实体却表现惨淡——这就是所谓的分布外泛化(OOD)问题。
KNN-KG(ACL 2023 / NLPCC 2023 论文)提出了一个优雅的解法:将语言模型的参数化推理与非参数化的最近邻检索相结合。它不替换语言模型,而是在推理时动态检索与输入最相关的知识图谱三元组作为参考,让模型「边推理边查字典」。
KNN-KG 的工作流程分为三个阶段:
阶段一:实体嵌入预训练
使用 BERT-base-uncased 作为基座,将知识图谱中的实体名称(如 "苏黎世联邦理工学院")通过 BERT 编码为向量,训练一个实体嵌入层。训练时用 (头实体, 关系, ?) 的掩码预测任务,让模型学会将实体名称映射到语义向量空间。
阶段二:构建知识存储(Knowledge Store)
将知识图谱中的所有三元组通过训练好的 BERT 编码为向量表示,然后用 FAISS 建立索引。这个「知识存储」本质上是知识图谱的向量化版本,每个向量都关联着对应的三元组。
阶段三:KNN 增强推理
推理时,给定一个查询(如 [MASK] = 爱因斯坦的母校是?),模型先用 BERT 编码查询得到向量,然后在 FAISS 知识存储中做最近邻搜索,找到最相似的 K 个三元组。最后,将语言模型的 logit 与 KNN 检索 logit 加权融合:
P_final = λ · P_LM + (1-λ) · P_KNN
参数 λ 控制两类信号的比例,在实验中通常设为 0.2(即 80% 信任语言模型,20% 参考邻居)。
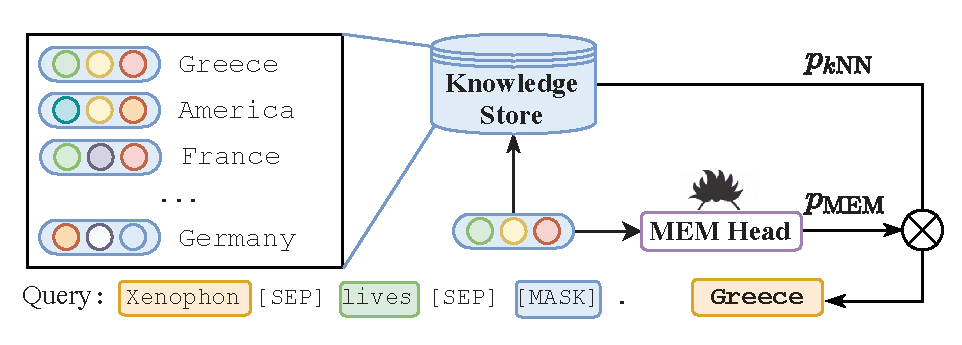
KNN-KG 支持两种设定:
代码库基于 PyTorch Lightning 构建,主要依赖:
| 依赖 | 用途 |
|---|---|
transformers 4.7.0 | BERT-base-uncased 模型基座 |
pytorch_lightning 1.3.1 | 训练循环封装 |
faiss-cpu / faiss-gpu | 高效最近邻向量检索 |
torch 1.8.1+cu111 | 深度学习框架 |
项目目录结构清晰:models/ 存放 BERT-KGC 融合模型,lit_models/ 封装 PyTorch Lightning 训练逻辑,data/ 处理数据加载,dataset/ 包含 FB15k-237 和 WN18RR 两个标准 KGC 基准数据集。
核心训练参数:
KNN-KG 是一个面向研究人员的实验框架,而非开箱即用的产品工具。上手需要以下步骤:
1. 环境配置
pip install -r requirements.txt # 依赖 PyTorch 1.8.1 等旧版本包
⚠️ 注意:requirements.txt 中的包版本较旧(torch==1.8.1+cu111),在新硬件/驱动环境下可能需要手动调整 CUDA 版本兼容性问题。
2. 预训练实体嵌入
./scripts/pretrain_fb15k.sh # 训练实体嵌入层
3. KNN 推理
./scripts/fb15k-237/get_knowledge_store.sh  # 构建 FAISS 索引
./scripts/fb15k-237/inference.sh            # KNN 增强推理
整个流程覆盖了从预训练到推理的完整闭环,适合用来复现论文结果或在此基础上做改进实验。
KNN-KG 并非完美,以下几点值得注意:
知识存储质量决定上限:如果知识图谱本身不完整或噪声较多,KNN 检索会引入错误信号。知识图谱的质量比算法本身更重要。
推理速度下降:每次推理都要做 FAISS 最近邻搜索,在 CPU 上尤其慢。项目建议使用 GPU 版本的 FAISS 来缓解。
参数敏感:λ 和 KNN_topk 的最优值需要大量调参实验,不同数据集的最优组合差异较大。
缺乏工程化:无 Docker、无 Web UI,只有科研脚本,不适合直接部署到生产环境。
KNN-KG 代表了一种重要的研究趋势:参数化模型 + 非参数化知识库的混合架构。这与 RAG(检索增强生成)的思想一脉相承,但专注于知识图谱这一结构化知识载体。
2023-2024 年,检索增强型语言模型成为 NLP 领域的核心方向,KNN-KG 的贡献在于:
从更宏观的视角看,随着 GPT-4、Claude 等大模型在知识密集任务上越来越强,如何让它们与结构化知识库高效协作仍是活跃的研究课题。KNN-KG 的思路——用向量索引连接语言模型与外部知识——在当下 RAG 盛行的背景下显得尤为前瞻。
GitHub: https://github.com/zjunlp/KNN-KG
论文: https://arxiv.org/abs/2201.05575
会议: NLPCC 2023
数据: FB15k-237 / WN18RR
Stars: 55 ⭐
