
agent-skills-hub
zhuyansen/agent-skills-hub加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你准备给 Claude Code 加一个能自动整理会议纪要的技能。于是打开 GitHub,搜索框里敲下 "claude skill",回车。
返回 4000 多个仓库。你开始一个个点开:有的 README 三个月没更新,有的装完就报错,有的文档里夹着不明脚本。再往下翻,第 47 个仓库的 SKILL.md 里出现了一段往 ~/.claude/settings.json 写入未知内容的 curl 命令。
你关掉了浏览器。那天晚上你没有装任何技能。
AgentSkillsHub 的作者 Jason Zhu 想解决的就是这个具体场景——不是"帮你找到技能",而是"帮你判断这个技能能不能用、敢不敢用"。
图:agentskillshub.top 官方社交卡片,项目对外自称覆盖 25 万+ 开源智能体技能目录。
2025 年下半年起,Claude Code、Cursor、OpenAI Codex、Windsurf 这些 Agentic IDE 几乎同时把"技能包(Skill)"变成了标准扩展单位。一个 Skill 就是一个带 SKILL.md 的目录,Agent 读它来决定"何时该做什么"。生态随之爆炸式增长,GitHub 上 claude-skill、mcp-server 主题标签下的项目数以每周数百的速度增加。
但繁荣背后有两个真空:
一是发现真空。 GitHub 的搜索按相关性排序,一万星的老仓库不一定比昨天新建的三星新仓库更靠谱,README 排版混乱、命名随意,一个新人根本无从下手。
二是信任真空。 Skill 是"Agent 会自动执行的指令",本质上比普通 npm 包权限更高——它能读写文件、发起网络请求、调用 shell。2025 年下半年开始,社区里陆续出现恶意 Skill 的报告:偷密钥的、挖矿的、偷偷上报对话记录的。
AgentSkillsHub 的定位就是同时填这两个坑:它既是搜索引擎,也是安全网关。
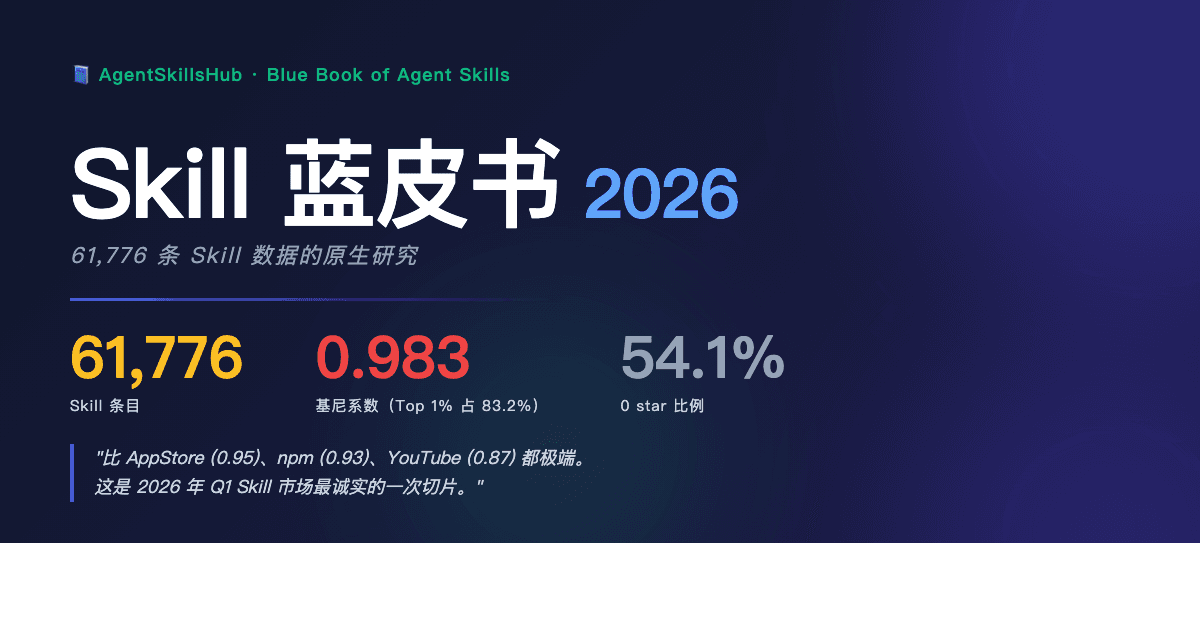
图:仓库内 frontend/content/book/ 下的配套内容包,团队围绕"技能生态"做了一套体系化的研究型内容(含生态生命周期曲线、类目分布、生存曲线等图表)。
打个比方,AgentSkillsHub 之于 GitHub 上的技能生态,就像:
项目的架构在 README 里被概括为一条线:
GitHub API ──▸ 采集 ──▸ 清洗 ──▸ 评估 ──▸ 评分 ──▸ 呈现
              (6阶段)   (分类)   (6维度)  (0-100)   (Web + API)
每 8 小时由 GitHub Actions 触发一轮同步,预算被切得很细:搜索阶段 10+ 条 GitHub 查询(约 30 次请求)、认证作者作者拉取(约 18)、社区投稿与策展补充(约 14)、作者画像补全(≤500)、README 正文抓取(每个 ≤50KB,≤300 个)、入库写入(0 次额外请求)。周中走增量同步(只处理新增/更新),周日跑全量同步。限流处理是"等待 GitHub 真实的 reset 时间",而不是硬退避重试。
按 repo_full_name 去重;用关键词规则把条目分到 7 个类别:mcp-server、claude-skill、codex-skill、agent-tool、prompt-library、ai-coding-assistant、uncategorized;并推断项目类型(框架/技能/工具)与体积档位(micro ≤50KB 到 large >5MB)。
质量维度(services/quality_analyzer.py):完整性 15%、清晰度 15%、具体性 15%、示例 12%、README 结构 23%、Agent 就绪度 20%。注意"Agent 就绪度"是个很有想法的指标——它衡量的是"这个技能是否给 Agent 准备好了接口文档、配置、安装方式、MCP 合规性",这恰恰是普通开源项目不关心、但 Agent 生态必须的。
综合分(services/scorer.py):质量 20%、Stars 18%(log 归一)、新鲜度 11%(指数衰减 e^-0.01d)、Fork 10%、提交 10%、Issue 解决率 10%、势头 8%(Star 增长的 Z-score)、作者粉丝 8%、体积加分 5%(越小分越高)。
此外还有平台推断(17 个平台)、Token 估算,以及可组合性分析(TF-IDF + 8 信号技能配对,回答"这个技能该和谁一起用")。
这是整个项目最有分量的部分。services/security_scanner.py 是一个 5 万字符的纯正则规则引擎,灵感来自 SlowMist 的 Agent 安全框架,把风险模式归纳成 11 类红旗,同时引入五级信任层级:
规则的关键在于同时看"敏感文件路径"和"外传目标"——比如 ~/.claude/settings.json、claude_desktop_config.json、~/.claude/credentials.json 这些 Agent 宿主存密钥和会话记录的位置,再配合 curl -d、scp、/dev/tcp/、"send/upload/post/exfiltrate"这类外传模式,二者同时出现才判高危。这个设计比单纯的黑名单匹配要聪明得多,因为它识别的是行为链而不是特征串。
被规则引擎标为 caution/unsafe 的条目,才进入第二道闸门 llm_security_analyzer.py,由 LLM 做语义复核。这个 LLM 提示词写得相当克制,显式列出了要警惕的误报:知名包管理器的 curl | bash 安装脚本、API Key 配置说明、Docker 里的 sudo、模板引擎里的 eval()——都应判为正常。这说明作者是拿真实数据反复调过阈值的。
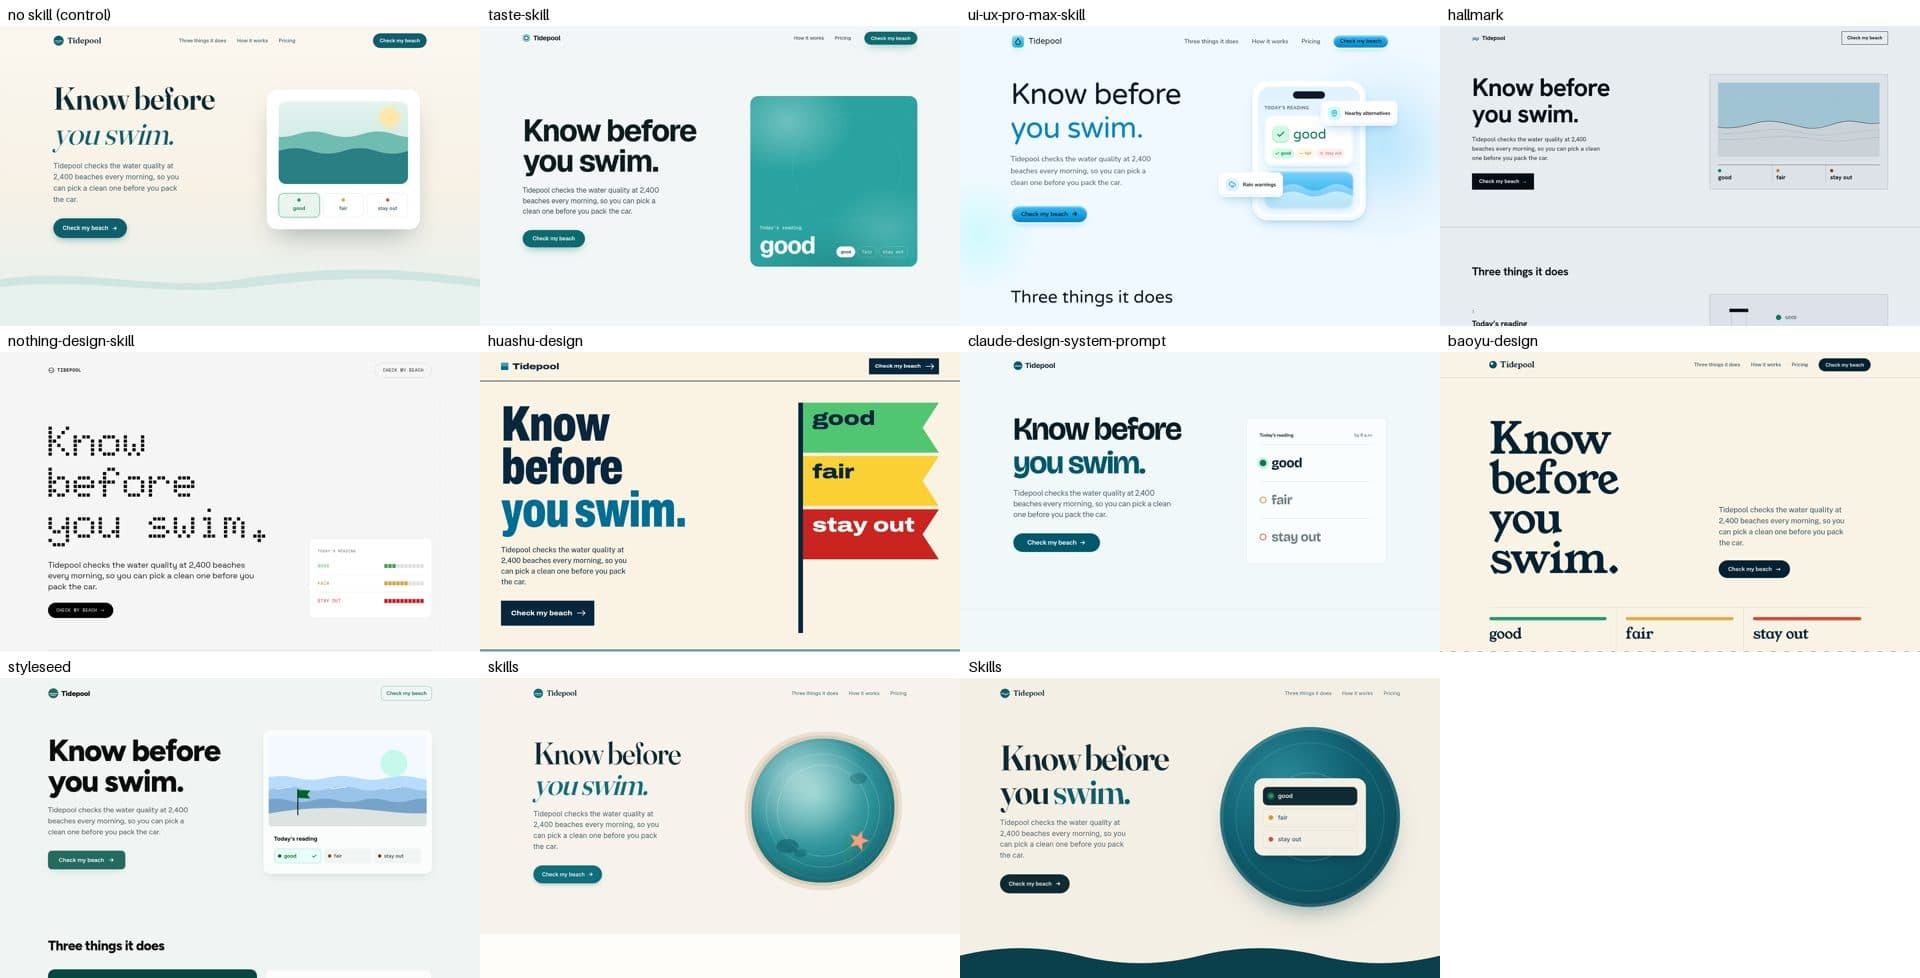
图:站内 /compare/ 对比页的实际渲染效果,支持把多个技能并排拉出来逐维度比较。
生产环境直接用 Supabase 的 PostgREST + RPC,前端 React 18 + TypeScript + Vite + TailwindCSS v4。几个值得注意的工程优化:
get_landing_data() 一个 RPC 替代了原来 7 次以上的 API 调用v_trending / v_top_rated / v_rising 承载排行逻辑tsvector + GIN 索引做全文检索sitemap.xml 覆盖 6000+ URL轻松路线(零部署):直接访问 agentskillshub.top,用现成的目录、对比、审计报告。这是绝大多数人的选择。
自建路线(开发者):
cd backend
python3.12 -m venv venv && source venv/bin/activate
pip install -r requirements.txt
cp .env.example .env        # 填 GITHUB_TOKEN
uvicorn app.main:app --reload

cd ../frontend
npm install
npm run dev
后端依赖很轻:fastapi + uvicorn + sqlalchemy + httpx + apscheduler + scikit-learn(TF-IDF 可组合性)+ openai(LLM 安全分析)。数据库二选一:本地 SQLite 起手,生产用 Supabase PostgreSQL。仓库里已有 28 个 Supabase migration 文件,说明后端是在真实生产库上演进的。
第一,只扫 README,不扫代码。 安全扫描的输入是"小写化的 README 文本"(代码里明确写了 curl -F 被刻意排除,因为在 README 上它会和 -f 混淆)。这意味着:一个 README 干净但 SKILL.md 里藏着恶意代码的技能,这个系统检不出来。安全评级更像"包装层安检",不是"内容层审计"。项目自己提供了 Skillspector 集成规范(docs/skillspector-integration-spec.md)作为补充,说明作者清楚这个边界。
第二,评分是启发式的,不是客观的。 "README 结构占 23% 权重"这类规则简单透明,但也意味着一个格式漂亮、文档详尽但实际质量平平的项目能拿高分。反过来,文档朴素但代码优秀的老项目会被低估。这类排行榜的通病,参考时心里要有数。
第三,单人主导 + 极高的仓库体量。 contributors 只有 2 人(其中包含 github-actions bot),1064 次提交,1808 个文件,代码库 73MB。这是一位作者 Jason Zhu 的长期独自推进。好处是方向一致、迭代快;风险是 bus factor = 1,且 supabase 迁移脚本已到 v8 阶段(008_fix_subscribers_rls),schema 演进路径对外部贡献者并不透明。
第四,商业模式与公益定位的混合。 仓库里有 Stripe 轮询 workflow、企业版线索收集、Pro 会员与 Pro 看板的 migration、DeepAuditOffer(深度审计付费入口)、企业版落地页。"免费目录 + 企业安全审计"的组合在开源目录里是常见且合理的商业模式,但需要意识到:免费评级由商业体提供,评分规则与商业服务之间是否存在利益相关性,外部无法完全验证。
第五,SKILL 生态本身的合规性尚未解决。 一个被目录收录的 Skill 能被 Agent 自动执行,这中间的"责任链"在法律和工程上都没有定论。目录做了分级,但真正被 Agent 拉起来跑的往往仍是原始 GitHub 仓库。
AgentSkillsHub 最有价值的贡献其实不是那个网站,而是它把"Skill 质量"和"Skill 安全"从感觉变成了可计算的指标。
在 CLI 时代,我们有 npm 的下载量、包的漏洞扫描(Snyk)、以及后来才出现的 OSV 数据库。在 Agent 时代,Skill 是新的可执行依赖,但它连一个统一的包管理器都没有——没人知道全网有多少个 Skill、哪些有后门、哪些还在维护。AgentSkillsHub 用 8 小时一次的增量同步 + 分级 + 信任层级,实际上是在给这个新物种补上"供应链治理"的第一层基础设施。
从数据上看,仓库里 frontend/content/book/ 那一整套内容——生存曲线、类目分布、9×4 矩阵——说明作者在做的不只是导航站,而是试图为这个生态写一份阶段性产业报告。仓库还内嵌了完整的书籍正文(ch03 到 ch09 各章配图),并配 docs/ 下的评分算法说明、Superpowers 规格与竞品研究(LobeHub 对比)。
图:技能横向对比视图,站内提供 /best/{场景}/ 落地页与多维打分对比。
AgentSkillsHub 把一件朴素的事做透了:在给 AI 装能力之前,先给这个能力做个体检。
它不完美——只扫 README、启发式评分、单人维护、商业与公益交织。但在一个每天都有新 Skill 涌现、而绝大多数用户没有能力判断"这个 Skill 会不会把我的密钥发出去"的市场里,它提供了目前最接近"公共基础设施"的答案。
对国内团队来说,它的评分算法(尤其是 README 结构与 Agent 就绪度两维)和 SlowMist 风格的信任层级模型,都是可以直接借鉴到自建内部技能库的设计参考。
数据采集自 GitHub API(2026-11-04 快照):487 Stars / 54 Forks / 29 Open Issues / 1808 文件 / 1064 次提交 / 2 位贡献者 / MIT 许可 / 主语言 Python。
