
codi
zhenyi4/codi加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你有没有想过,大语言模型(LLM)做数学题时,那些洋洋洒洒的推理步骤,真的每一步都不可或缺吗?
当你让一个 7B 参数的模型做数学题时,它往往需要"先想再答"——输出一长串中间推理步骤(Chain-of-Thought,思维链),再给出最终答案。这个过程固然提升了准确率,却也极大拖累了推理速度。每一次自回归生成一个 token,都意味着一次 GPU 运算。
CODI(Compressing Chain-of-Thought into Continuous Space via Self-Distillation) 提出了一个大胆的问题:能不能把"思考过程"本身压缩掉,只保留精髓?
思维链(Chain-of-Thought)自 2022 年被提出以来,已经成为 LLM 推理的标准范式。它的核心思想是:让模型在给出最终答案前,先生成一系列中间推理步骤,这些步骤帮助模型"想起来"正确解法。
然而,CoT 的代价是显著的:
学术界的解法主要有两条路:
但这两条路都有缺陷:剪枝丢失信息,蒸馏仍需教师模型完整输出长 CoT。
CODI 的思路另辟蹊径——不压缩 CoT 的文本,而是把 CoT 的"语义意图"蒸馏进连续的隐空间(Latent Space)。
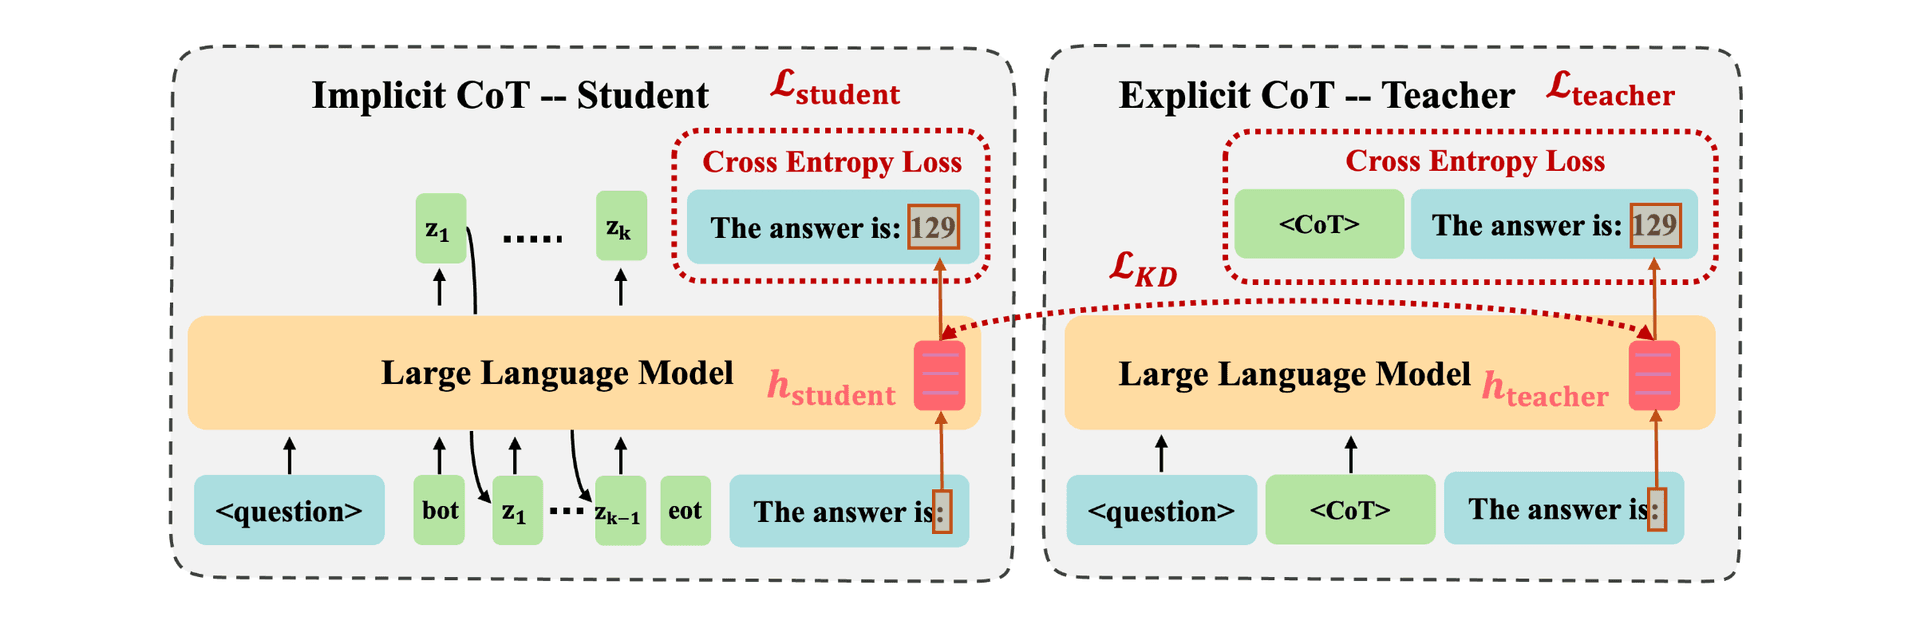
具体来说:
这相当于把"长篇大论的思考过程"压缩成了几个"内心独白的关键词"——表面看起来答案直接生成,实际上隐空间里已经完成了完整的推理压缩过程。
项目在 HuggingFace 上提供了两个开箱即用的预训练权重:
zen-E/CODI-gpt2:基于 GPT-2 small 的 CODI 蒸馏版本zen-E/CODI-llama3.2-1b-Instruct:基于 Llama 3.2 1B Instruct 的 CODI 蒸馏版本直接在 GSM8K 上评测,无需任何微调:
# 评测 GPT-2 版本
bash script/test_gpt2.sh
# 评测 Llama 1B 版本
bash script/test_llama1b.sh
CODI 基于 HuggingFace Transformers + PEFT(LoRA/QLoRA)实现,关键训练参数:
| 参数 | 说明 |
|---|---|
num_latent | 训练时使用的隐式思维 token 数量 |
inf_latent_iterations | 推理时的隐式思维 token 数量 |
prj_dim | 投影层隐藏维度 |
distill_loss_factor | 蒸馏损失权重 |
ref_loss_factor | 教师交叉熵损失权重 |
支持多条训练数据路线:GSM8K-Aug(带数据增强的 GSM8K)、GSM8K-Aug-NL(自然语言版)、Commonsense(常识推理)。
投影层是 CODI 的核心组件,位于 transformer 输出层之后。它的作用是将最后一层隐藏状态投影到与"教师隐思维"对齐的空间:
# 来自 src/model.py
class ProjectionLayer(nn.Module):
    def __init__(self, hidden_size, prj_dim):
        self.projection = nn.Linear(hidden_size, prj_dim)
        self.layer_norm = nn.LayerNorm(prj_dim)
投影层可以加或不加 LayerNorm(prj_no_ln 参数),实验表明这一选择对最终效果有影响。
conda create --name codi python=3.12
conda activate codi
pip install -r requirements.txt
requirements.txt 包含了 PyTorch 2.7.1、Transformers 4.52.4、PEFT 0.15.2 等核心依赖。GPU 是必需的——项目明确使用 torch.device("cuda"),CPU 推理极慢。
最快体验路径:下载 HuggingFace 上的预训练权重,在 GSM8K 上评测准确率。
# 评测 GPT-2 版本(推荐先跑这个,资源占用小)
bash script/test_gpt2.sh

# 评测 Llama 3.2 1B 版本
bash script/test_llama1b.sh
也可以换数据集测试泛化能力:svamp、gsm-hard、multi-arith。
在 GSM8K-Aug 上微调:
bash scripts/train_gpt2_gsm8k-aug.sh
在 Commonsense 上微调:
bash scripts/train_gpt2_commonsense.sh
最有趣的功能:把隐式思维 token 投影到可视化的低维空间,看看模型"脑子里在想什么":
bash scripts/probe_latent_token.sh
输出保存在 outputs/ 目录。
CODI 不是没有争议。最核心的问题是:隐式思维的可解释性如何保障?
当 CoT 是显式文本时,我们可以逐条审查推理过程,发现逻辑错误或幻觉。但当思维被压缩进隐空间后,"脑子里在想什么"就成了黑箱。论文提供了 probing 可视化工具,但这更像是事后分析,而非实时可解释性保证。
此外,项目没有提供 License 声明,代码库本身没有明确的开源许可证。这在学术合作场景下需要特别注意——复用代码前请确认作者授权。
从工程角度,项目缺少以下内容:
CODI 被 EMNLP 2025 接收,本身就说明了学术界对"高效推理"方向的持续关注。在 LLM 推理成本日益成为瓶颈的背景下,隐式思维链压缩代表了一条有潜力的技术路径。
类似的探索还包括:
CODI 与这些方法互补——它不压缩推理过程本身,而是压缩"思考的内部表示"。未来如果能与量化、剪枝等技术结合,可能在保持准确率的同时实现更激进的推理加速。
CODI 是一篇扎实有创意的 EMNLP 2025 论文,提出了将显式思维链蒸馏为隐式连续表示的新范式。代码实现完整,预训练权重可直接评测,工程上值得 AI 推理优化方向的研究者和工程师关注。
上手难度中等,适合有 Transformer 微调基础的开发者。核心限制是缺乏容器化和 API 服务化,部署需要一定二次开发工作量。
