
GLM-4-Voice
zai-org/GLM-4-Voice加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
清晨,你对手机说"今天有点累",Siri 会机械地回复天气和日程——这是传统语音助手的答案。但如果你对 GLM-4-Voice 说同样的话,它会用带着些许关切的声音回应你,甚至主动问你是否需要听点轻音乐。
这背后,是一次从"语音转文字再转语音"到"端到端原生语音建模"的范式跃迁。
2024年12月,智谱AI在CNCC大会上开源了 GLM-4-Voice,这是国内首个开源的端到端语音大模型,也是智谱迈向AGI多模态能力的关键一步。它的出现,让中文语音交互终于有了一款可本地部署、可深度定制的开源方案。
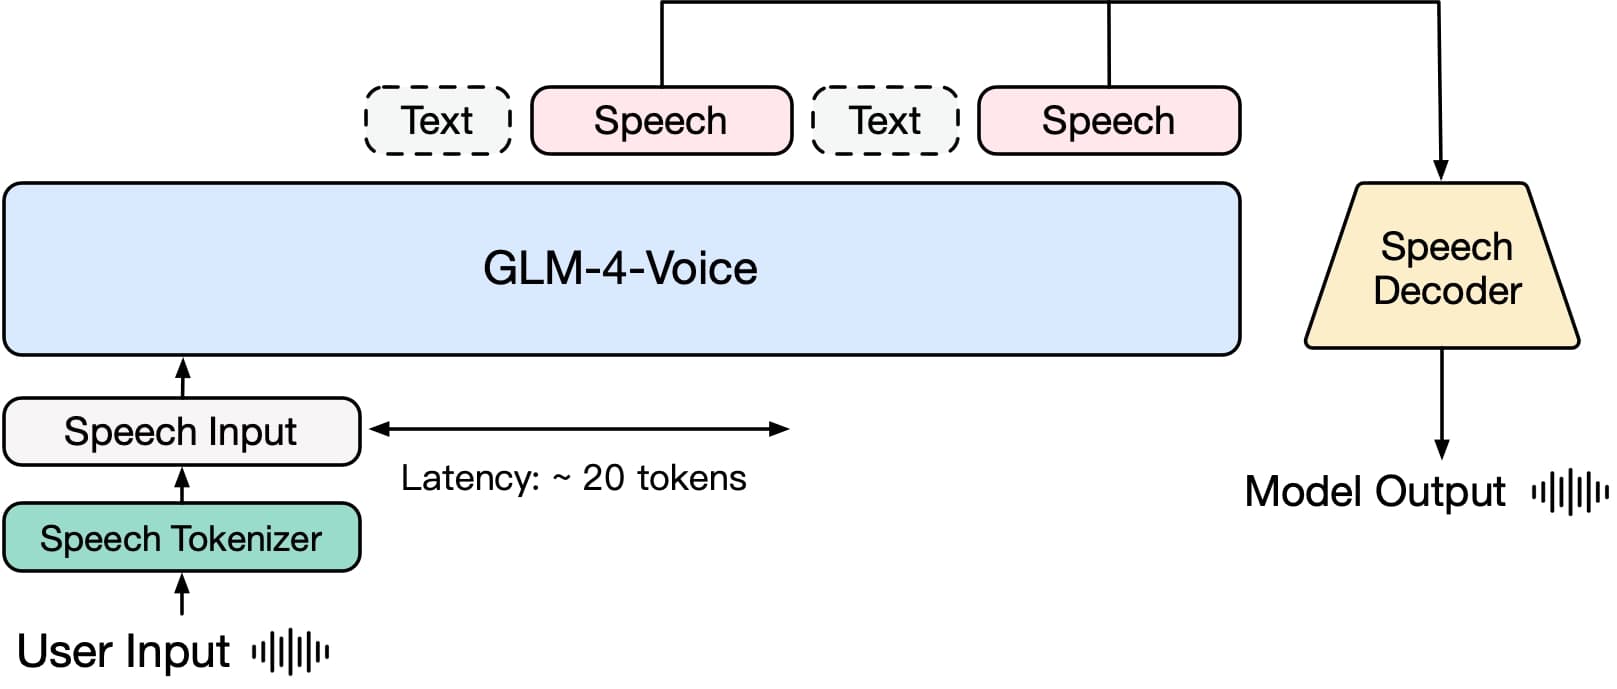
GLM-4-Voice 整体架构,由 Tokenizer、LLM 和 Decoder 三部分组成
传统语音对话系统是一个"三明治"结构:ASR(语音识别)→ LLM(语言模型)→ TTS(语音合成)。每一层之间都有信息损耗,而 GLM-4-Voice 用端到端建模从根本上绕开了这个问题。
GLM-4-Voice 的核心技术架构分为三个模块:
GLM-4-Voice-Tokenizer(语音分词器):基于 Whisper Encoder 改造,加入 Vector Quantization 层,将每秒音频压缩为仅 12.5 个离散 token。这意味着原本海量的音频波形被高度抽象化,变成 LLM 可以直接理解的离散符号。
GLM-4-Voice-9B(语言模型基座):在 GLM-4-9B 基础上进行语音模态预训练和对齐,使 LLM 能够直接理解和生成离散语音 token。预训练使用了数百万小时音频和数千亿 token 的音频-文本交错数据。
GLM-4-Voice-Decoder(语音解码器):基于 CosyVoice 的 Flow Matching 结构,支持流式推理,最少仅需 10 个 token 即可开始生成语音,大幅降低端到端对话延迟。
情感表达:GLM-4-Voice 不只是"读"文本,它能理解"高兴""悲伤""激动"等情感标签,并用相应的语气、语调、停顿来表达。相比传统 TTS 机械刻板的合成音,这是一个质的飞跃。
实时打断:在与模型对话过程中,用户可以随时插话、打断,模型会立即响应新指令。这是真正自然对话的标志——不需要等模型说完,用户可以像和人交流一样随时纠正或改变话题。
方言控制:支持中英文及多种中国方言(粤语、重庆话、北京话等),且可以在对话中动态切换方言。例如用重庆话要求它念绕口令,它能准确识别并以目标方言回应。
语速调节:同一次对话中,用户可以要求"说得快一点"或"慢一点",模型会在保持内容连贯性的同时实时调整语速。
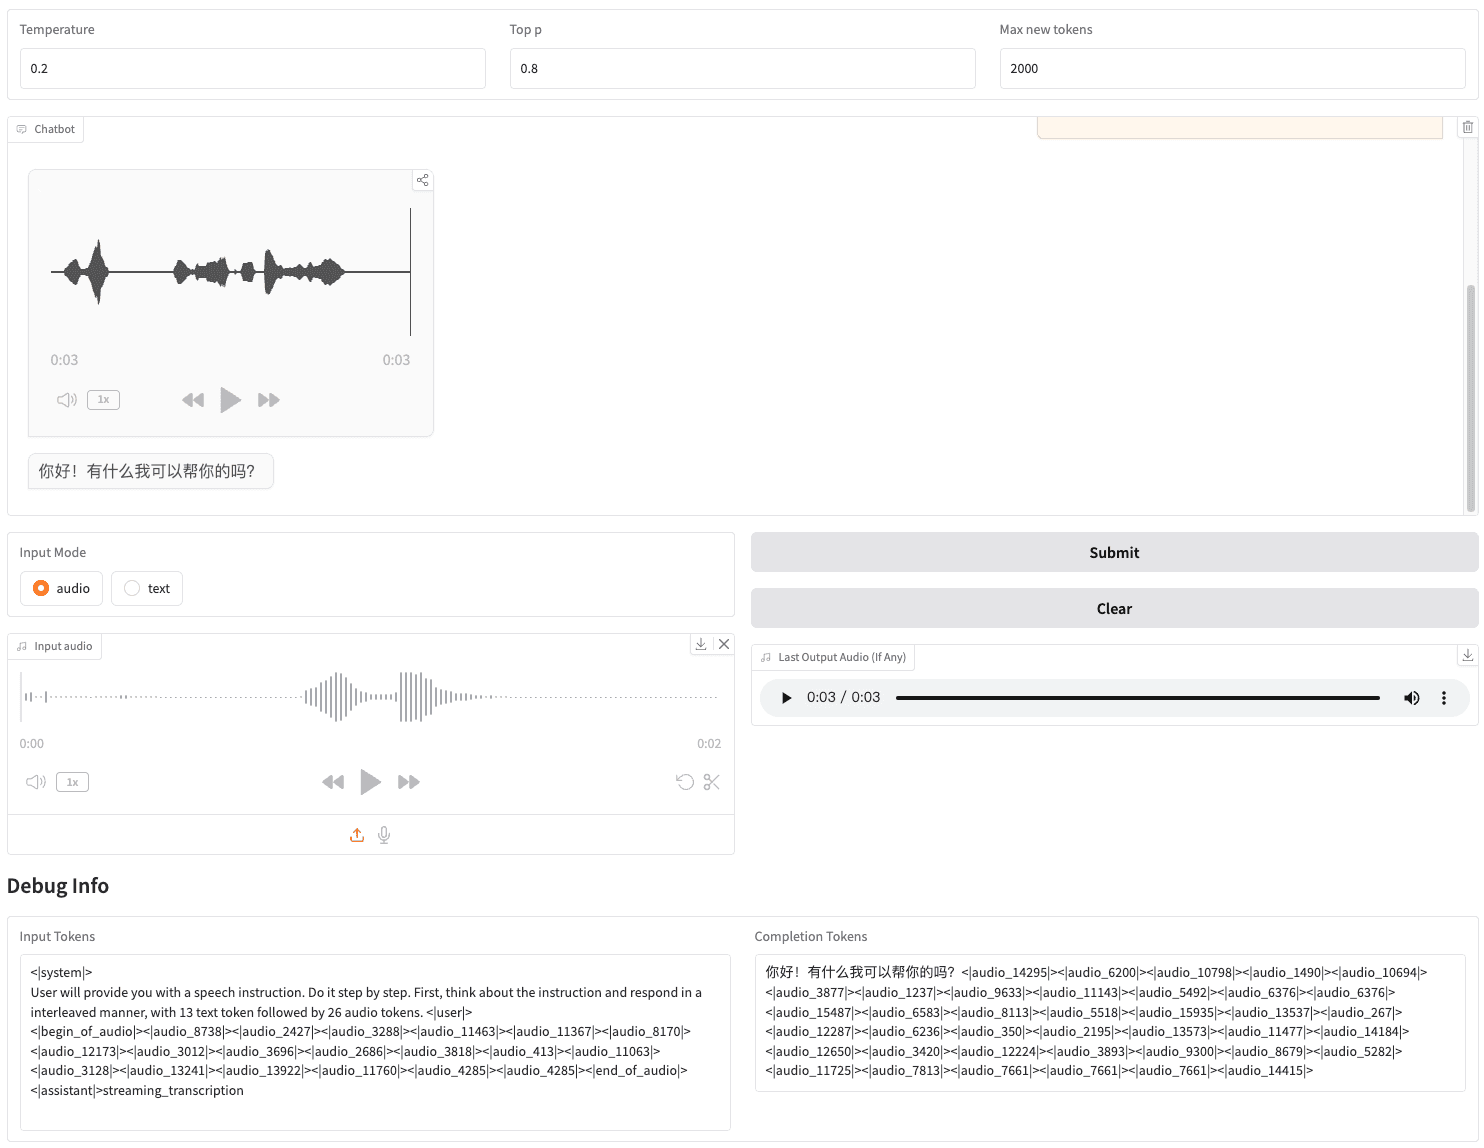
GLM-4-Voice Web Demo 界面,支持语音和文本双输入
对于开发者来说,GLM-4-Voice 的开源带来了前所未有的灵活性,但部署过程确实存在一定门槛。
依赖复杂度高:需要安装超过 30 个 Python 包,包括 transformers、diffusers、librosa、onnxruntime-gpu 等重型依赖。requirements.txt 中明确指定了 CUDA 11.8+ 和 torch 2.3.0 的要求。
模型权重分散:项目分为三个独立模型(Tokenizer、LLM、Decoder),其中 Decoder 需要单独通过 Git LFS 下载,无法通过 transformers 自动加载。ModelScope 和 HuggingFace 均提供了模型托管,但国内访问 HuggingFace 存在网络问题。
硬件要求较高:9B 参数模型在 bfloat16 精度下需要约 20GB+ VRAM,推荐配置为高端消费级显卡(如 RTX 4090)或专业级 GPU(如 A100)。int4 量化版本可将 VRAM 需求降至 10GB 左右,但仍需中高端显卡。
缺少容器化支持:项目未提供 Dockerfile 或 docker-compose.yml,无法实现一键部署。官方提供了预装镜像 zhipuai/glm-4-voice:0.1,但拉取速度可能受网络影响。
深入代码可以感受到,这是一个偏研究导向的项目。
model_server.py 提供了基于 FastAPI 的模型服务封装,支持 bfloat16 和 int4 两种推理精度,代码结构清晰、注释完整。但整体测试覆盖率较低,项目中未发现单元测试或集成测试文件。
flow_inference.py 实现了语音解码器的流式推理逻辑,包含淡入淡出(fade in/out)的音频拼接处理,是整个 pipeline 中工程化程度较高的部分。
web_demo.py 使用 Gradio 构建交互界面,支持语音录制和文本双输入,但 README 中明确提到 Gradio 的流式音频播放效果不稳定,建议在生成完成后点击对话框获取高质量音频。
GLM-4-Voice 的技术栈横跨语音处理和语言模型两个领域:
| 层级 | 技术 | 说明 |
|---|---|---|
| 语音编码 | Whisper Encoder + VQ | 将音频压缩为离散 token |
| 语言模型 | GLM-4-9B(9B 参数) | 理解和生成语音 token |
| 语音解码 | CosyVoice Flow Matching | 流式生成高质量音频 |
| 推理框架 | Transformers + DeepSpeed | 支持分布式推理 |
| Web 界面 | Gradio 5.3.0 | 交互式语音对话 |
| API 服务 | FastAPI + Uvicorn | 模型推理服务化 |
| 音频处理 | Librosa + SoundFile | 音频预处理和后处理 |
GLM-4-Voice 的发布,填补了国内开源端到端语音大模型的空白。在此之前,业界可选的高质量中文语音开源方案非常有限,而 GPT-4o 的语音能力也迟迟未向公众开放。
端到端语音建模相比传统级联方案的革命性在于:它让模型在语音层面直接"理解"语音,而不是经过文字这个中间层。这不仅消除了信息损耗,更重要的是让模型能够捕捉到语音中的副语言信息——语气、停顿、情绪、方言特征——这些文字无法表达的信号。
对于 AI 陪伴、情感助手、客服机器人、教育口语陪练等场景,端到端语音模型意味着更自然、更有人情味的交互体验。GLM-4-Voice 的开源,让这些应用在国内有了可落地的技术基础。
推理速度:虽然 Decoder 支持流式输出,但 9B 参数模型在消费级 GPU 上的响应延迟仍然较高,难以满足实时交互的体验要求。
声音个性化:目前模型不支持声音克隆或个性化音色定制,所有对话都使用统一的默认音色。
视频融合:智谱已预告视频通话功能的上线,端到端语音 + 视觉的多模态融合将是下一代产品的核心竞争力。
开源完整性:Tokenizer 和 LLM 部分通过 HuggingFace 开源,但 Decoder 仍需通过独立仓库下载,这种拆分对部分开发者造成了一定困扰。
总体而言,GLM-4-Voice 是 2024 年中文 AI 开源社区最重要的发布之一。它证明了国内团队在端到端语音建模领域已具备世界级的技术实力,也为国内开发者提供了一条不依赖商业 API 的本地化部署路径。尽管部署门槛不低,但其技术领先性和开源自由度的组合,足以让认真投入的开发者获得丰厚回报。
