
Skill_Seekers
yusufkaraaslan/Skill_Seekers加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
设想一个很常见的场景:团队决定用 Claude Code 改造一个遗留系统。第一步是把 Django 的官方文档、PostgreSQL 的手册、团队内部 Wiki 上的运维规范,整理成 AI 能读懂的"技能包"。
传统做法是:开十几个标签页,通读文档,手动摘抄要点,整理成 SKILL.md,再拆成若干 references/ 参考文件。一个中等规模项目的文档集可能有两三百页,人工整理下来是两天起步。而更糟的是,两周后文档更新了,你完全不知道技能包里的哪些段落已经过时。
Skill Seekers(仓库 yusufkaraaslan/Skill_Seekers)把这个流程压缩成三条命令。它在 2025 年 10 月创建,至今不到一年已经积累约 1.5 万星、1500+ fork、47 位贡献者,最新版本 v3.9.0,Python 编写,MIT 协议。
2025 年下半年起,Claude Code、Cursor、Windsurf 等工具把"技能包"(Skill)变成了 AI 编程助手的标准上下文单元——一个规范化的 SKILL.md 加上配套参考文件,AI 在需要时按需加载。这催生了一个新问题:这些技能包的内容从哪来?
绝大多数技能包是手写的。作者要读文档、提炼知识点、写示例、组织目录结构。Skill Seekers 的作者观察到,一个可以被机器提取的知识源,同时也是一种可以被打包成技能的知识源——文档站的结构、GitHub 仓库的代码、PDF 的章节,本质上都是"知识",只是需要一层转换器。
项目定位因此从最初的"文档爬虫"演进为"AI 系统的数据层"(The Data Layer for AI Systems):一次准备,导出到 22 个目标平台。这个定位转变也体现在仓库演进上——项目在 2026 年从 v1.0 直接跳到 v3.x,中间经历了大规模重构。
打个比方。传统的做法相当于你雇了一批实习生,每人负责一个文档站,手抄卡片、分类归档、写成索引。质量取决于实习生是否认真,而且他们不会告诉你哪份资料过期了。
Skill Seekers 更像一台资料装订机:你把一整箱原始资料(URL、仓库、PDF)倒进进料口,它自动完成清点(探测源类型)、抽取正文(爬虫 / AST / OCR)、分类(按 API、指南、教程等主题聚类)、写摘要(调用 LLM 增强)、装订成册(生成 SKILL.md 与参考文件)、贴标签(生成 YAML 元数据)、装箱(打成 ZIP)。最后还附带一个"装订错误检测"环节——当同一主题下多个来源说法矛盾时,它会主动提示。
输入侧(18 种源类型) 覆盖得相当彻底:文档网站(支持 sitemap.xml → llms.txt → 无头浏览器渲染的三层发现机制,专门解决 React/Vue 这类 SPA 站抓不到内容的问题)、GitHub 仓库、本地代码库、PDF、Word、EPUB、Jupyter Notebook、OpenAPI/Swagger、PowerPoint、AsciiDoc、RSS/Atom、Man page、Confluence、Notion、Slack/Discord 聊天导出、YouTube/Vimeo 视频、HTML 目录。
输出侧(22 个目标) 分三类:12 个 LLM 平台(Claude、Gemini、OpenAI、Kimi、MiniMax、DeepSeek、通义千问、OpenRouter、Together、Fireworks、OpenCode、Markdown)、8 个 RAG/向量库目标(LangChain、LlamaIndex、Haystack、Chroma、FAISS、Weaviate、Qdrant、Pinecone),加上 Atlas 和 IBM Bob。
代码分析(C3.x 管线) 是它区别于普通爬虫的关键:三条数据流并行——代码分析(AST 解析、GoF 设计模式识别,覆盖 9 种语言)、文档抽取(README、docs/、Wiki)、社区信息(Issues、PR、仓库元数据)。还能从测试代码里反向提取真实用法示例,并用 AI 生成"how-to"操作指南。
冲突检测 是项目的核心卖点之一。多来源合并时,同一份资料在两处描述不一致的情况很常见,Skill Seekers 会对这些表述做两两比对并标记冲突位置,避免生成语义含糊的技能包。
AI 增强 分两种模式:API 模式(Anthropic / Gemini / OpenAI / Kimi / MiniMax 等 12 家)与 LOCAL 模式(直接驱动本地的 Claude Code、Codex、OpenCode 等 CLI Agent,零 API 成本)。深度用 --enhance-level 0-3 控制。
MCP 服务 提供 40 个工具,支持 stdio 与 HTTP 两种传输。装好之后你可以在 Cursor 里直接说"打包并上传 React 技能包",Agent 自己调用工具完成全流程。
工程化细节也相当扎实:68 个 workflow 预设(从 api-documentation.yaml 到 security-focus.yaml)、质量评分门禁(--threshold 7)、文档变更检测与定时重抓、增量更新、仅依赖标准库的 SQLite FTS5 全文检索索引(让 Agent 先查再读,避免整份 Markdown 灌进上下文)。
最小可用路径极其简短:
pip install skill-seekers
skill-seekers create https://docs.djangoproject.com/
skill-seekers package output/django --target claude
三条命令后你会得到 output/django-claude.zip。需要更多能力时再用 extras 安装:skill-seekers[all-llms](全部 LLM 平台)、[mcp](MCP 服务)、[video]、[confluence]、[notion]、[all]。
Web UI 方面,项目带有一套完整的 FastAPI + Vite + React + Tailwind + Radix UI 管理界面(skill-seekers ui),带任务队列、技能库、配置市场、MCP 工具与设置页。但要注意:界面是仓库里的源码,构建产物需要自己编译或使用 Docker 镜像。
硬件门槛低:核心功能纯 CPU,4GB 内存足够。只有启用视频视觉抽帧(easyocr)与本地 Whisper 转写时才需要 GPU,项目提供 --setup 自动检测 GPU 并安装匹配的 PyTorch 变体。
环境变量(ANTHROPIC_API_KEY、GITHUB_TOKEN、各 LLM 平台密钥)只影响增强与打包上传等可选能力,不配置也能跑通完整的"抓取 → 生成"流程。
质量依赖上游:如果抓取的文档本身是错误的,工具只会把它忠实地"技能化"。LLM 增强环节可能对抓取到的碎片信息产生过度联想,生成看似合理但无中生有的示例。官方提供了质量评分门禁作为缓解手段,但使用者仍需要抽查 SKILL.md 中的关键结论。
抓取伦理与版权:批量抓取文档站、Confluence、Notion 的行为触及服务条款与版权边界。项目对内部文档场景最为合理,对公开文档站的规模化抓取则需要谨慎评估。
star 增长与工程成熟度的落差:1.5 万星在不到一年内达成,版本号从 v1.0 跳到 v3.9,CHANGELOG 有 22 万字符——迭代速度极快,也意味着文档、CLI 参数、API 结构存在版本漂移。集成到生产流程时需要锁死版本。README 里徽章显示 3900+ 测试通过,测试密度是可信的积极信号,但测试文件与源码同为 AI 辅助生成的比例较高。
功能发散:18 种源类型 × 22 个目标 × 12 家 LLM × 40 个 MCP 工具,组合空间极大,也带来了配置复杂度。doctor 命令和大量 YAML 预设说明作者意识到了这个问题,但对新用户来说,第一次上手仍需要阅读文档。
安全的双刃剑:项目内置了提示词注入检测(扫描抓取内容中的可疑模式),这是清醒的做法——毕竟它把不可信的网页内容喂给 LLM。但生成的技能包本身若携带恶意指令,仍需在使用端审查。
Skill Seekers 的意义不在于爬得多快,而在于它把"知识打包"确立为一个独立工序。这个仓库是 GitHub Trending 上罕见的"Agent 基础设施"类型项目——它不直接提供智能能力,而是为 Claude Code、Cursor、Windsurf 等工具提供高质量上下文,扮演的是数据管道而非模型层。
从更长的时间尺度看,它反映了 2026 年 AI 工具链的一个结构性趋势:AI 能力的边际成本正在向"上下文供给"转移。当模型能力趋于同质,决定效果的是喂给它的知识是否结构化、是否最新、是否与当前任务匹配。Skill Seekers 站在这条链的输入端,并且把"知识新鲜度"做成了产品特性——自动检测文档变更、定时重抓,这恰恰是大多数人工维护的技能包做不到的。
同时,19 个 Agent 的自动安装路径(Claude Code、Cursor、Copilot、Aider、Goose、Roo、Kilo、Kimi Code、IBM Bob……)也勾勒出一个事实:技能包正在成为跨工具的通用资产格式,就像今天的前端构建产物一样。谁掌握了转换器和分发渠道,谁就掌握了这条管道的上游。
基本信息
| 项目 | Skill Seekers |
|---|---|
| 仓库 | yusufkaraaslan/Skill_Seekers |
| Star / Fork | 约 15,200 / 1,542 |
| 语言 | Python 3.10+ |
| 许可证 | MIT |
| 贡献者 | 47 人 |
| 版本 | v3.9.0(pyproject 标注 3.11.0.dev0) |
| 官网 | skillseekersweb.com |
| 部署方式 | CLI / pip / Docker / docker-compose / Helm / FastAPI Web UI / MCP Server |
技术栈速览
Python 核心 + httpx 异步抓取 + BeautifulSoup4/html5lib + PyMuPDF/OCR + PyGithub/GitPython + Playwright 渲染 + Anthropic/Gemini/OpenAI SDK + LangChain/LlamaIndex 导出 + FastAPI/Starlette + Vite/React/Tailwind 前端 + MCP SDK(40 工具)+ pytest(3900+ 测试)
图:Skill Seekers 项目 Logo —— 一台把文档"打包"成技能的数据管道
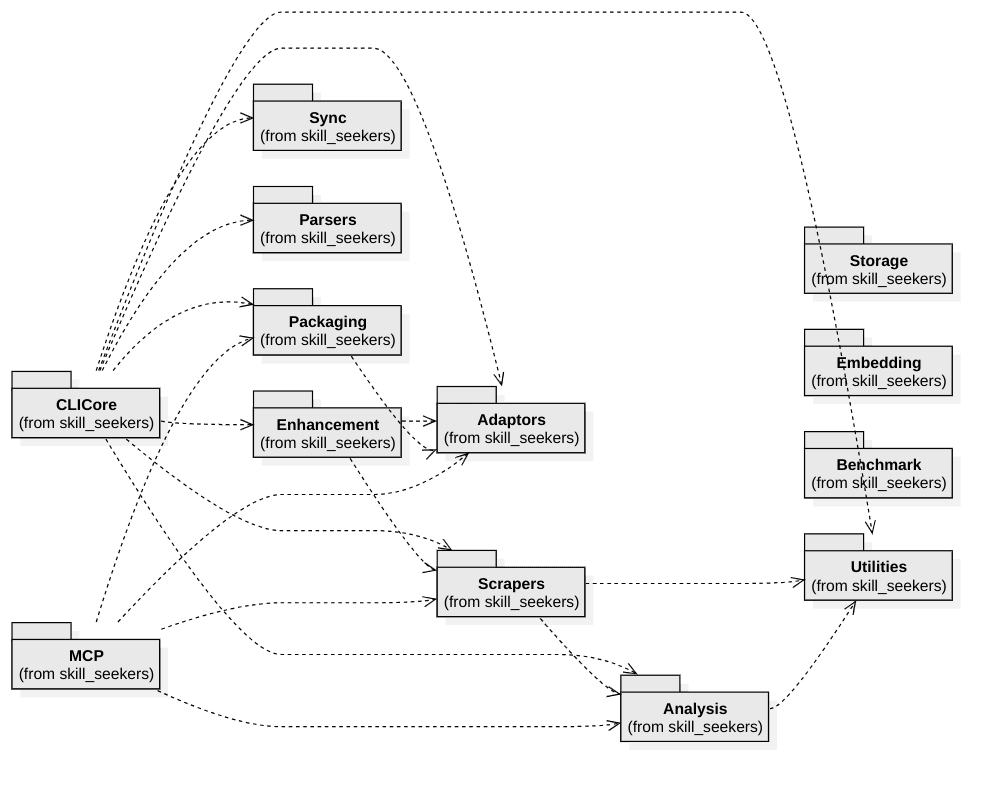
图:项目包结构总览 —— CLI 核心、爬虫、适配器、分析、增强、打包、MCP、同步八大模块

图:18 种源类型爬虫共享同一构建层,新增来源只需实现统一接口

图:MCP 服务端提供 40 个工具,支持 stdio 与 HTTP 双传输,Agent 可自主调用完成全流程
