
SoftCoT
xuyige/SoftCoT加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你是否有这样的困惑:大模型做数学推理时,传统的思维链(Chain-of-Thought)需要生成一段段文字作为"中间思考步骤",但这既慢又浪费显存——毕竟文字解码是逐 token 的,生成一段推理文本可能要好几秒。有没有办法让模型跳过文字,直接在内部"思考"?
这就是 SoftCoT 要解决的核心问题。
SoftCoT 由上海人工智能实验室(或其他高校联合)的研究团队提出,2025 年 3 月发布预印本,2025 年 5 月被 ACL 2025 主会正式录用。同期还推出了升级版 SoftCoT++,探索测试时规模化(Test-Time Scaling)方向。两篇论文分别发表在 arXiv:2502.12134 和 arXiv:2505.11484。
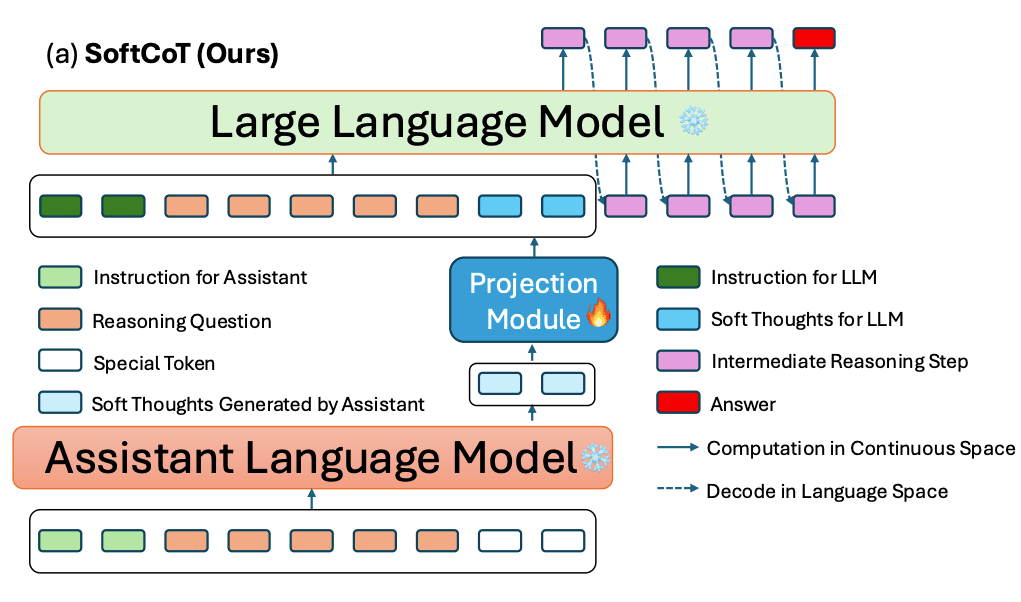
SoftCoT 核心思想:用小型辅助模型生成"软思维",通过投影层注入大模型
在 GSM8K(小学数学题)、StrategyQA(策略推理)等 benchmark 上,链式思维提示(CoT Prompting)能显著提升准确率。但传统 CoT 本质上是文字解码——模型需要逐 token 生成推理步骤,这对长推理链来说计算开销巨大。
类比一下:就像你在解题时,先把思考写在草稿纸上,再把答案抄到试卷——草稿纸的过程就是 CoT,而 SoftCoT 想做的是让模型直接在脑子里完成思考,不写出草稿。
SoftCoT 引入了"软思维"(Soft Thought)的概念,核心分为三步:
用一个轻量级的小模型(如 Llama-3.2-1B-Instruct)作为"辅助模型",让它生成中间推理步骤的连续表征(embedding),而不是文字 token。这些连续向量就是"软思维"。
这些软思维向量来自小模型的 embedding 空间,需要映射到大模型(Llama-3.1-8B-Instruct / Qwen2.5-7B-Instruct 等)的 embedding 空间。SoftCoT 设计了一个**投影层(Projection Layer)**来完成这件事,训练时仅微调投影层参数。
通过投影层,软思维直接作为大模型的隐藏状态注入,不仅保留了推理能力,还避免了微调过程中丢失预训练知识。
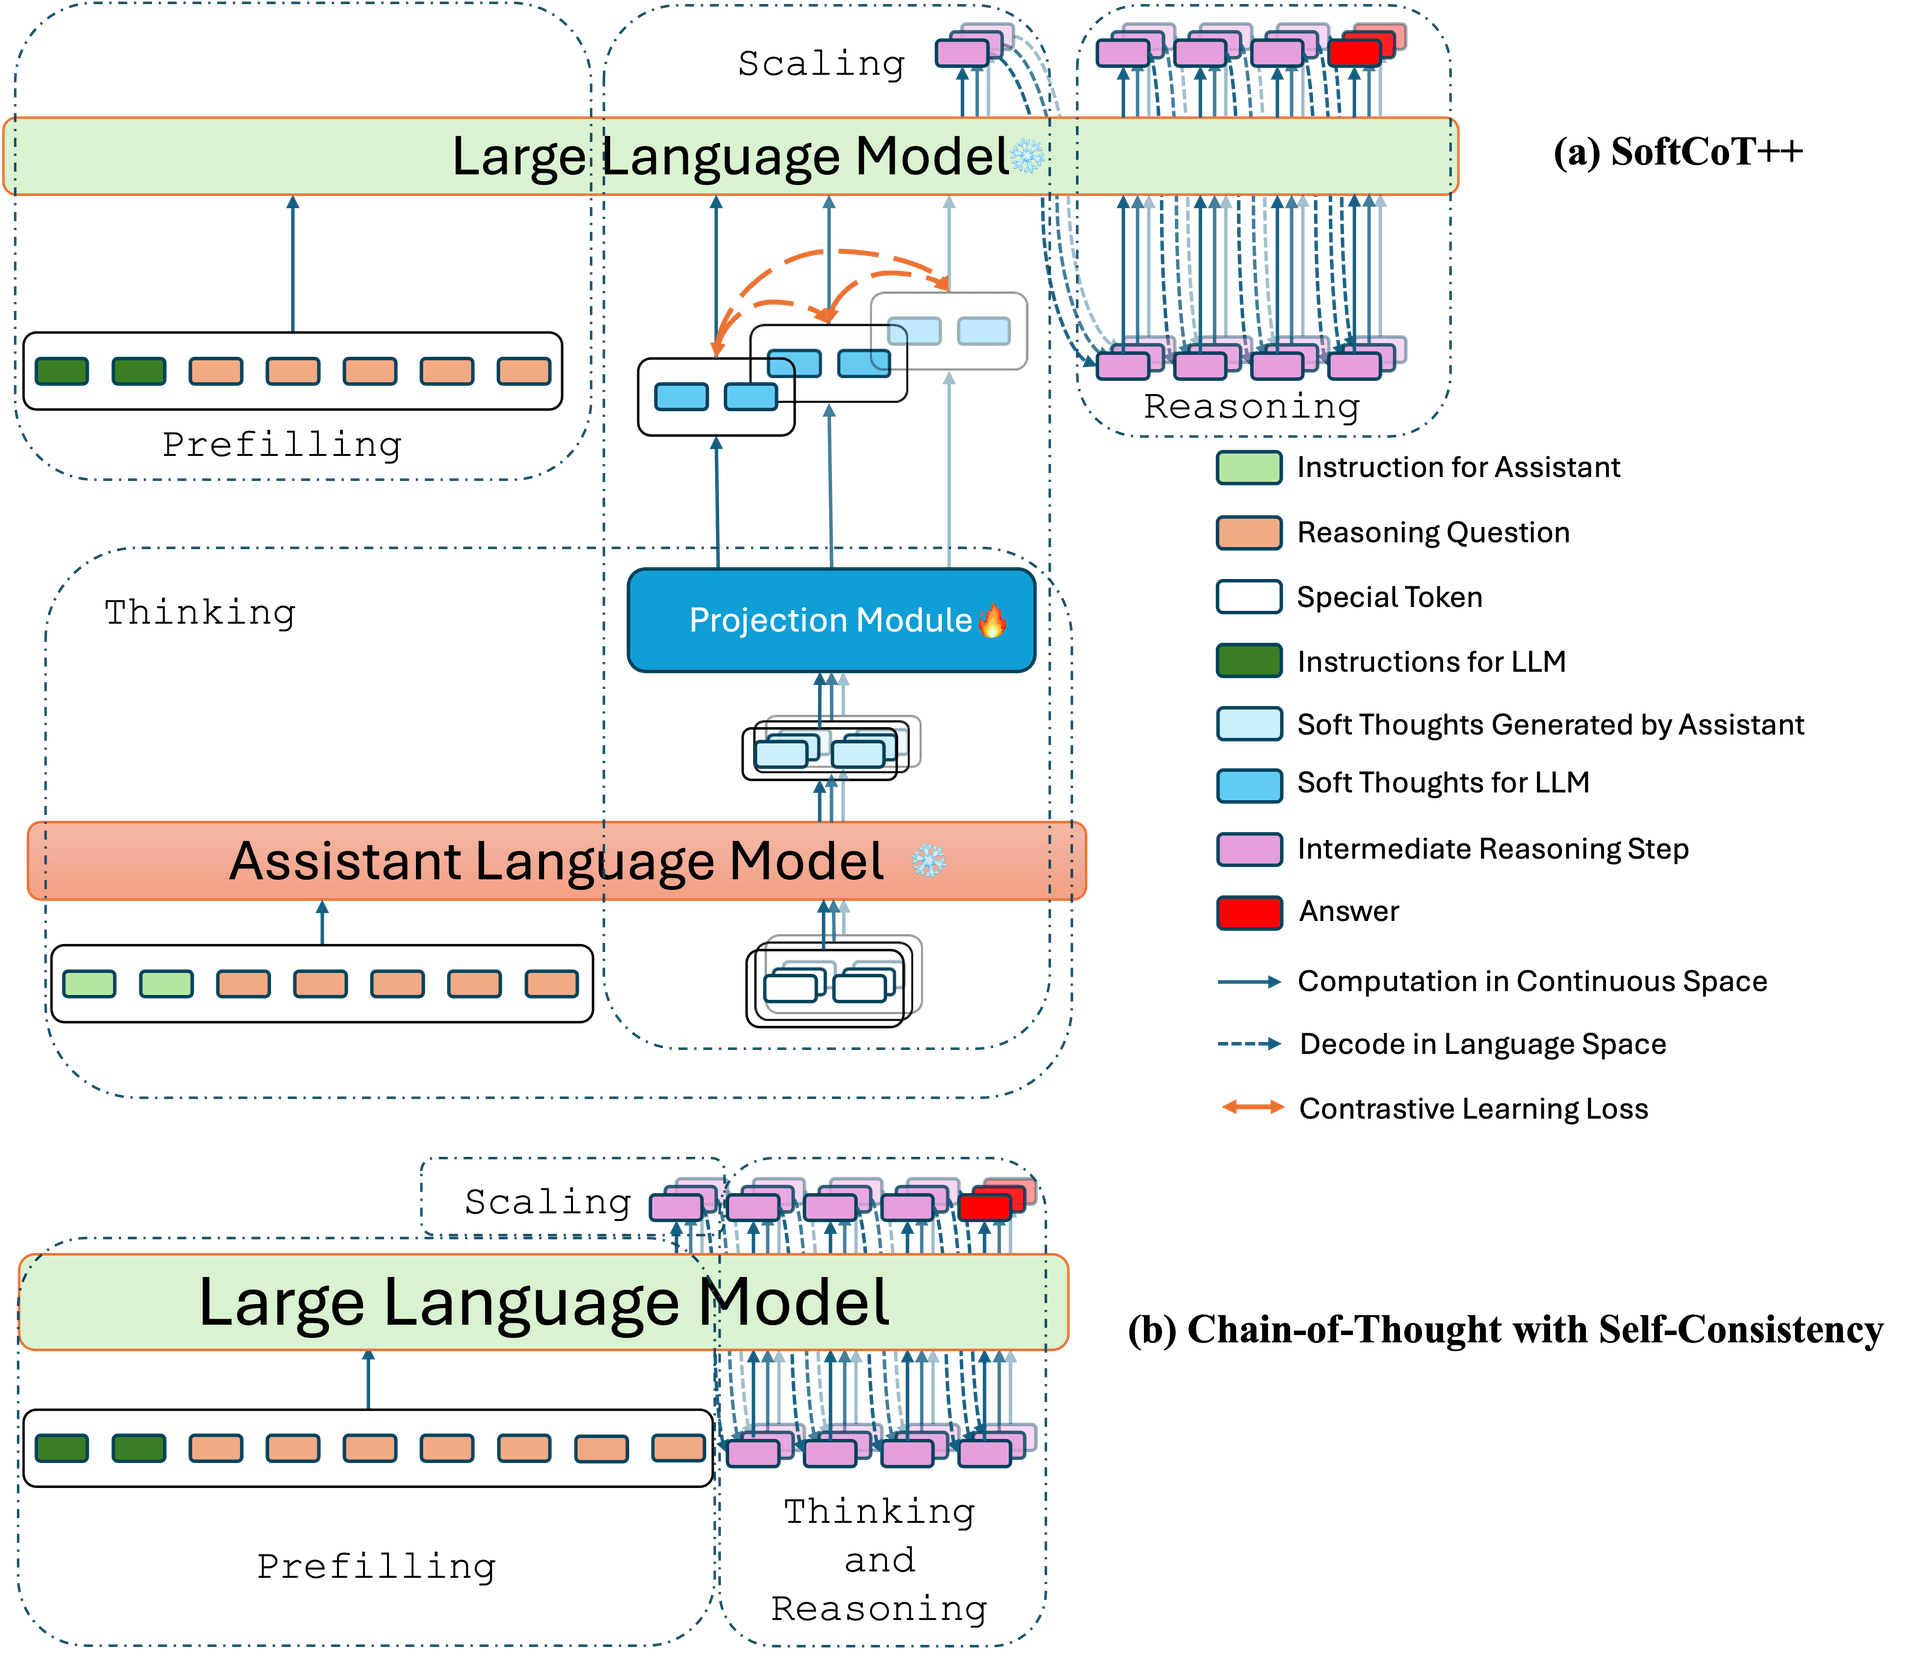
SoftCoT++:通过多个初始 token 扰动实现连续空间中的多样化思维
传统离散解码可以通过多次采样探索不同推理路径,但连续表征对于相同输入是固定的,无法多样化。SoftCoT++ 做了两件事:
简单说:SoftCoT 解决了"连续空间能不能推理"的问题,SoftCoT++ 解决了"连续空间如何做推理规模化"的问题。
核心文件结构:
xuyige/SoftCoT/
├── train_softcot.py          # SoftCoT 训练脚本
├── train_softcotpp.py       # SoftCoT++ 训练脚本
├── evaluate_softcot.py       # SoftCoT 评测脚本
├── evaluate_softcotpp.py     # SoftCoT++ 评测脚本
├── llm_model.py              # 核心模型类(投影层 + 双模型加载)
├── data_loader.py            # 多数据集加载器
├── utils.py                  # 预处理工具与数据整理
├── data/gsm8k/               # GSM8K 格式数据
└── images/                   # 架构图
技术栈:
| 组件 | 技术选型 |
|---|---|
| 深度学习框架 | PyTorch (bfloat16) |
| 模型库 | Hugging Face Transformers 4.44+ |
| 微调方法 | LoRA (via peft) |
| NLP 工具 | fastNLP 0.7.0 |
| 数据格式 | GSM8K 风格、StrategyQA、ASDiv-Aug、AQuA |
投影层核心代码逻辑(llm_model.py):
# 投影层:从小模型 hidden_size 映射到大模型 hidden_size
self.projection = nn.Linear(
    self.assistant_model.config.hidden_size,
    self.base_model.config.hidden_size,
    dtype=torch.bfloat16
)
训练时,辅助模型生成软思维 → 投影层映射 → 注入大模型的隐藏层作为额外 token。整个过程不需要修改大模型本身的权重,仅训练投影层参数。
pip install fastNLP==0.7.0 torch==2.4.1 transformers==4.44.2
# SoftCoT++ 额外需要: torch==2.7.0 transformers==4.51.0
CUDA_VISIBLE_DEVICES=0 python train_softcot.py \
    --large_model_id meta-llama/Llama-3.1-8B-Instruct \
    --small_model_id meta-llama/Llama-3.2-1B-Instruct \
    --output_name my_experiment \
    --batch_size 4 \
    --task_name gsm8k \
    --num_thought_tokens 32 \
    --n_epochs 10
bash run_batch_softcot.sh \
    --base_model_id meta-llama/Llama-3.1-8B-Instruct \
    --assistant_model_id meta-llama/Llama-3.2-1B-Instruct \
    --params_file_name ./ckpt/my_experiment/projection.bin \
    --num_thought_tokens 4 \
    --num_return_sequences 1 \
    --task_name gsm8k
关键参数解读:
num_thought_tokens:训练时设为 32(更多空间学习软思维),推理时降为 4(效率优先)num_scaling_times(SoftCoT++):缩放次数,即在推理时扰动生成多少条不同的思维路径GPU 必备。软思维生成和投影层注入都需要在 bfloat16 精度下运行,8B 大模型本身约需 16GB+ 显存,训练时至少需要单卡 24GB(如 A100 40G)。不支持 CPU 推理。
token='your-huggingface-token',需要自备 HuggingFace 账号和访问权限才能加载模型SoftCoT 代表了 LLM 推理优化的一个新兴方向——连续空间推理(Continuous-Space Reasoning)。它避开了文字解码的计算瓶颈,通过软思维在模型的 embedding 空间中直接完成推理,有望在未来结合自定义硬件实现更高效的推理加速。
从学术影响力看,ACL 2025 录用证明了该方向的认可度,而 SoftCoT++ 的测试时规模化探索,则与当前"推理时 scaling"(如 OpenAI o1/o3 系列)的研究热潮高度呼应。
相关资源:
