
shisei
wquguru/shisei加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你用 Nano Banana 或 ChatGPT 生成一张人物插画,反复失败——不是脸画错,而是姿势拧巴:手臂穿模、腰身断裂、重心飘忽、视角根本对不上。每一次重抽都是一次赌博。
问题出在文本提示词上。文字能描述「一个人站着」,却极难精确描述「右手撑髋、左腿微屈、重心落在右脚、上半身轻微前倾 15 度、镜头取四分之三侧上方」。摄影有灯光师和场记板,绘画只有一句 prompt。
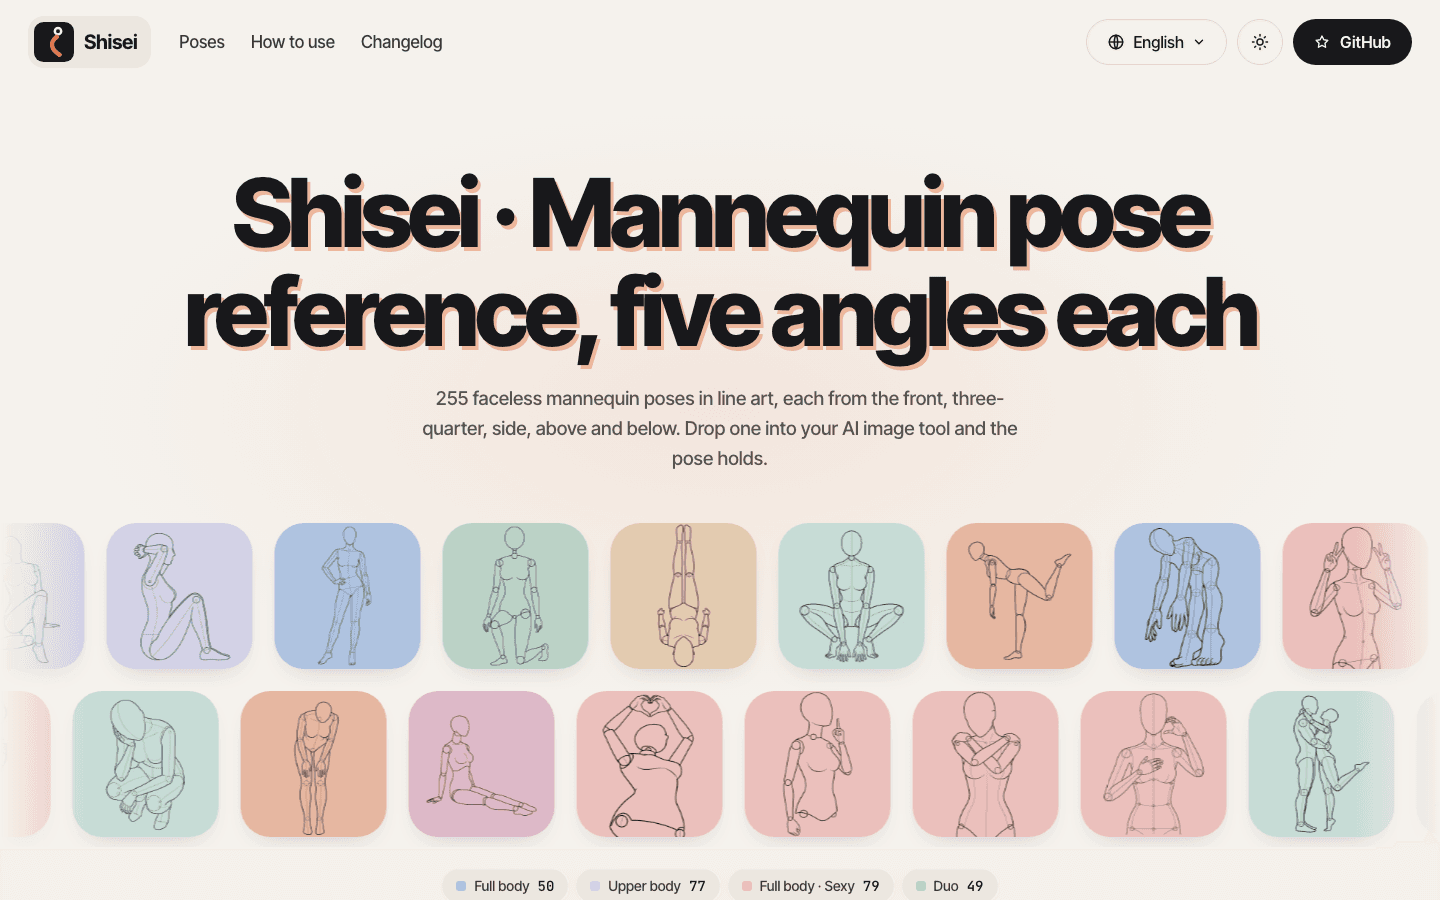
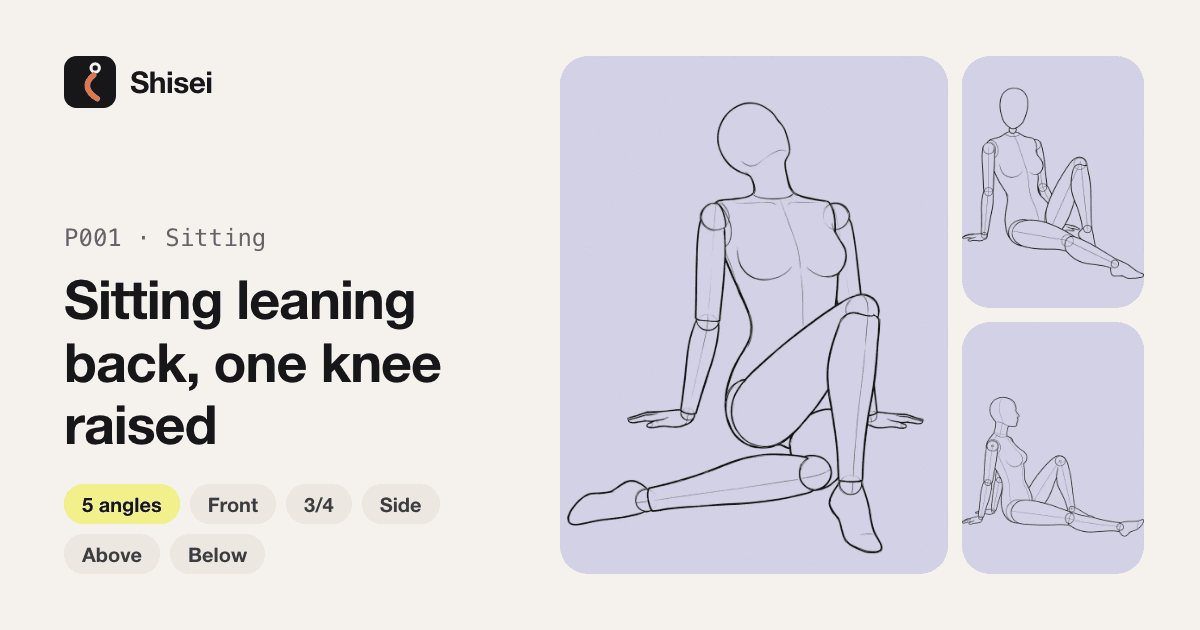
Shisei 要补的就是这块空缺。它把 280 组人体姿势,逐一画成无脸素体线稿,每组再从正面、四分之三、侧面、俯视、仰视五个机位各画一张。你挑一个姿势,把想要机位的那张线稿丢进图像工具当参考图,模型照着这个骨架去填衣服、脸和背景。
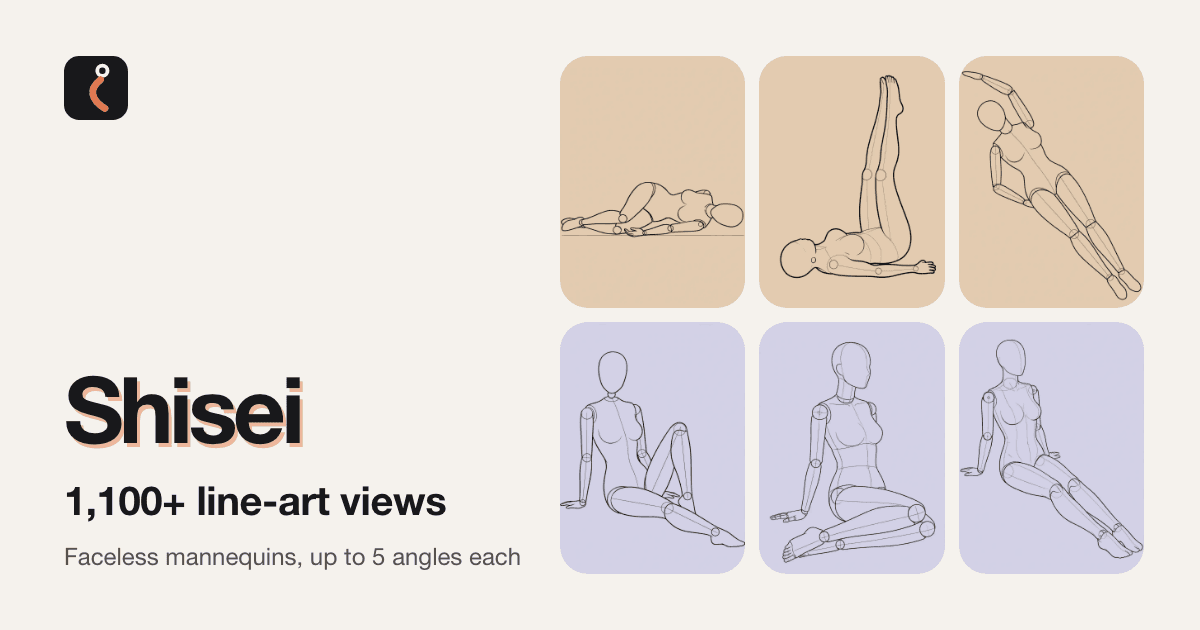
Shisei(姿勢,日语「姿势」)是 2026 年 10 月刚起步的个人项目,作者 wquguru。仓库不长,但工程纪律异常严格:README 有日文、中文、英文、韩文四语版本,AGENTS.md 是专门给 AI 代理看的施工规范,docs/qc/ 下有七份质检提示词,data/qc.json 逐格记录 1133 张线稿 + 89 张照片渲染的过检状态与淘汰原因。
姿势清单本身借鉴了日本创作者 ギア(@giaaibusi)的公开姿势目录 ai-pose-gallery——只借清单、编号、分类与四语名称,所有图像 100% 自制,NOTICE 里明确说明「清单是被署名引用,不是被授权」。
四个系列:std 全身标准 71 套、upper 上半身 80 套、sexy 全身性感 80 套、duo 双人 49 套。后两个系列标记为 suggestive(暗示级),画廊里默认打码、不进精选轮播、不进分享卡、不进 sitemap,点开或打开开关才显示。
类比一下:去影楼拍写真,摄影师会给你摆姿势、指导机位。你在 AI 绘图里缺的就是这个「摆姿势的人」。Shisei 就是那本姿势目录,只不过它不是纸质的,而是被 AI 生成成了素体线稿——没有脸、没有头发、没有衣服,只有骨架和轮廓。这样做的用意很实在:线稿只提供姿态结构,脸、服饰、背景全部留给你的提示词去发挥,不会有「撞脸」或「撞衫」的干扰。
更妙的是五机位设计。同一姿势的正面、侧面、俯视、仰视各一张,相当于给模型提供了这个姿势的「三维坐标」,多图喂进去,人物在不同镜头间的姿态一致性会显著变好——这正是当前图像模型最弱的一环。
1. 五机位一致性姿势库
data/catalog.json 是唯一真相源,288 条记录,每条含 id、系列、评级、分类与四语名称、英文姿势描述(直接可当 prompt 用)、五个机位的文件名、缺失原因标记。缺失的格子宁可留空,也绝不用镜像、翻转或低质量图去凑数——这是 AGENTS.md 里写死的红线。
2. 逐格质检流程
每张入库的图都必须在 qc.json 里有 status: pass。质检由 Claude Sonnet 通过 .claude/agents/qc-reviewer.md 这个 agent 提示词自动执行,按 review_sheets.py 生成的拼版图逐格看。淘汰条件明确到近乎苛刻:乳头痕迹、出现脸或头发、带衣物、带背景、解剖结构崩坏、机位不对、看起来像未成年人、画的姿势和名字对不上——任一命中即淘汰并记录原因。有 43 套因可用机位太少或画错了姿势,被另一个生成器整套重画(catalog 里标 source: digi),绝不新旧机位混用。
3. 三档分辨率 + Release 打包
仓库内含 w300(约 7KB)/ w600(约 17KB)/ w900(约 29KB)三档 WebP,共约 63MB;全尺寸原图和成品 zip 放在 Release 页,分系列打包并附 .sha256 校验。推荐包 34.1MB 含 280 套 1222 张图。
4. 零依赖静态画廊
web/ 是一套纯静态前端(原生 JS,零框架、零 npm 依赖),带系列分页、分类筛选、机位筛选、线稿/照片切换、灯箱大图、键盘与手势翻页、深链接(#P001-diag)、四语 UI、深色主题。线上已部署在 Cloudflare Pages:shisei.indaloop.app。
5. 双授权,商用无忧 图像与 data/ 目录走 CC0 1.0(公有领域,商用、修改、再分发均无需署名);代码与文档走 Apache-2.0。姿态清单来自第三方目录,既非 CC0 也非 Apache,只署名不授权,作者在 NOTICE 里主动披露了这块边界——这种诚实度在开源图库里少见。
最快路径(零部署):直接去 shisei.indaloop.app/en/ 浏览,点开姿势 → 右键复制图片 → 拖进你的图像工具。
命令行路径:
git clone https://github.com/wquguru/shisei.git
cd shisei
python3 tools/build_site.py --link-images   # 构建静态站点
python3 -m http.server 8000 -d site          # 本地预览
无第三方 Python 依赖,Python 3.12 即可。tools/verify.py 会校验 catalog、qc.json 与实际图片三者是否一致,CI 每次 push 都会跑它,外加 build_site.py 构建和 node --check 语法检查。
没有 Dockerfile,没有 docker-compose,因为它本质不是要跑起来的服务——一份静态站 + 一堆下载链接,Python 内置 http.server 就够。
内容分级是绕不开的话题。 sexy 与 duo 两个系列共 129 套成人向暗示姿势,即便人偶无脸、无线索,作者仍在 README 顶部加了醒目提示。团队在企业环境引入时必须先过一遍合规,这是不争议的事实。
双人生成成功率最低。 四个系列里 duo 被拒率最高(275 格只成 252 格),双人接触 + 正面机位几乎必被拒。D022 整套未成。四肢细节错误(手指数量、关节方向)在这类素体线稿里依旧存在,质检只能拦住明显错误,拦不住全部。
清单授权存在瑕疵。 姿态清单既非 CC0 也非 Apache,属于「署名引用」,严格说是灰色地带。作者选择主动披露而非掩盖,但使用者若要大规模商用,仍应自行评估这层风险。
单人项目、Single Point of Failure。 全仓库 86 次提交、1 位贡献者(wquguru),核心生成流程高度依赖作者个人的 ComfyUI/Muse 工作流与外部素材包(文档里出现了 ~/Downloads/pose-gallery-digi66 这类本机路径依赖)。项目一旦停更,缺口补齐就没有第二条路径。
尚存未竟事项。 P038 与 P052 的图仍画的是另一个姿势,只能继续隐藏;P062 的仰视机位尝试 9 次全部失败(文字直生 3 次被拒、线稿转机位 4 次全画翻转、照片转线稿被拒),至今空缺。
Shisei 代表的趋势是:AI 生成内容正在反哺 AI 生成的输入。第一代图像模型的瓶颈是「画得准」,第二代模型的瓶颈变成了「指令听不听得懂」——于是有人开始为提示词工程准备结构化的素材层。
这个思路可以外推到几乎所有生成式场景:为文字模型准备风格样张、为语音模型准备发音词典、为视频模型准备运镜参考。姿势库只是最容易验证的那一格,因为它能一眼看出好坏。
从工程角度看,这套「catalog 唯一真相源 + 逐格质检状态机 + verify.py 一致性校验 + AI agent 自动执行质检 + AI agent 施工规范(AGENTS.md)」的组合,是把内容生产的质量控制工程化的一个漂亮样本。尤其是让 agent 读图判图这一环——很多人以为是噱头,但 qc-reviewer.md 里「不许凭文件名判断、不许抽样、逐格打开看」这几条约束,写得像一份给实习生的质检手册。
仓库目前 175 star、46 fork,v0.3.0,发布于 2026-10-29,仍在快速成长期。对做 AI 图像工作流的人,这是一个几乎零成本、即插即用的姿势层;对做内容工程的人,它提供了一套可复用的「生成 → 质检 → 一致性校验 → 打包发布」流水线模板。
不适合:需要真人照片级精度的写实项目(线稿只给结构不给质感),以及期望项目有长期维护承诺的团队(单人项目)。
