
graphster
wisecubeai/graphster加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一位图书馆员,面对堆满数十万份医学文献的库房,每份文档动辄上百页,其中散布着疾病名称、药物成分、患者病例等信息。传统做法是靠人工摘录建卡片——这正是知识图谱领域过去几十年的真实写照:靠专家手工标注,成本高、速度慢、覆盖窄。
Graphster 试图解决这个问题。它的核心理念是:用机器代替人工,把文档和数据库"倒进"一个可查询的知识网络里。这不只是简单的文本提取,而是端到端的 pipeline——从原始语料出发,经过实体识别、关系抽取、实体链接(Entity Linking)、知识融合(Fusion)等多个阶段,最终产出可直接用 SPARQL 查询的 RDF 知识图谱。
Graphster 由 Wisecube AI 开发维护,这是一家专注医疗健康 AI 的初创公司,其技术栈天然要求处理大规模生物医学文献——这解释了为什么 Graphster 选择 Apache Spark 作为底层计算框架。
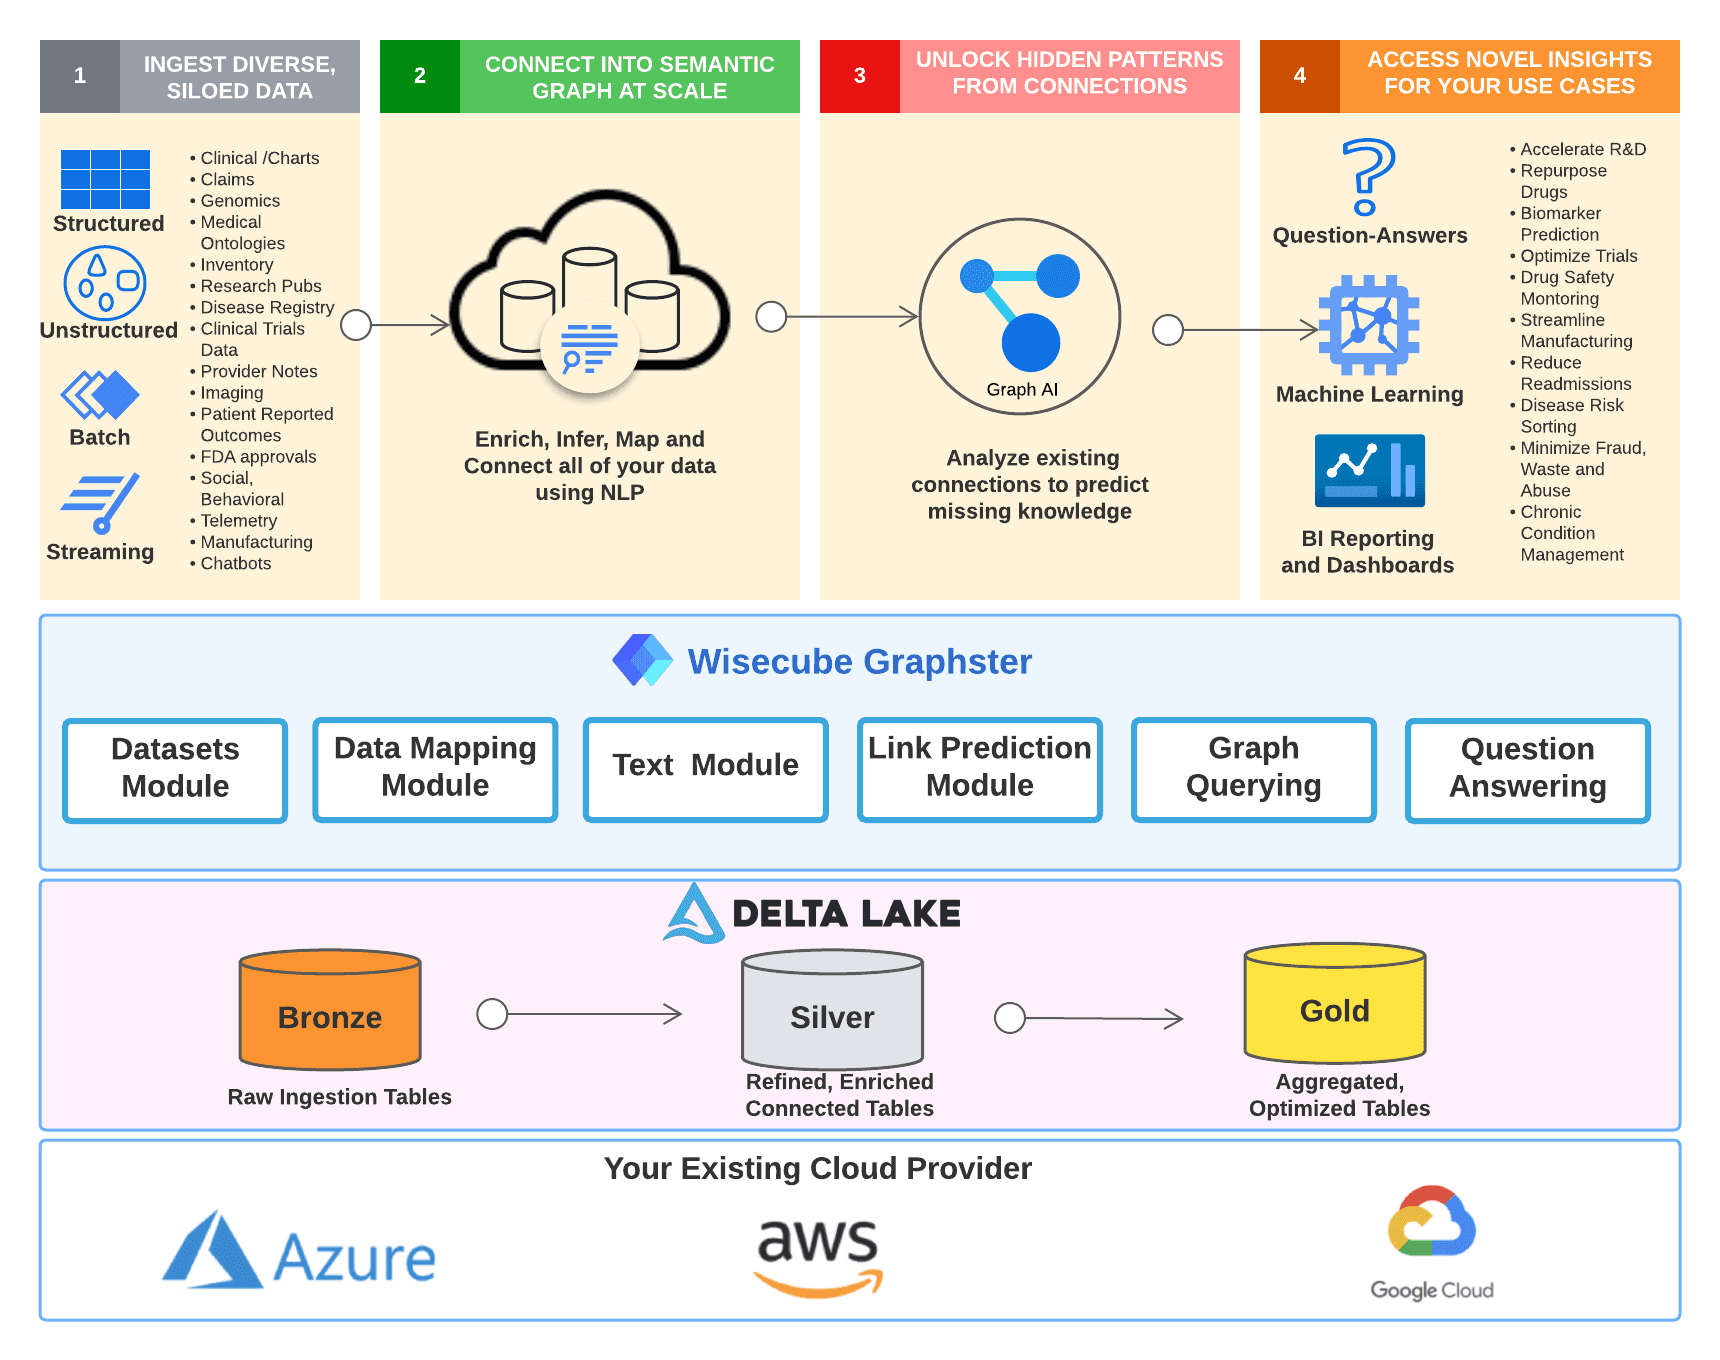
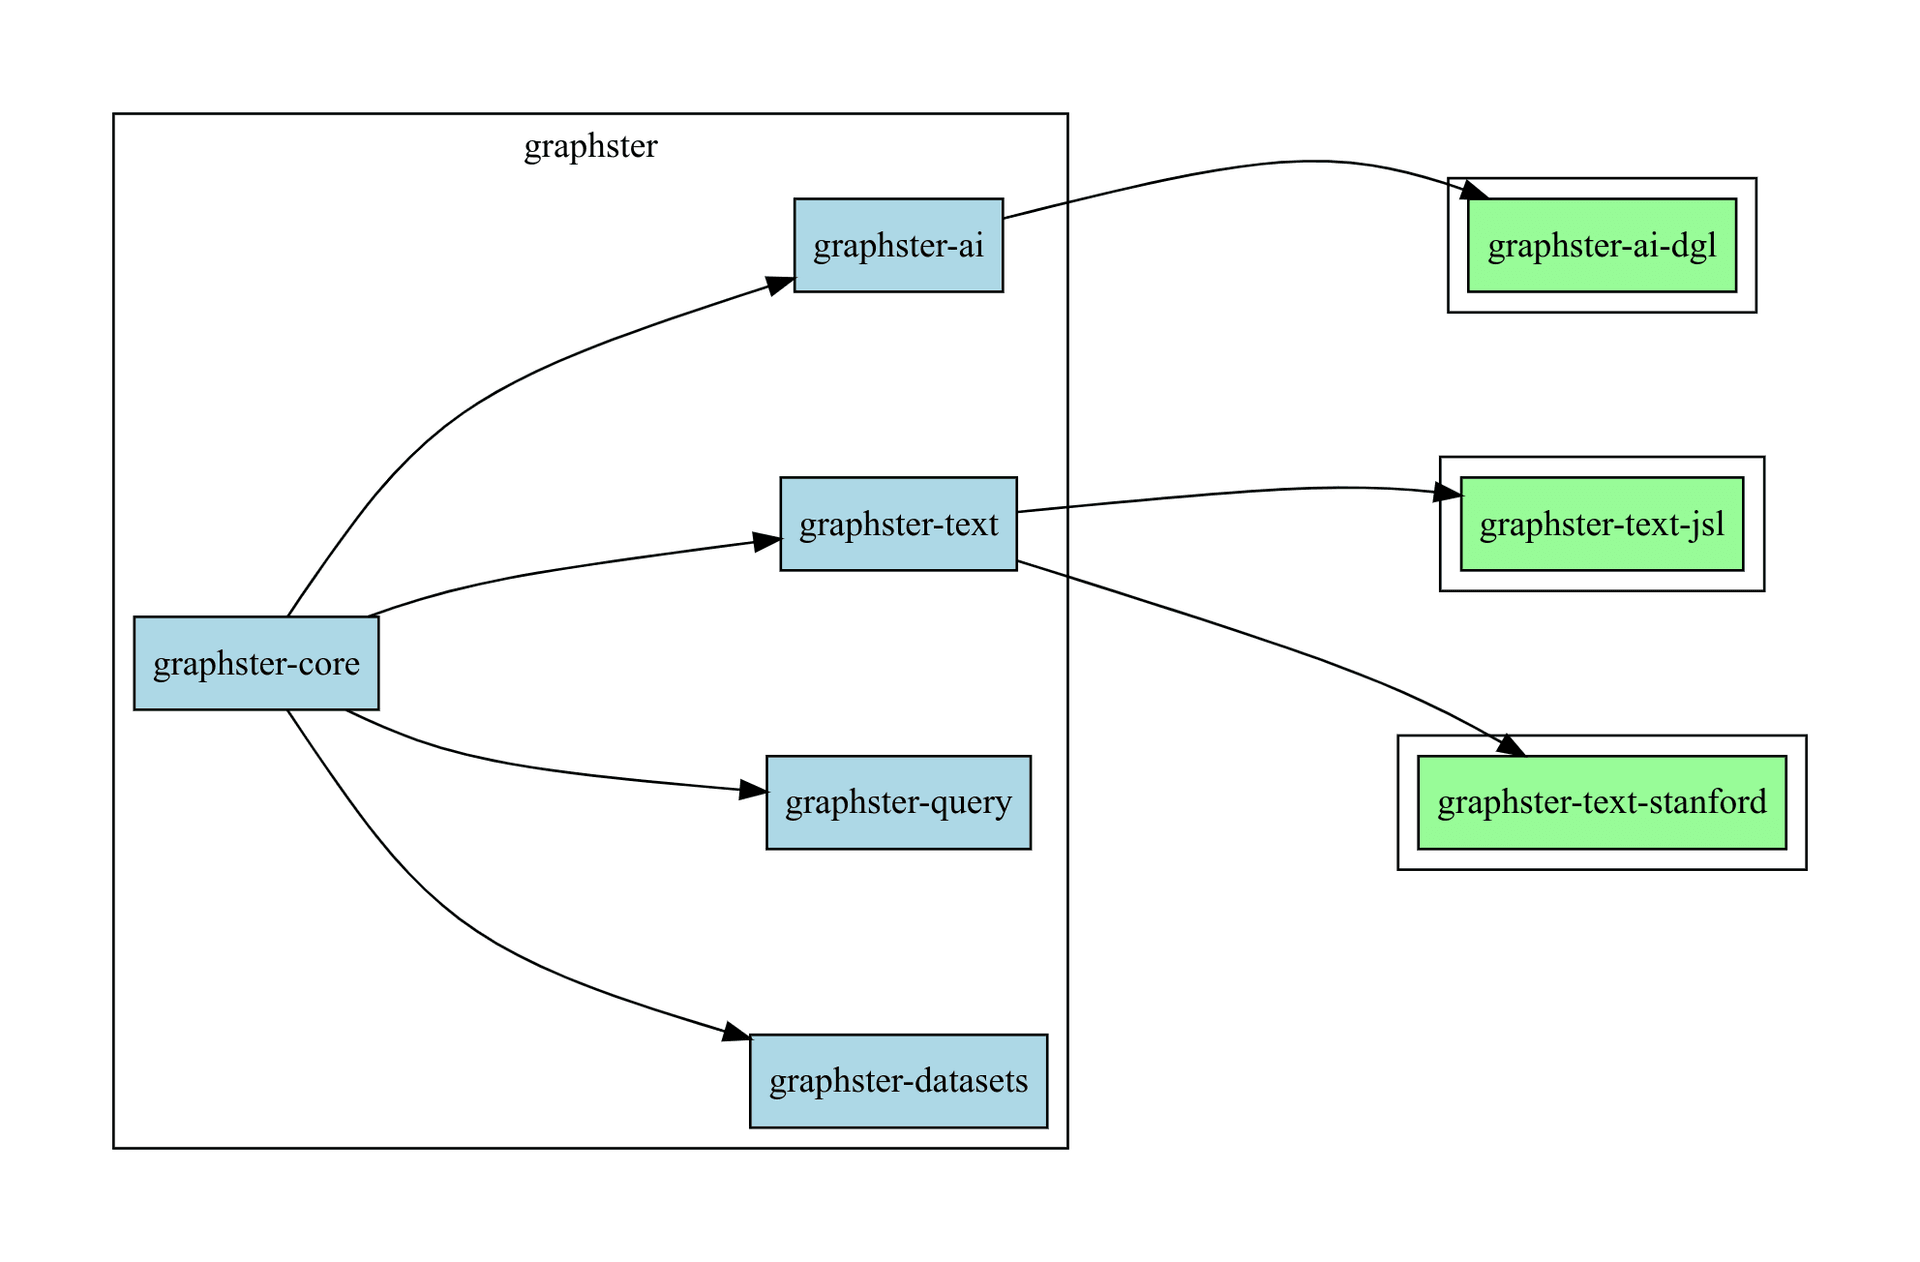
Graphster 的整体架构可以用"分进合击"来概括。整体分为 5 个主要模块:
| 模块 | 功能 | 核心依赖 |
|---|---|---|
graphster-core | 图配置系统、数据 IO、通用工具 | Scala 2.12, Spark 3.2.1 |
graphster-text | 文本处理、NLP 特征提取 | Spark NLP (John Snow Labs) |
graphster-query | SPARQL 查询引擎 | Apache Jena ARQ 3.17 |
graphster-ai | 图神经网络嵌入、机器学习增强 | Spark MLlib |
graphster-datasets | 内置医学数据集(ClinicalTrials, MeSH) | — |
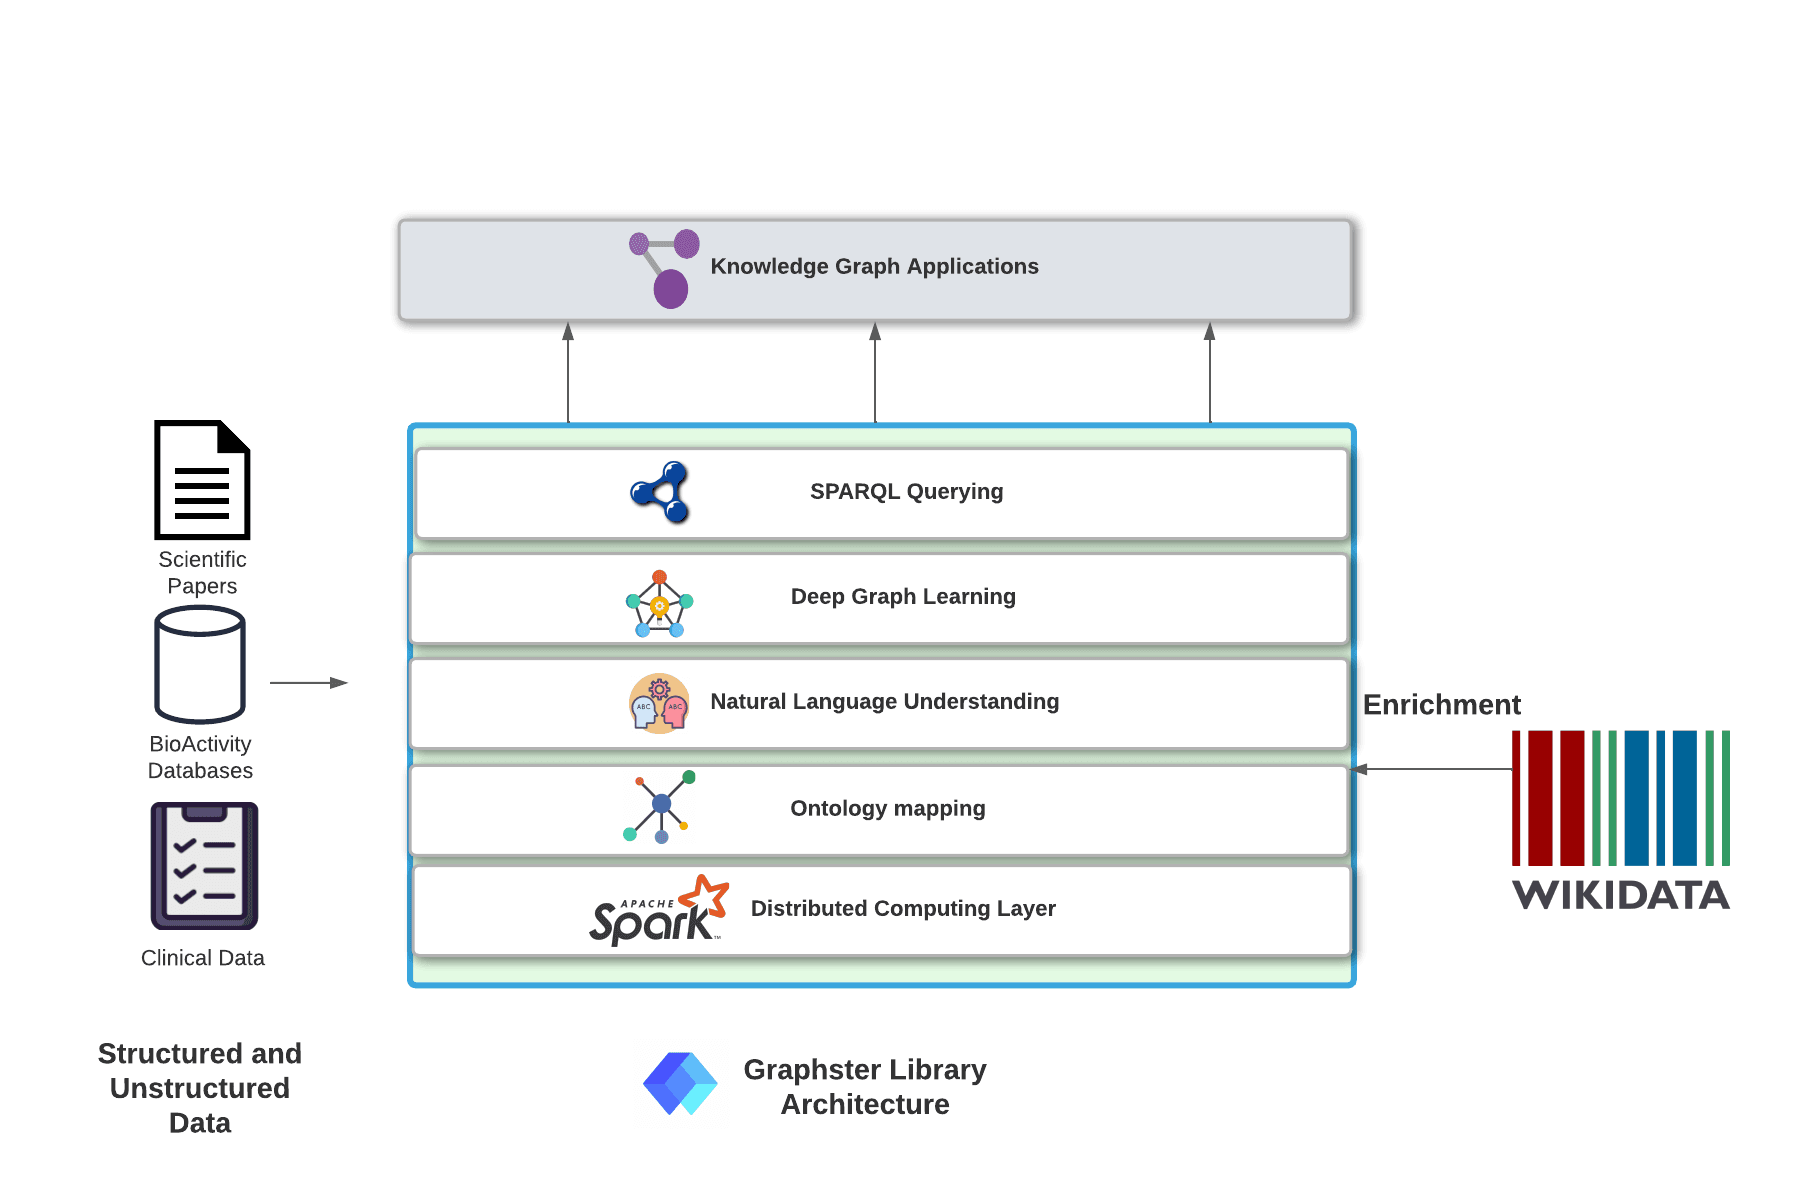
系统接受三类数据输入:图数据(RDF/OWL)、结构化数据(CSV、数据库导出)和非结构化文本(文档语料)。所有数据最终被统一转化为 Orpheus 图配置格式——这是 Graphster 自研的声明式配置 DSL,允许用户用 JSON/YAML 风格的配置描述图结构,而不是写大量 Scala 代码。
值得注意的是,Graphster 并不重复造 NLP 的轮子。它深度集成 Spark NLP(John Snow Labs 出品),借助其预训练模型处理医学文本中的命名实体识别(NER)和关系抽取。这意味着你可以直接使用现成的生物医学 NER 模型(如 ner_drugs, ner_diseases),而不必从头训练。
Graphster 的 datasets 模块内置了对 ClinicalTrials.gov 和 MeSH 词表的原生支持。典型工作流如下:
第一步:配置图结构
// 定义节点类型和属性
val config = GraphConf.fromYAML("clinical-trials-config.yaml")
第二步:从结构化数据提取三元组
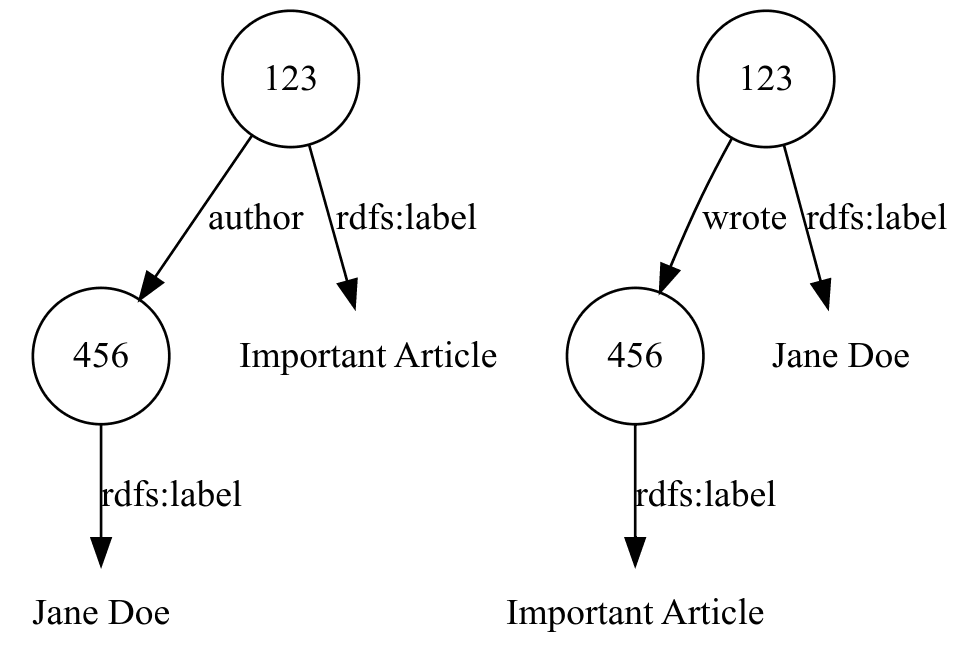
Graphster 可以直接将 CSV 表格的行列映射为 RDF 三元组(主语-谓语-宾语)。例如,CSV 中每一行代表一项临床试验,study_id 列作为主语 URI,intervention_name 列作为宾语字面量,通过预定义的映射规则自动生成 SPARQL 可查询的三元组。
第三步:从非结构化文本中提取关系
对于文本字段(如 brief_summary),Graphster 调用 Spark NLP 管道执行关系抽取,将疾病-药物-不良反应等医学关系提取为图谱边。
第四步:链接到 Wikidata Graphster 内置实体链接能力,可以将文档中识别出的人名、地点、疾病名与 Wikidata 的 millions of entities 进行匹配,丰富图谱语义。
第五步:SPARQL 查询 构建完成后,用户可以直接用标准 SPARQL 1.1 查询语言检索图谱,例如:
SELECT ?drug ?disease WHERE {
  ?trial schema:drug ?drug .
  ?trial schema:treats ?disease .
  FILTER(?disease = wd:Q874)
}
Graphster 选择 Spark 而非传统单机 Python NLP 管道,有三个关键原因:
数据规模:ClinicalTrials.gov 完整数据集超过 50 万条记录,每条记录包含多个长文本字段。Spark 的分布式 DataFrame 操作使得这类数据处理可以在分钟级完成,而非数小时。
多模态统一:同一 pipeline 中既有 CSV 的结构化 JOIN 操作,也有 NLP 的分布式文本处理,还有 RDF 图的图算法。Spark 作为统一执行引擎,避免了在不同系统间搬运数据的开销。
与现有 BI 生态集成:很多医疗机构的 BI 系统(如 Tableau、Power BI)已经支持 Spark SQL 接口,Graphster 产出的图谱可以直接被这些工具消费。
但这也带来了上手门槛:需要理解 Spark 的分布式执行模型,包括 partition、shuffle、broadcast 等概念。单节点用户如果没有 Spark 经验,可能需要一段适应期。
Graphster 的配置系统(Orpheus Configuration)是其最大亮点之一——用户几乎不需要写 Scala 代码,只要掌握 YAML/JSON 配置就能构建完整 pipeline。
但实际体验中,有几个需要注意的点:
优点:
局限:
graphster-ai 模块几乎没有文档Graphster 代表了一个务实的技术路线:不追求 AGI,而是用确定性管道解决知识图谱构建的人工瓶颈。在医疗、法律、金融等需要高精度知识图谱的领域,这种"机器辅助+人工校验"的模式仍有很强生命力。
不过也需要指出:Graphster 的 stars 仅 107,说明社区活跃度有限。知识图谱领域近年来 Transformer-based 方法(如 SPERT、LinkBert)快速发展,相比 Graphster 的规则+NLP 管道,大模型方案在开放域实体识别和关系抽取上有明显优势。Wisecube AI 的重心可能也在转向 LLM-based 方法。
总结评分:
