
call.md
video-db/call.md加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:你正在和一位重要客户进行销售电话,对方随口提了一句"能给我发一下企业版的价格吗?"——你的大脑飞速运转,试图回忆定价策略,同时还要维持对话的流畅。这时候,你最需要的是什么?是一个在你说话时就在后台默默工作的 AI 助手,提前把答案准备好,甚至在你还没反应过来的时候就把结果推送到了屏幕上。
这就是 call.md 正在做的事情。它是一个开源的桌面应用(Electron),核心理念是:把 AI 从"会后整理"的角色,拽到"会议进行中"。在通话还在进行的时候,它就在听、在分析、在给你提供建议——就像给每一次通话配备了一个不知疲倦的副驾驶。
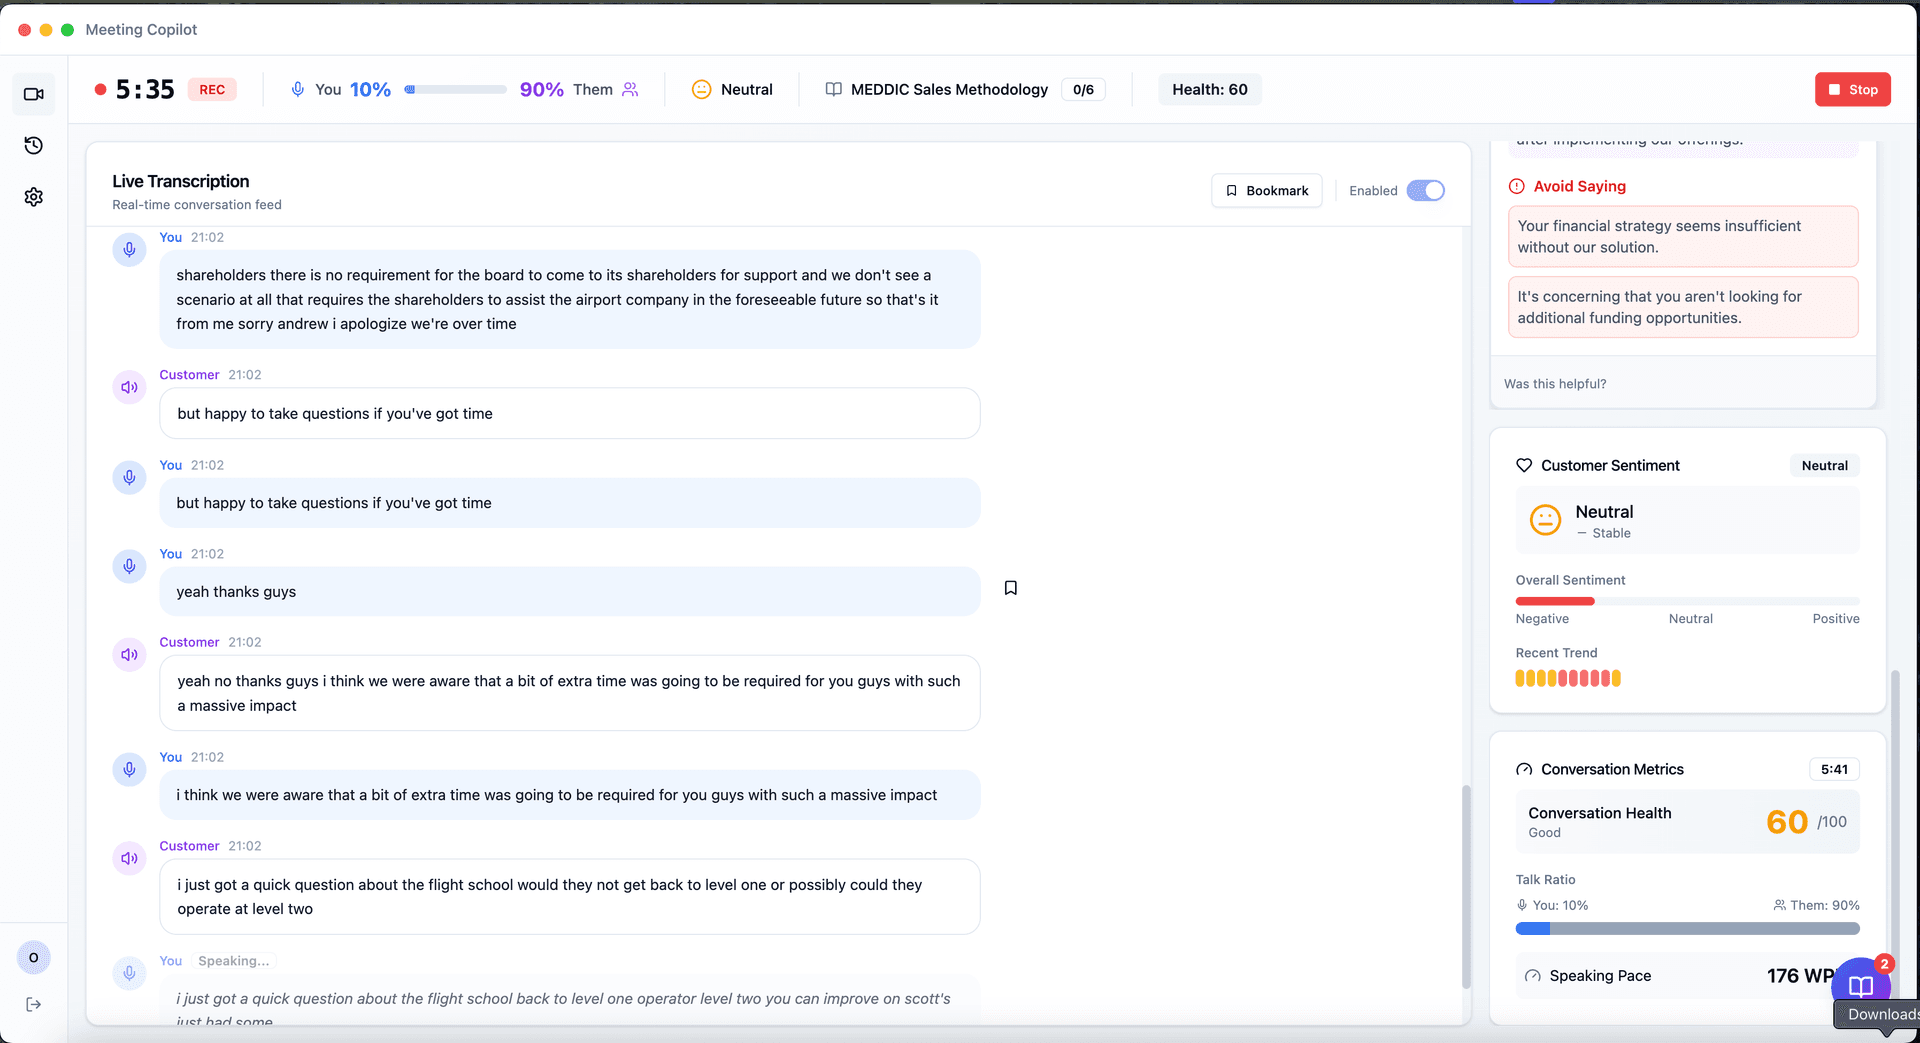
传统的会议 AI 工具——Otter.ai、Fireflies.ai、Google Meet 录音转写——都遵循同一个范式:先录,再转,最后事后分析。这套流程的问题是:洞见来得太晚,你没法在会议进行中用它来改变对话质量。
而 AI Agent 的出现给这个领域打开了一个新的可能性:实时理解 + 实时行动。但大多数 Agent 工具(比如各种聊天机器人)是独立的,不和你的工作流程深度绑定——你需要主动去问它,它才会回答。
call.md 的作者(VideoDB 团队)想做的是:让 AI 和你的会议本身同步运行。你不需要切换窗口,不需要 Alt+Tab,不需要说"等一下我查一下"——AI 在你说话的时候就听到了,你需要的信息会自动出现在屏幕上。
项目在 2026 年 2 月发布于 GitHub,目前约 1400 颗星,聚焦于 AI 会议助手和 Agent 自动化方向。
call.md 的技术架构非常清晰,整个系统围绕实时转录流构建,一旦转录管道打通,所有上层功能都是对这个流的不同处理。
录音层采用 VideoDB Capture SDK,这是一个桌面捕获组件,能够同时采集三路信号:麦克风音频(你的声音)、系统音频(对方的声音)以及屏幕画面。这三路信号通过 WebSocket 实时流式传输到 VideoDB 云端,在云端完成语音转文字(STT),并将转录结果流式返回本地。
双通道分离是关键设计:**"你"(麦克风)**和 **"他们"(系统音频)**的转录结果分开存储。这一步不只是为了归属说话人——它支撑了所有后续的智能分析:对话比率、语速、独白检测、以及 AI 生成建议的质量。没有这个分离,很多智能功能就无从谈起。
实时转录流进入本地后,存在一个 transcriptStore 中,供所有服务并行消费。整个系统的核心循环是:
conversation-metrics.service 计算对话比率、语速(WPM)、提问次数,进行独白检测(超过 45 秒自动触发)intent-detector.service.ts 使用正则表达式扫描转录流,检测信息需求模式(如"价格"、"日程"、"错误代码"),匹配到高置信度模式后,触发 MCP AgentMCP Agent 循环是整个产品最亮眼的部分。当 intent detector 检测到信息需求时,会调用 LLM 从所有已连接的 MCP 服务器中选择合适的工具并填充参数。例如:客户问"企业版定价是多少?" → intent detector 匹配到 pricing 模式 → LLM 选择 CRM MCP 工具并调用 → 结果以内联面板形式显示在通话界面上。整个过程完全自动,无需用户手动操作。
通话结束后,summary-generator 并行生成三部分内容:叙事性概述、按主题分类的关键点列表、以及 3-10 条具体行动项。同时,workflow webhook 支持自动将结果推送到 n8n、Zapier、以及各种 CRM 系统。
call.md 的技术选型非常务实,以本地优先、性能优先为原则:
| 层级 | 技术选型 | 说明 |
|---|---|---|
| 桌面框架 | Electron 34 | 负责窗口、系统托盘、本地协议 |
| UI 框架 | React 19 + TypeScript 5.8 | 前端界面 |
| 状态管理 | Zustand | 渲染进程轻量状态 |
| 进程通信 | tRPC 11 | 主进程 ↔ 渲染进程类型安全 RPC |
| HTTP 服务 | Hono + @hono/node-server | 本地 HTTP 服务 |
| 数据库 | better-sqlite3 + Drizzle ORM | 本地 SQLite,数据本地优先 |
| 录音/转录 | @videodb/recorder (CaptureClient) | 原生二进制屏幕/音频捕获 |
| AI Agent | OpenAI SDK | 所有 AI 推理(Live Assist、Nudge、Summary) |
| 工具集成 | @modelcontextprotocol/sdk 1.0.0 | MCP 协议,支持 stdio/HTTP 两种传输 |
| 日志 | Pino | 结构化日志 |
代码结构方面,src/main/ 下按服务职责划分:
server/ — tRPC 服务端services/ — 核心业务服务:live-assist.service.ts(实时建议)、conversation-metrics.service.ts(对话指标)、nudge-engine.service.ts(教练提示)、mcp-inference.service.ts(MCP 推理)、mcp/(连接编排、intent 检测、工具聚合、结果处理)、llm.service.ts(OpenAI 封装)、videodb.service.ts(VideoDB API)db/ — Drizzle ORM schema 定义ipc/ — Electron IPC 通道定义src/renderer/ 为 React UI,订阅主进程事件流并渲染界面。src/shared/ 存放共享的常量、Schema 和类型定义。
代码质量方面,TypeScript 覆盖全面,tRPC 提供了端到端的类型安全(从服务端到客户端),Drizzle ORM 的 schema 即代码文档。但测试覆盖率未在 README 中公开,文档质量较好(labs.videodb.io 有完整的构建故事)。
安装非常简单,一行命令搞定:
curl -fsSL https://artifacts.videodb.io/call.md/install | bash
安装完成后,启动应用、输入 VideoDB API Key(免费额度可用)、授予麦克风和屏幕录制权限即可开始。开发者模式支持 npm install && npm run dev。
核心使用流程:
MCP 服务器连接也非常简单:在 Settings → MCP Servers 添加,支持 stdio(本地工具)和 HTTP(远程服务)两种模式。内置 intent detector 支持常见的 CRM、日历、笔记工具集成。
平台限制明显:目前仅支持 macOS 12+ 和 Windows 10+,Linux 尚不支持。这意味着它不适合纯 Linux 工作流的团队。
必须依赖 VideoDB 云端:虽然录音和大部分处理在本地,但实时转录和 AI 推理需要 VideoDB 的 WebSocket 服务。没有网络连接时 AI 功能完全不可用——这对隐私敏感场景是一个顾虑。
无明确许可证:项目根目录没有 LICENSE 文件,这是一个潜在的采用风险(SourcePulse 也明确指出了这一点)。开源但没有许可证,意味着法律状态不清晰。
MCP 工具覆盖依赖用户手动配置:intent detector 的正则模式是硬编码的,当前只支持常见的几种信息需求模式。如果你的工作流程不在预设范围内,需要自行扩展代码。
安装包需要自行构建:README 明确说明 Windows 安装包尚未发布官方托管版本,需要从源码构建 (npm run dist:win),这对非技术人员有一定门槛。
call.md 代表了一个明确的趋势:AI Agent 从问答式交互,向场景嵌入式实时智能演进。
过去一年的 AI 助手产品,大多数遵循"你问,我答"的范式。但 call.md 展示了一种更自然的交互模型:AI 观察你的工作流,在适当的时机主动介入。你不需要专门停下来去问 AI,AI 就在你工作的背景中运行。
从 MCP 的角度来看,这个项目也展示了 Model Context Protocol 的一个非常有意思的应用场景:不是连接各种数据源给 LLM 提供上下文,而是让 LLM 根据对话上下文主动调用工具,形成真正的 Agent 闭环。这种"意图检测 → 工具选择 → 结果内联显示"的范式,有望成为未来会议助手、工作流工具的标准设计模式。
目前 GitHub 星标增速平稳(发布半年达到 1400 星),VideoDB 团队在持续维护,labs.videodb.io 有详细的构建博客,说明团队在认真做产品。如果 VideoDB 的 API 定价保持合理的免费额度,这个工具对销售团队、客户成功、创业者等高频会议人群有较高的实用价值。
