
vespa
vespa-engine/vespa加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
在电商搜索框输入"降噪耳机",按回车后的几十毫秒里,系统要同时完成三件事:从数亿商品里挑出候选集、对候选集跑一遍机器学习排序模型、再把向量、文本、结构化字段统一组装成最终结果,而商品库还在被写入改价。这就是 Vespa 每天在做的事——它不是"一个搜索库",而是一台把召回、模型推理、聚合编排焊进同一进程的在线机器学习引擎。
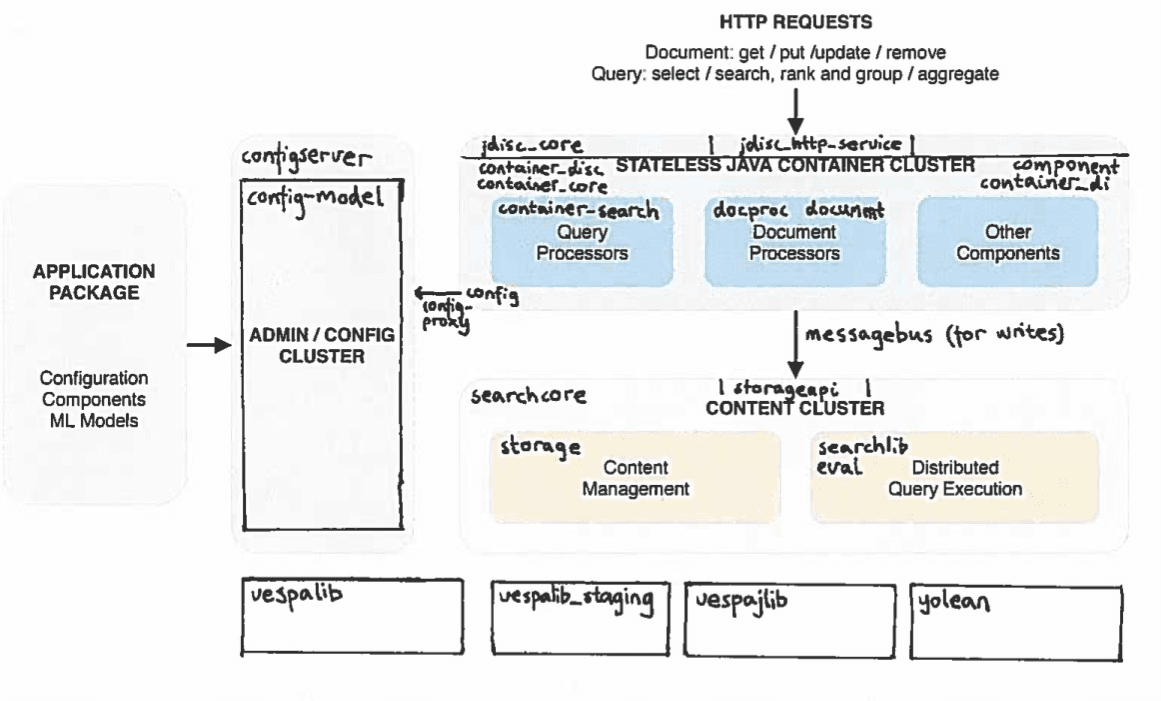
Vespa 起源于 Yahoo 的三代搜索基础设施,二十多年后演化为独立商业平台并以 Apache 2.0 开源。仓库 7100+ stars、750 forks、259 个 open issues,主语言 Java,含约 170 个顶层模块,是典型的超大规模单体仓库。它支持三种形态:Vespa Cloud 托管、自建集群(配置服务器 + 内容节点 + 容器节点)、以及云上 Kubernetes。
把 Vespa 当搜索库会低估它。它更像一套编译系统:你写 schema(字段类型、索引方式、模型引用)和 rank profile(特征 + 打分公式),平台像编译器一样把声明编译成可执行的数据流图再分发到各节点。schema 变更触发 reindex,rank profile 变更触发模型热加载——正是"中间表示 + 增量编译"的心智模型。相比之下 Elasticsearch 更像可查询的 KV 仓库,加模型要外挂;Vespa 把模型当一等公民写进打分表达式。
container-onnxruntime、container-llama、container-search-and-docproc 把 ONNX Runtime、LLM 推理、docproc 嵌进查询路径,支持自定义 Java 组件。clustercontroller-* 负责 reindex 与集群运维,vespa-feed-client 提供高吞吐写入,CI 用 Buildkite,Shell 测试用 BATS。最省事是 Vespa Cloud:注册拿到 tenant 后用 vespa CLI 执行 deploy,提交 schema 与 rank profile。自建则需 AlmaLinux 8、JDK 17、Maven 3.9 或 CMake/C++ 工具链,./bootstrap.sh java 后 mvn install 构建 Java 模块,再拉起 config server 与容器节点。仓库未提供 Dockerfile 或 compose,容器化依赖外部 docker-image-dev 与 Helm chart 仓库。
学习曲线陡峭是公认门槛:schema 与 rank profile 表达力强但语义不直观,YQL 与 Java 组件 API 需要长期积累。仓库本身极重(170+ 模块、混合 C++/Java),fork 与二次开发成本高。文档分散在独立仓库、平台 UI 与开源仓库三处,自建与 Cloud 行为差异也让排障复杂;商业版与开源版的功能边界是社区长期话题。
在 RAG 与推荐成为主流的今天,Vespa 代表"模型与索引共生"的架构路线:不是把向量塞进现有搜索库,而是让排序模型直接参与索引计划与查询执行。它在音乐推荐、内容分发、十万级 QPS 场景的实战经验,构成了今天 AI 搜索基础设施的重要参照系,对正在自建 AI 搜索栈的团队,这套 schema + rank profile + 在线推理仍是被大规模验证过的少数开源答案。
