
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
向量检索已经无处不在——你搜一张图、问一句话、甚至刷一条推荐,背后都是一次"在海量 embedding 向量中找最近邻"的查询。当数据规模从百万飙升到千万甚至亿级时,暴力线性扫描已经不可能了,这时候**近似最近邻搜索(ANN)**成了唯一的出路。
但问题来了:HNSW、Faiss-IVF、PQ、DiskANN、ScaNN……这么多 ANN 算法,到底哪个最适合我的数据? 你的数据是高维的还是低维的?是文本 embedding 还是图片 embedding?追求的是精度还是速度?
学术界和工业界其实都缺一套权威答案——要么数据集太老(用的还是10年前的 GloVe),要么算法覆盖不全,要么评测指标不统一。业界选型往往靠"我司用 HNSW 效果不错"这种口口相传。
这就是 VIBE(Vector Index Benchmark for Embeddings) 诞生的背景——它是一个专门为现代 embedding 数据设计的、可扩展的向量索引基准测试框架,由赫尔辛基大学、哥本哈根大学等多位 ANN 领域知名学者联合推出,发表在 arXiv(arXiv:2505.17810)。
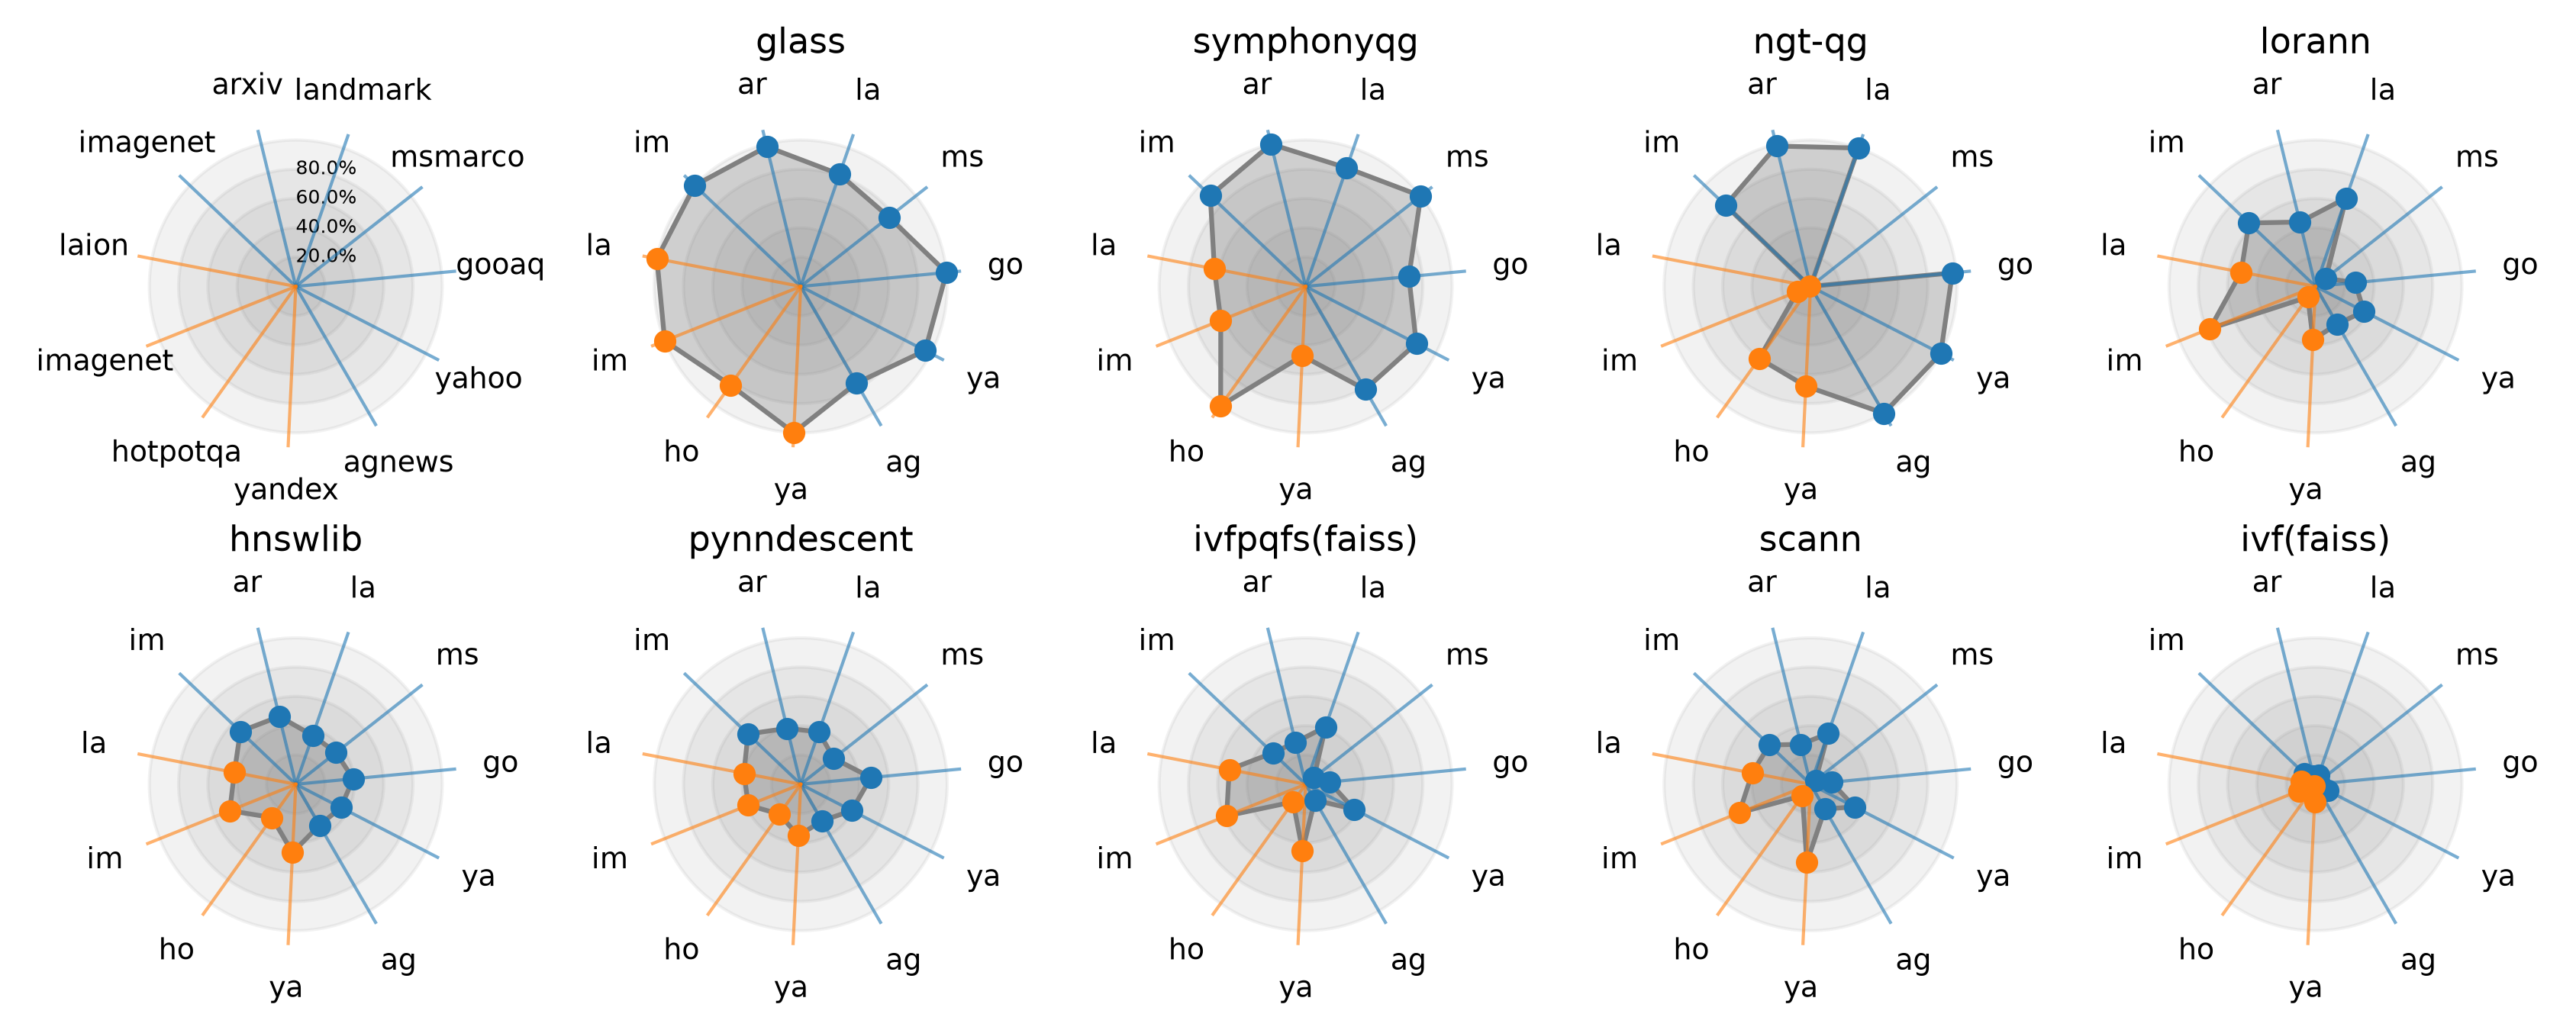
图:VIBE 基准测试雷达图,直观对比各算法在不同数据集 Precision@95 下的综合表现。来源:VIBE 项目主页
向量索引的研究已经有二十多年历史,但 benchmarks 始终落后于实践。
GloVe + SIFT 的时代问题:经典 ANN 基准(如 ann-benchmarks)长期依赖两类"老旧"数据集——GloVe 词向量和 SIFT/Siftsmall 图片特征。问题在于:这些数据的向量维度普遍较低(64~200 维),而现代 embedding 模型输出的维度动辄 768、1024、甚至 4096(如 BERT、CLIP、LLaMA)。低维和高维数据的 ANN 搜索行为有本质差异——高维空间中"维度灾难"让许多经典算法的理论优势不复存在。用 GloVe 跑出来的排名,根本无法指导 LLaMA embedding 的生产选型。
数据漂移的幽灵:除了维度问题,数据分布也至关重要。在-distribution 数据(训练集内)和 out-of-distribution 数据(训练集外)上,同一算法的表现可能天差地别。VIBE 专门设计了 in-distribution 和 OOD 两类测试集,让研究者能够识别算法的"泛化能力"。
VIBE 的核心贡献是填补了这一空白:它引入了现代 embedding 数据集,包括文本(arXiv 论文、DPR 问答、MS MARCO 搜索)、图片(ImageNet-CLIP、landmark 地标)和多模态(LAION CLIP)数据,维度覆盖 200~3072 维,数据规模从 26 万到 2097 万不等。配合 29 种当前最先进的 ANN 算法,VIBE 提供了迄今为止最全面的向量检索性能图谱。
VIBE 的评测设计有几个值得称道的地方:
量化数据集支持:除了标准 float32 精度,VIBE 还支持 int8 量化和二值化压缩场景,这在实际生产中非常普遍(节省 4~32 倍存储)。测试表明,某些算法(如 RaBitQ)在量化后仍能保持高精度,且速度提升显著。
HPC 友好的评测环境:所有 CPU 基准测试在 Intel Xeon Gold 6230(Cascade Lake,AVX-512)上单核运行;GPU 基准测试在 NVIDIA V100 32GB 上进行。评测文档特别强调建议关闭 SMT/超线程、禁用 E 核、设置性能governor,以消除系统干扰——这是专业基准测试的基本素养。
Slurm 调度支持:数据集创建和基准测试都提供了 Slurm job 脚本,可以无缝接入 HPC 集群环境。
VIBE 收录的算法覆盖了当前 ANN 领域的主要技术路线:
| 技术路线 | 代表算法 |
|---|---|
| 图索引 | HNSW、MRPT、LoRANN |
| 量化方法 | Faiss-IVF-PQ、RaBitQ |
| 聚类方法 | ANNOY、PyNNDescent |
| 混合方法 | ScaNN、PDX |
| GPU 加速 | CAGRA(cuVS)、HNSW(GPU版) |
| 磁盘索引 | Vamana(DiskANN) |
VIBE 的数据集设计覆盖了真实应用场景:
VIBE 的上手流程对普通开发者比较友好,前提是你有一台 Linux 机器。
第一步:构建容器镜像
VIBE 使用 Apptainer(原 Singularity)容器封装各算法的依赖环境,避免库版本冲突:
# 安装 Apptainer(Ubuntu)
sudo add-apt-repository -y ppa:apptainer/ppa
sudo apt update && sudo apt install -y apptainer

# 构建所有算法镜像(耗时较长)
./install.sh

# 或只构建特定算法
./install.sh --algorithm hnswlib
第二步:运行基准测试
# 运行单个数据集的测试
python3 run.py --dataset agnews-mxbai-1024-euclidean

# 加速:多进程并行
python3 run.py --dataset agnews-mxbai-1024-euclidean --parallelism 16

# 指定算法
python3 run.py --dataset agnews-mxbai-1024-euclidean --module hnswlib --algorithm hnsw
第三步:出图
# 导出结果
./export_results.sh --parallelism 8

# 绘制单数据集对比图
./plot.sh --dataset agnews-mxbai-1024-euclidean

# 绘制雷达图(综合对比)
./plot.sh --plot-type radar
值得注意的是,run.py 脚本本身不依赖外部库,可以直接裸跑;但构建镜像需要完整的 conda 环境和 Apptainer。对于只想评估特定算法的开发者,可以只构建需要的镜像。
VIBE 很有价值,但也需要清醒看待它的局限。
硬件环境强依赖:AVX-512 是当前 x86 CPU 上运行高效向量索引的基础指令集。AMD Zen 系列或 ARM 架构(如 Apple M 系列)的性能表现与 VIBE 结果可能有显著差异,不能直接套用。
单核基准测试的现实性:VIBE CPU 测试默认单核运行,但现代生产环境普遍使用多核并行检索来降低延迟。单核结果无法直接反映线上 QPS 能力。
覆盖的是离线评测:VIBE 测试的是静态数据集上的检索精度/吞吐量,没有考虑索引构建时间(build time)、增量更新、并发查询等在线场景的维度。
算法实现的版本依赖:ANN 算法性能高度依赖实现版本(如 hnswlib 0.8.0 vs 0.7.0),VIBE 固定了版本号,但随着库版本更新,结果可能发生变化。
VIBE 2025 年发布的时间点恰好在向量数据库赛道白热化竞争的阶段——Pinecone、Weaviate、Qdrant、Milvus 百家争鸣,各家都在强调自己"又快又准"。VIBE 的出现提供了一个独立于商业利益的第三方评测基准,让研究者和企业可以更客观地比较。
从增长趋势看,VIBE 项目在发布后保持了稳定的活跃度(最近更新于 2026-08-10),作者团队持续在 GitHub 上回应 issue,数据集也在持续更新(新增了 LLaMA 和 YI 的 attention embedding 数据集)。这说明学术界对这套基准是认可的。
对于向量数据库开发者、推荐/搜索系统工程师、以及 AI 应用开发者而言,VIBE 是选型阶段的必读参考。它不能告诉你"哪个最快",但它能告诉你"在你的数据维度、数据规模和精度要求下,哪类算法的帕累托前沿最优秀"。
项目信息
