Open RAG Eval:让 RAG 评估不再依赖「标准答案」
想象这样一个场景: 你是一位 AI 工程师,花了两周时间优化公司 RAG 系统的检索和生成 pipeline,自信满满地上线了新版本。第二天产品经理问你「效果比之前好多少?」,你沉默了——因为你的评估集只有 10 条人工标注数据,而且每次改动都要重新请人打分。这样的评估效率,严重拖慢了 AI 产品迭代的速度。
Vectara 开源的 Open RAG Eval 正是为解决这个痛点而生。它是一个开源 Python 评估工具包,专门用来衡量 RAG 系统的检索质量和生成质量,而这一切不需要人工标注的「黄金答案」。
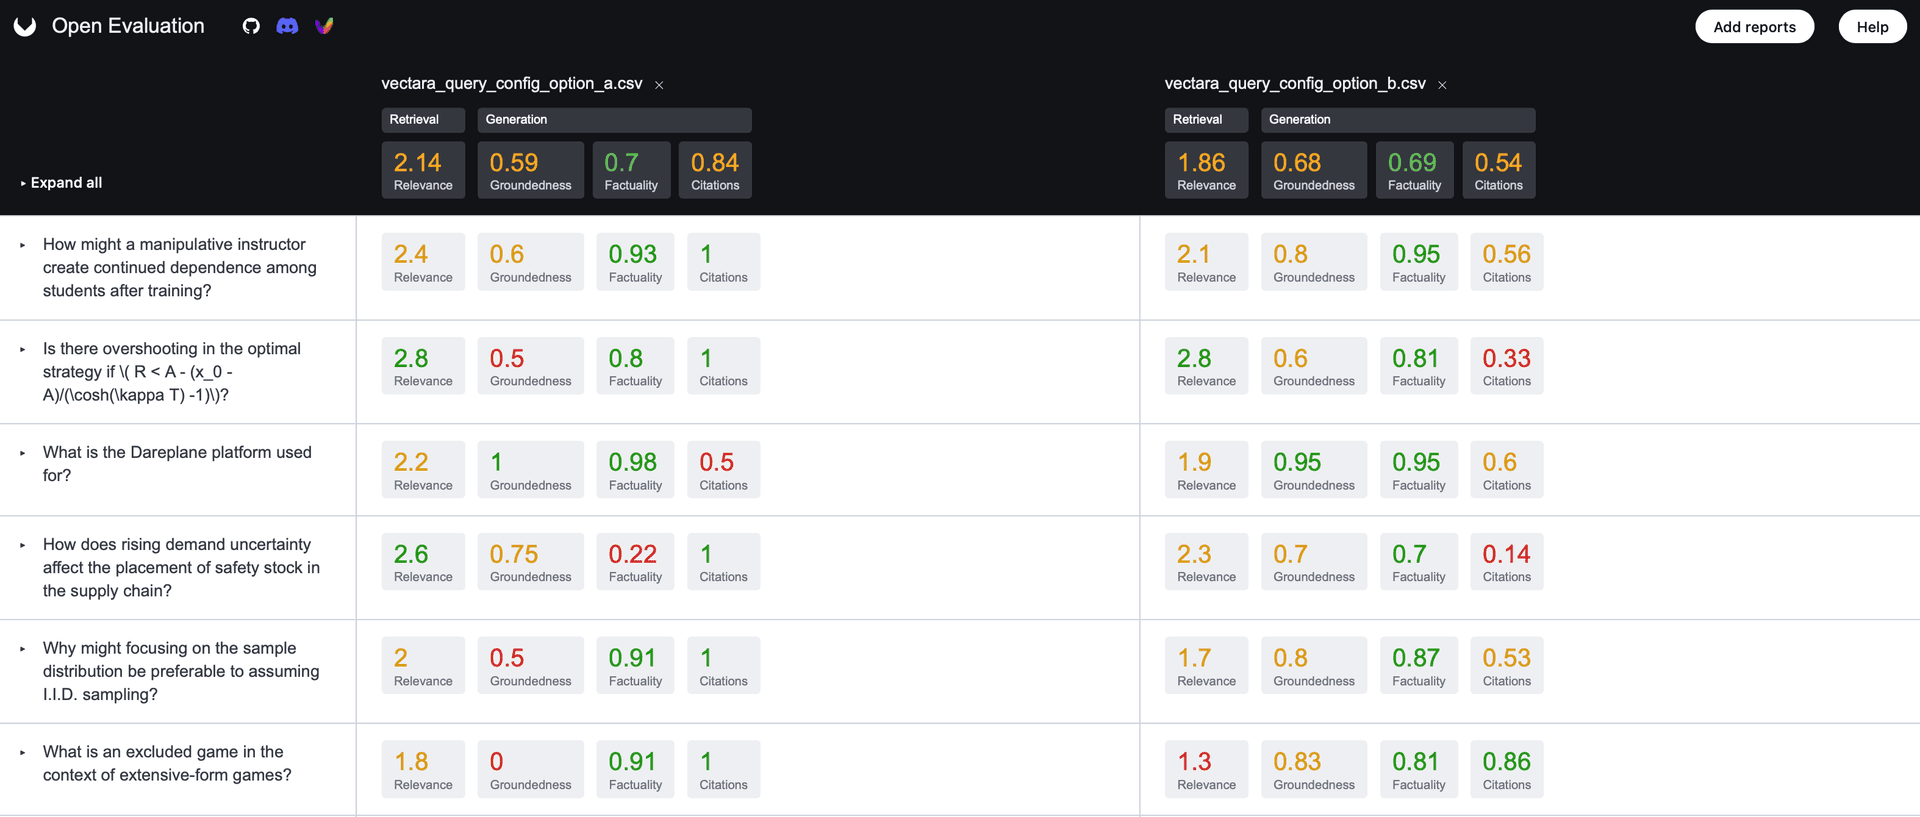 图1:Open RAG Eval 可视化界面
一、为什么 RAG 评估一直是个难题?
RAG(检索增强生成)是当前大模型应用的主流架构,但它天然带来两个评估挑战:
检索端:如何衡量「检索到的内容是否真的相关」?传统方法需要人工为每个 query 标注相关文档,费时费力,且无法覆盖真实用户多样化的提问方式。
生成端:如何判断「生成的答案是否准确、是否引用了正确的来源」?LLM 的输出天然具有多样性,同样的问题可以有不同的正确答案,简单字符串比对完全失效。
Open RAG Eval 提出了一个优雅的解决方案:用 LLM 来评估 LLM。具体来说,它引入了两项核心技术:UMBRELA 和 AutoNuggetizer,全部来自滑铁卢大学 Jimmy Lin 教授实验室的学术研究。
二、核心技术拆解
2.1 UMBRELA:LLM 当「相关性裁判」
UMBRELA(UMbrela is the Bing RELevance Assessor)是微软 Bing relevance assessor 的开源复现。核心思想很简单:不用人工,直接让 GPT-4o 来判断每条检索结果与 query 的相关性。
它使用 0-3 分制:
- 0分:内容与查询毫不相关
- 1分:沾边但不回答问题
- 2分:有答案但混在大量无关信息中
- 3分:专门回答这个问题,且答案精确
GPT-4o 在这个任务上与人类标注的一致性达到 90% 以上,远超普通 LLM 的表现。更重要的是,它的速度快、成本低——评估 1000 条 query 的相关性,成本不到 1 美元。
基于 UMBRELA 打分,系统自动计算:Precision@K、Average Precision、MRR(Mean Reciprocal Rank) 等标准检索指标,让你用业界公认的方式量化检索质量。
2.2 AutoNuggetizer:自动拆解答案质量
AutoNuggetizer 解决了生成质量评估的难题。它的思路来自 TREC QA 评测的「信息粒」(Nugget)方法,但做了自动化升级:
Step 1:Nugget 创建。给定 query + 检索内容,LLM 自动提取「原子信息单元」——每个单元是一个 1-12 个词的不可分割的信息点(最多 30 个)。例如对于「黑洞是什么」这个问题,LLM 可能提取出:
- 「黑洞是一种天体」
- 「由恒星坍缩形成」
- 「引力极强,连光都无法逃脱」
Step 2:重要性打分。每个 nugget 被分为「关键」(Vital)或「可选」(Okay)两类。关键信息缺失,答案质量大打折扣。
Step 3:答案匹配。将生成的答案与 nugget 列表对照,标记每个 nugget 的状态:
- 完全覆盖:得 1.0 分
- 部分覆盖:得 0.5 分
- 未提及:得 0.0 分
最终得分 = 关键信息覆盖加权 + 可选信息覆盖加权。这就是 AutoNuggetizer 的核心指标——一个类似 F1 的综合分数。
2.3 还支持哪些评估能力?
- Hallucination Detection:检测生成答案中的幻觉(基于 Vectara HHEM 模型或商业 API)
- No-Answer Detection:判断问题是否超出了知识库范围,避免模型强行「编造」答案
- Citation Metric:评估答案是否正确引用了检索来源
- Golden Answer Metrics:如果你有标注数据,也可以用传统 ROUGE、BERT-Score 做对比评估
三、架构设计与代码结构
项目采用模块化插件架构,代码组织清晰,扩展性极强:
open_rag_eval/
├── connectors/          # RAG 平台连接器
│   ├── vectara_connector.py    # Vectara 官方连接器
│   ├── llama_index_connector.py # LlamaIndex 集成
│   └── langchain_connector.py   # LangChain 集成
├── evaluators/          # 评估器
│   ├── trec_evaluator.py        # TREC-RAG 基准评估器
│   ├── consistency_evaluator.py  # 一致性评估
│   └── golden_answer_evaluator.py # 有标注数据时使用
├── metrics/             # 核心指标实现
│   ├── umbrela_metric.py        # UMBRELA 检索相关性
│   ├── autonugget_metric.py      # AutoNuggetizer 生成质量
│   ├── hallucination_metric.py  # 幻觉检测
│   └── citation_metric.py        # 引用质量
├── models/              # LLM 法官
│   ├── llm_judges.py           # 多模型支持(OpenAI/Claude/Anthropic/Together)
│   └── embedding_models.py     # 向量嵌入模型
├── api/                 # REST API 服务
│   └── server.py               # Flask API(端口5000)
├── viz/                 # 可视化
│   └── visualize.py            # 评估结果图表
└── cli.py               # 命令行入口
连接器(Connector)模式让项目高度解耦:要接入新的 RAG 平台,只需实现一个 Connector 类,就能复用所有评估指标。Vectara 官方已提供 LlamaIndex 和 LangChain 的连接器,社区可以轻松扩展到其他框架。
API 服务基于 Flask + CORS,暴露 REST 接口,方便 CI/CD 流水线集成或前端调用。
四、快速上手
方式一:pip 安装(推荐)
pip install open-rag-eval
准备 query 列表(CSV 格式):
query
黑洞是什么?
太阳有多大?
木星有几颗卫星?
配置 YAML(以 Vectara 为例):
connector:
  type: VectaraConnector
  options:
    corpus_key: your-corpus-key
运行评估:
export VECTARA_API_KEY=your-api-key
export OPENAI_API_KEY=your-openai-key
open-rag-eval evaluate --config eval_config_vectara.yaml
方式二:Docker 部署
git clone https://github.com/vectara/open-rag-eval.git
cd open-rag-eval
docker build -t open-rag-eval .
docker run -p 5000:5000 -e OPENAI_API_KEY=... open-rag-eval
方式三:API 服务
python run_server.py --host 0.0.0.0 --port 5000
然后向 /evaluate POST 发送 RAG 结果即可获取评估分数。
五、局限与争议
1. LLM 评估的成本与延迟:UMBRELA 和 AutoNuggetizer 都需要调用 GPT-4o,每条 query 的评估可能产生数次 LLM 调用。大规模评估(>10000 条)成本不可忽视。可以考虑切换到更便宜的模型(如 GPT-4o-mini 或本地模型),但准确性会有所下降。
2. 评估结果受模型影响:LLM 作为「裁判」本身存在偏好和偏见。GPT-4o 对某些领域的判断可能不够准确,特别是涉及最新技术或细分专业知识时。建议在高风险场景中结合人工抽检。
3. 无 Web UI:相比商业 RAG 评估平台(如 Ragas、Berkeley 的 RAGChecker),Open RAG Eval 缺少图形化界面,所有配置通过 YAML 文件完成,对非技术用户不够友好。
4. 连接器覆盖有限:目前官方只支持 Vectara、LlamaIndex、LangChain 三种,其他 RAG 框架需要自行实现 Connector。
六、行业意义
Open RAG Eval 的核心价值在于降低了 RAG 评估的门槛。在此之前,学术界和工业界普遍依赖 TREC RAG Track 的人工标注数据,但数据规模有限(通常数百条),且更新速度远跟不上 RAG 技术的演进。
UMBRELA 和 AutoNuggetizer 的组合,让开发者可以在任意规模、任意领域的 RAG 系统上做量化评估。Vectara 将这两项学术成果工程化落地,提供了开箱即用的工具,对 RAG 生态的工程化成熟度有显著推动作用。
从 GitHub 数据看,该项目获得了 378 颗星,增长趋势得分 68.34(满分100),月度趋势 64.89,表明其在 RAG 开发者社区中已有相当的影响力。随着 RAG 技术在企业 AI 应用的持续普及,类似 Open RAG Eval 的评估工具将成为 AI 工程化流水线的标配组件。
一句话总结:Open RAG Eval 用 LLM 评估 RAG,巧妙绕过了「黄金答案」的人工标注瓶颈,让 RAG 系统的迭代评估变得快速、可重复、成本可控。

