PaperLens
vanthree31/PaperLens加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
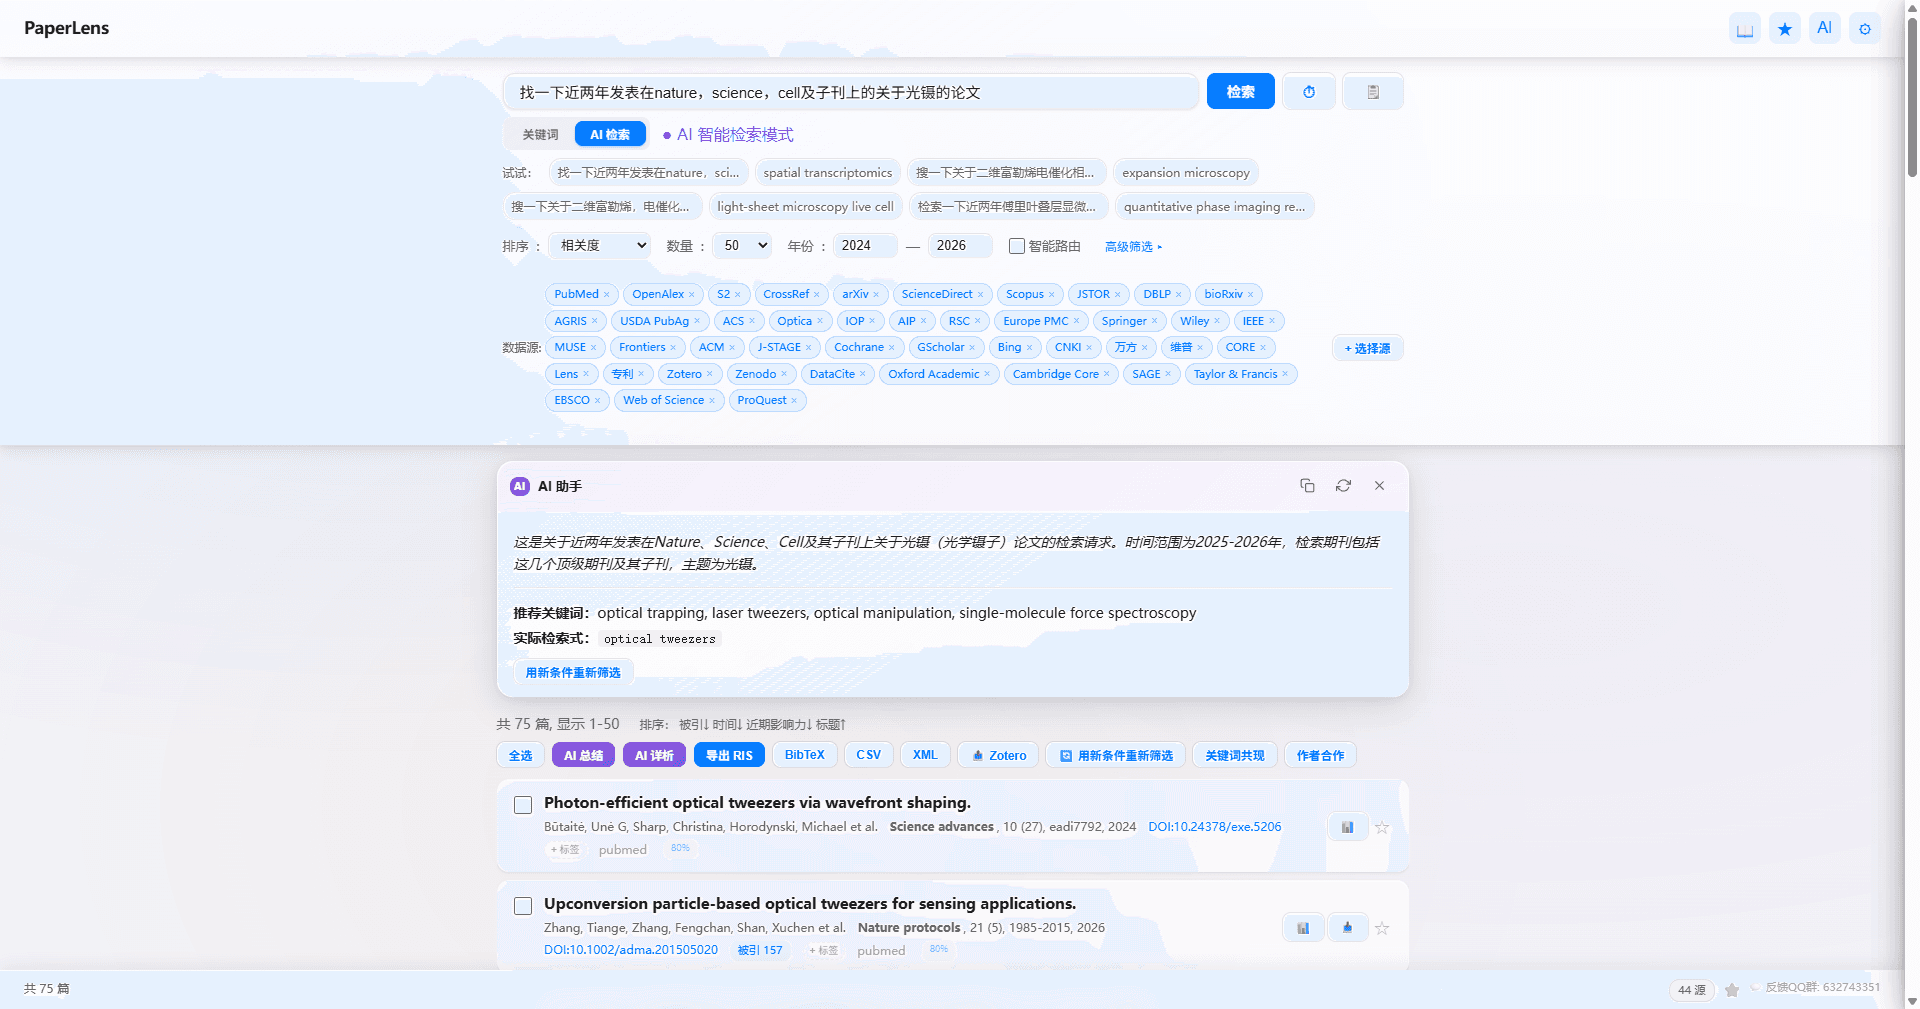
写论文最耗时的那一段,不是写,是找。你在 Google Scholar 搜到一篇相关文献,打开 PDF 翻到第 6 页发现它引用了你要的那篇数据;回到搜索框换个词,又是十几篇新结果。半小时后你手上有 20 个浏览器标签页、8 篇下载的 PDF、3 个打开的笔记软件,还有一句「刚才那篇好像是……算了」。
PaperLens 想把这一整段变成一个流程:找到 → 筛选 → 读懂 → 存下 → 引用。像 Cursor 之于代码,PaperLens 之于论文。
vanthree31/PaperLens 于 2026 年 6 月创建,188 星、8 fork,以 Python 为主语言。它是一个 AI 驱动的学术研究助手,定位是「AI Research Copilot」,把分散的文献工作流收拢为一个连贯的闭环。
项目的本地优先定位相当激进:数据全部留在本机,可完全离线配合 Ollama 运行,无需账号。与之配套的是数据来源规模——README 标注 46 个数据源、43 个学术数据库并行检索(含 PubMed、Scopus、ScienceDirect、arXiv、CNKI 等),以及通过 CARSI 接入 300+ 中国高校,宣称无需 VPN 即可访问 ScienceDirect、Scopes、JSTOR。
如果传统文献工具是图书馆目录卡——帮你定位一本书在哪,但内容还得你自己去翻,PaperLens 像是雇了个助手:你描述研究问题,他去把相关文献捞出来、排好序、每篇给一段 AI 解读,再把引文格式整理成你能直接用的样子。
有 build.bat 说明主要面向 Windows 用户,需要 Python 3.9+ 环境。部署路径是本地运行 Python 应用(从 main.py、core/ 目录结构看是 Flask 应用),无需 GPU——如果使用 Ollama 本地模型则取决于所选模型规模。
按项目定位,安装后完全离线可用,也不需要账号或 API Key(若用云端模型则另需)。
PaperLens 抓住了国内研究者的一个真实痛点:文献检索的「最后一公里」不是找不到,而是找不到能用的、并且访问得了的。CARSI 通道是针对中国高校场景的精准设计,这一点国外同类项目(Semantic Scholar、Connected Papers、Zotero)没有覆盖。
它的「本地优先 + Ollama 离线」选择同样值得注意。在论文数据涉密、研究资料不宜上云、以及国内 API 服务可用性不稳定的背景下,本地模型 + 本地存储是更稳妥的工程决策,也让它可以作为国内团队的二次开发底座。
更广的信号是:学术工具正在从「检索工具」向「研究 Copilot」迁移。这个转变的技术前提是 RAG 与论文级长文本理解能力的成熟——项目 topics 里直接标了 rag、openalex、pubmed。
对团队来说,它的可借鉴点有两个:一是本地优先的数据架构,二是面向中国高校网络环境的适配层。这两件事通用性极强,无论最终是否采用这个项目。