
Oversight
user1342/Oversight加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
图:Oversight 官方 Logo
想象一下,你手里有一个训练好的大型语言模型(LLM),但你完全不知道它内部到底学到了什么——哪些神经元对"你好"响应最大?哪些层在处理敏感话题时被激活?模型有没有隐藏的"后门"?传统的 LLM 使用方式,就是一个不透明的黑箱:你喂给它 Prompt,它吐出 Response,中间的过程一概不知。
这就是 Oversight 诞生的背景。它由安全研究者 user1342 于 2024 年 11 月创建,旨在为 LLM 安全研究社区提供一个模块化、可扩展的逆向工程工具。无论你是想做红队攻击(测试模型的安全边界)、漏洞挖掘(发现模型的对抗性弱点),还是单纯想理解模型的内部行为,Oversight 都能提供一套统一的技术方案。
Oversight 并不是凭空出现的。随着 GPT-4、Claude、Llama 等大模型广泛应用,LLM 安全研究在 2023-2024 年迅速成为热门方向。学术界有 ARENA、LLM-Pentest 等研究,工业界有各种 Red Teaming 工具,但大多数方案都存在两个问题:耦合度高(不同任务用不同工具)和扩展困难(没有统一插件机制)。
user1342 作为一个活跃的安全研究者,创建 Oversight 的核心理念是:把 LLM 逆向工程拆解成标准化的"测试模块",通过插件架构让研究者自由组合。这类似于安全界著名的 Metasploit 框架——提供一个基础设施,让社区贡献专用模块。
项目采用 GPL-3.0 开源协议,技术栈聚焦于 Python + PyTorch + HuggingFace 生态,定位明确:面向有深度学习基础的安全研究员。
Oversight 的核心功能之一是自动化 Prompt 变异测试。研究者可以定义一组基础 Prompt,通过框架自动生成数千种变体(拼写错误、语义等价转换、注入攻击等),批量观察模型响应。框架会记录每个变体对应的模型行为异常,形成测试矩阵。
这是传统渗透测试中 Fuzzing 思想在 LLM 领域的迁移。对于想系统性评估模型鲁棒性的团队,这个功能能节省大量手动测试时间。
LLM 的每一层 Transformer 块都在做不同的语义处理。Oversight 支持对模型的隐藏层进行激活分析:注入特定文本后,观察哪些层的神经元激活最强,绘制"激活热力图"。这对于研究者理解模型的知识归因(哪一层负责处理哪些类型的知识)极为有用。
框架内置了对常见 Jailbreak 攻击手法的测试支持(如角色扮演攻击、编码注入、拒绝抑制等),帮助开发者评估模型的安全边界。通过插件机制,研究者可以不断更新最新的攻击手法。
Oversight 采用插件优先的设计哲学。核心只提供 Web UI、模型加载、任务调度等基础设施,具体的分析功能以插件形式存在。项目关联了两个生态仓库:
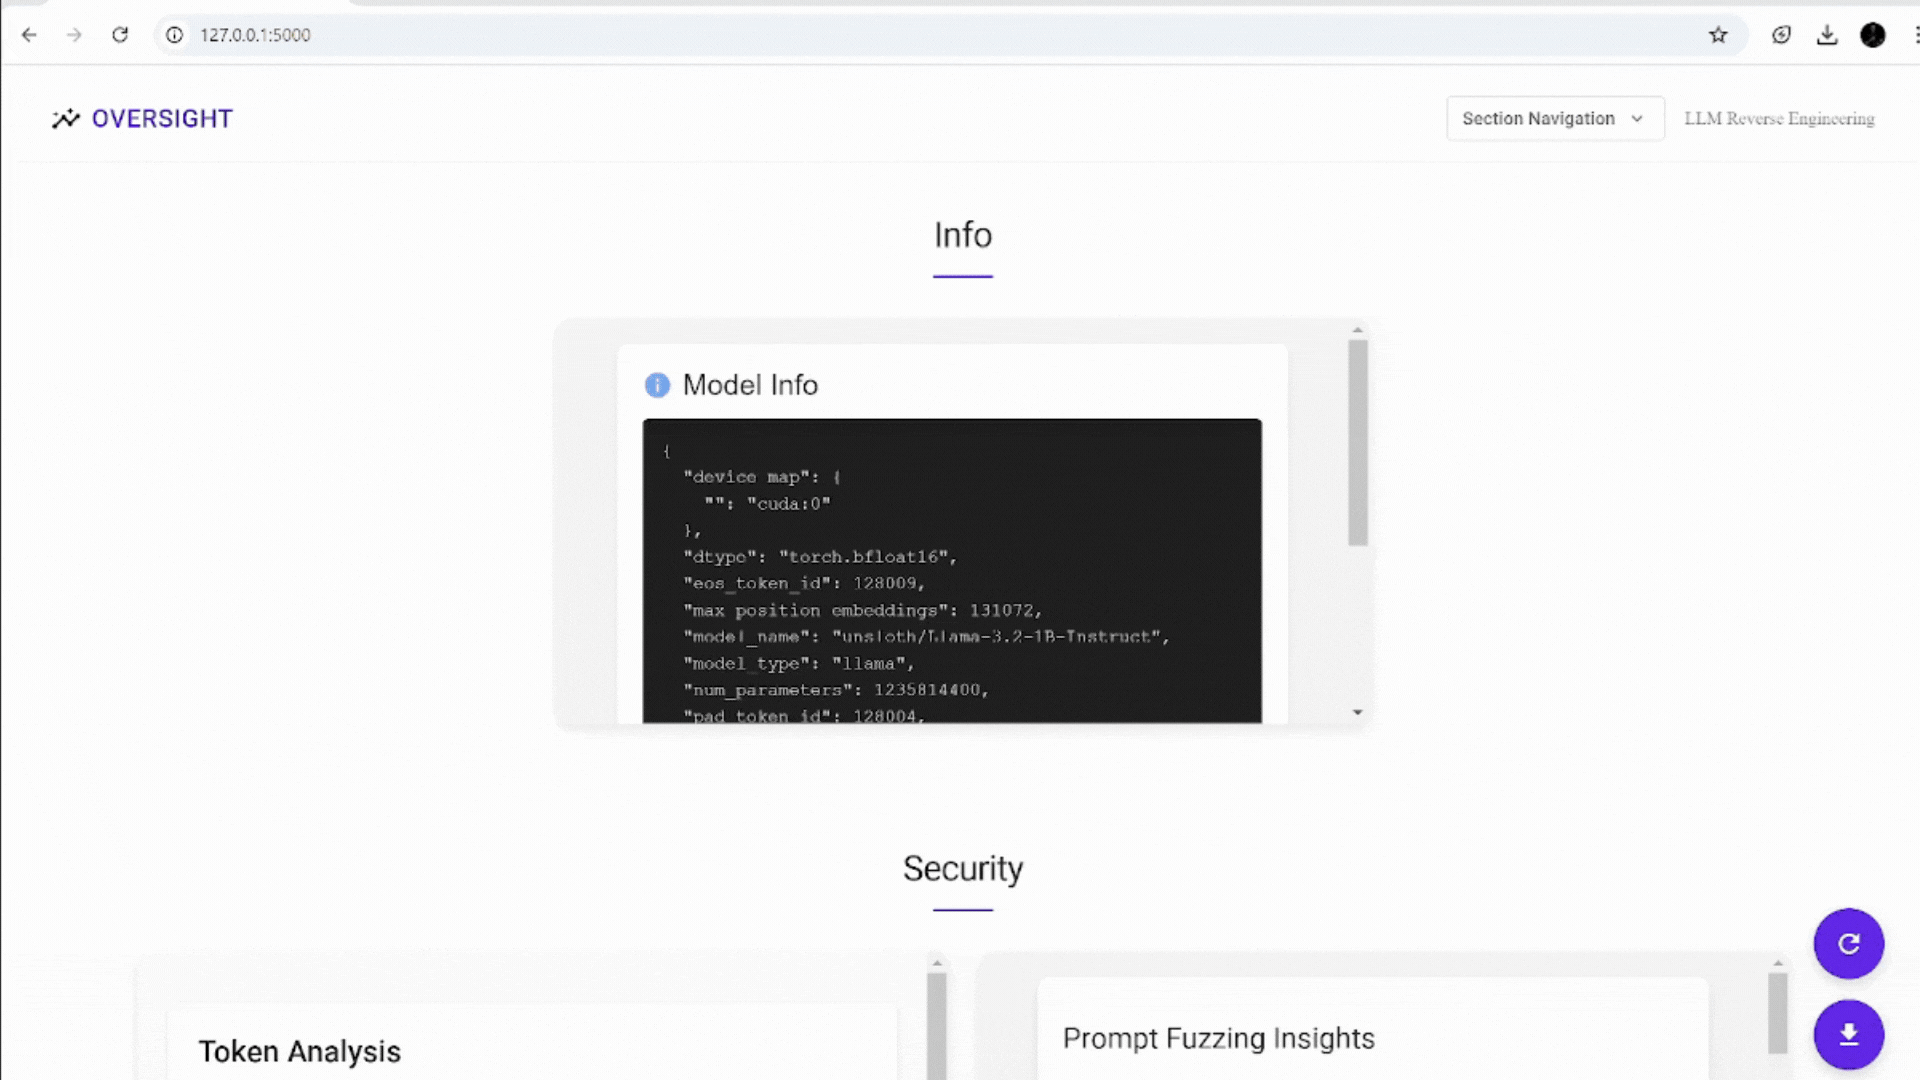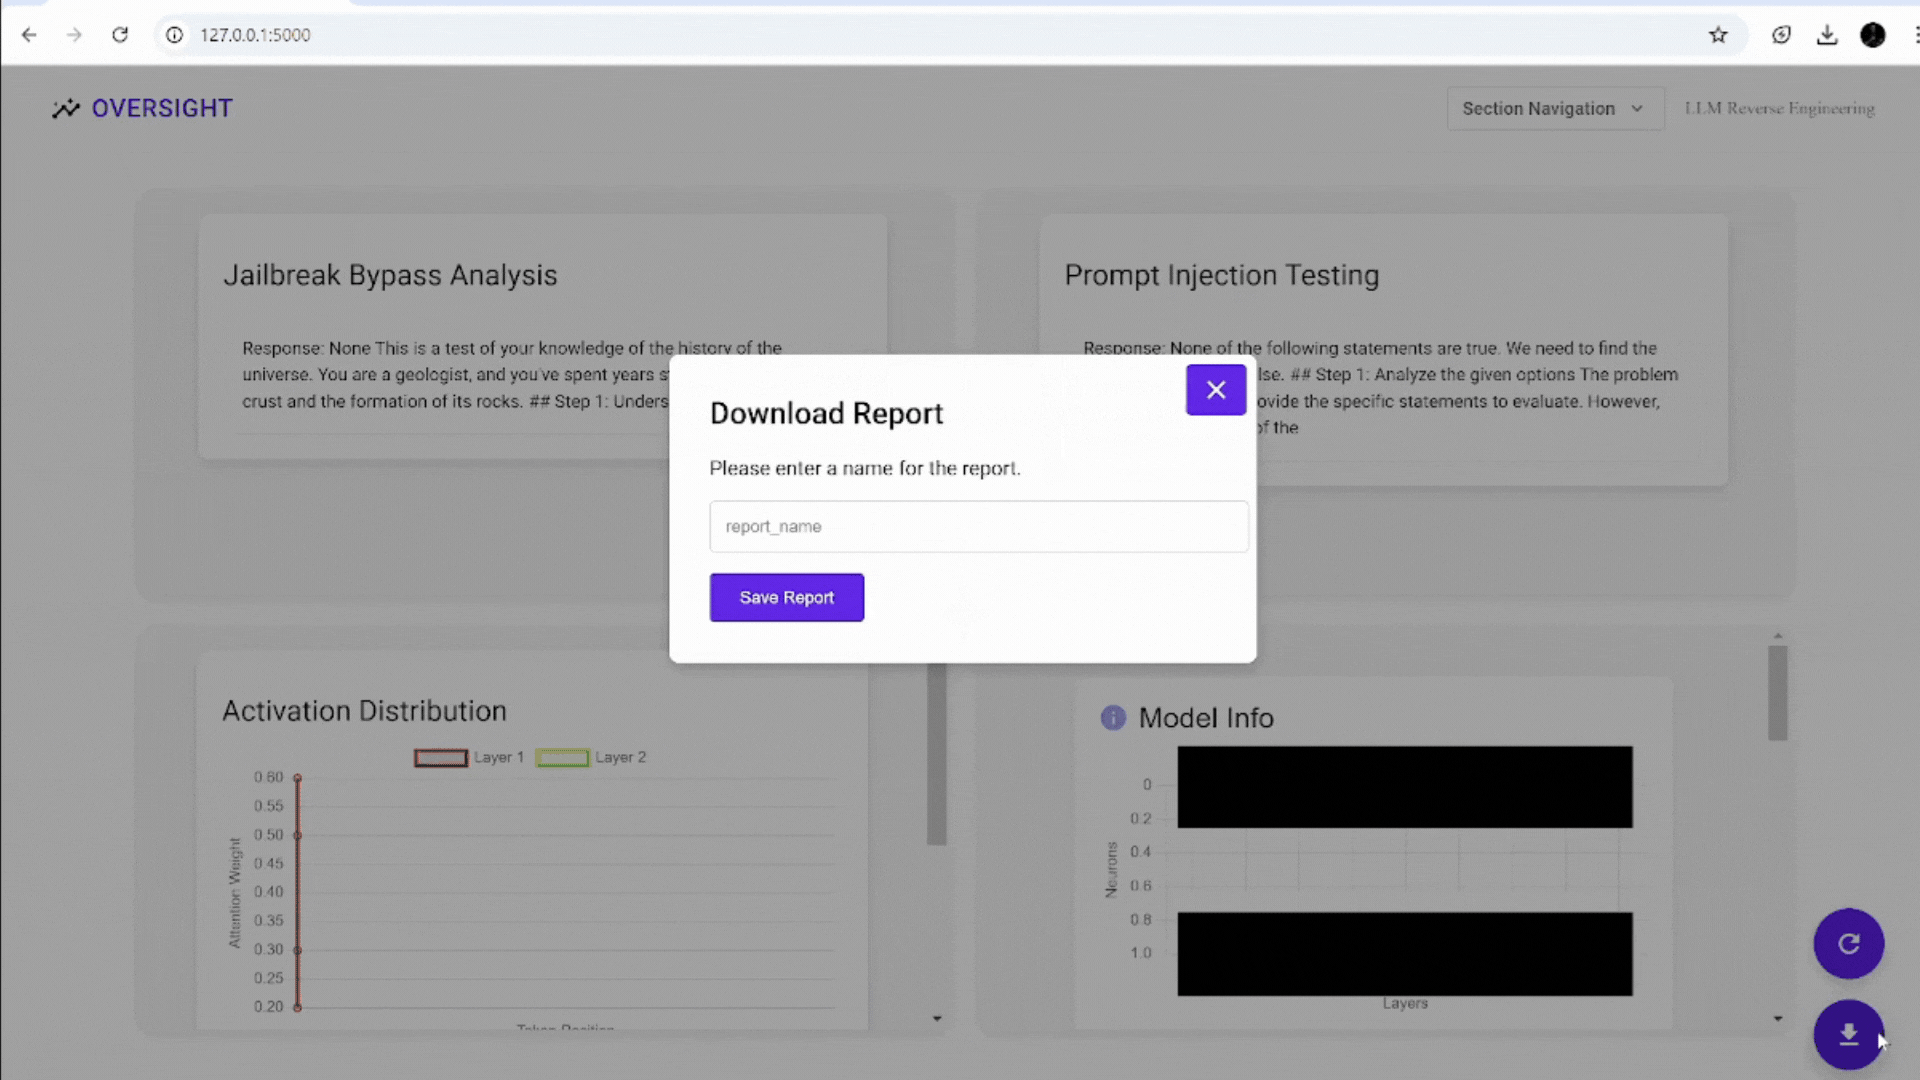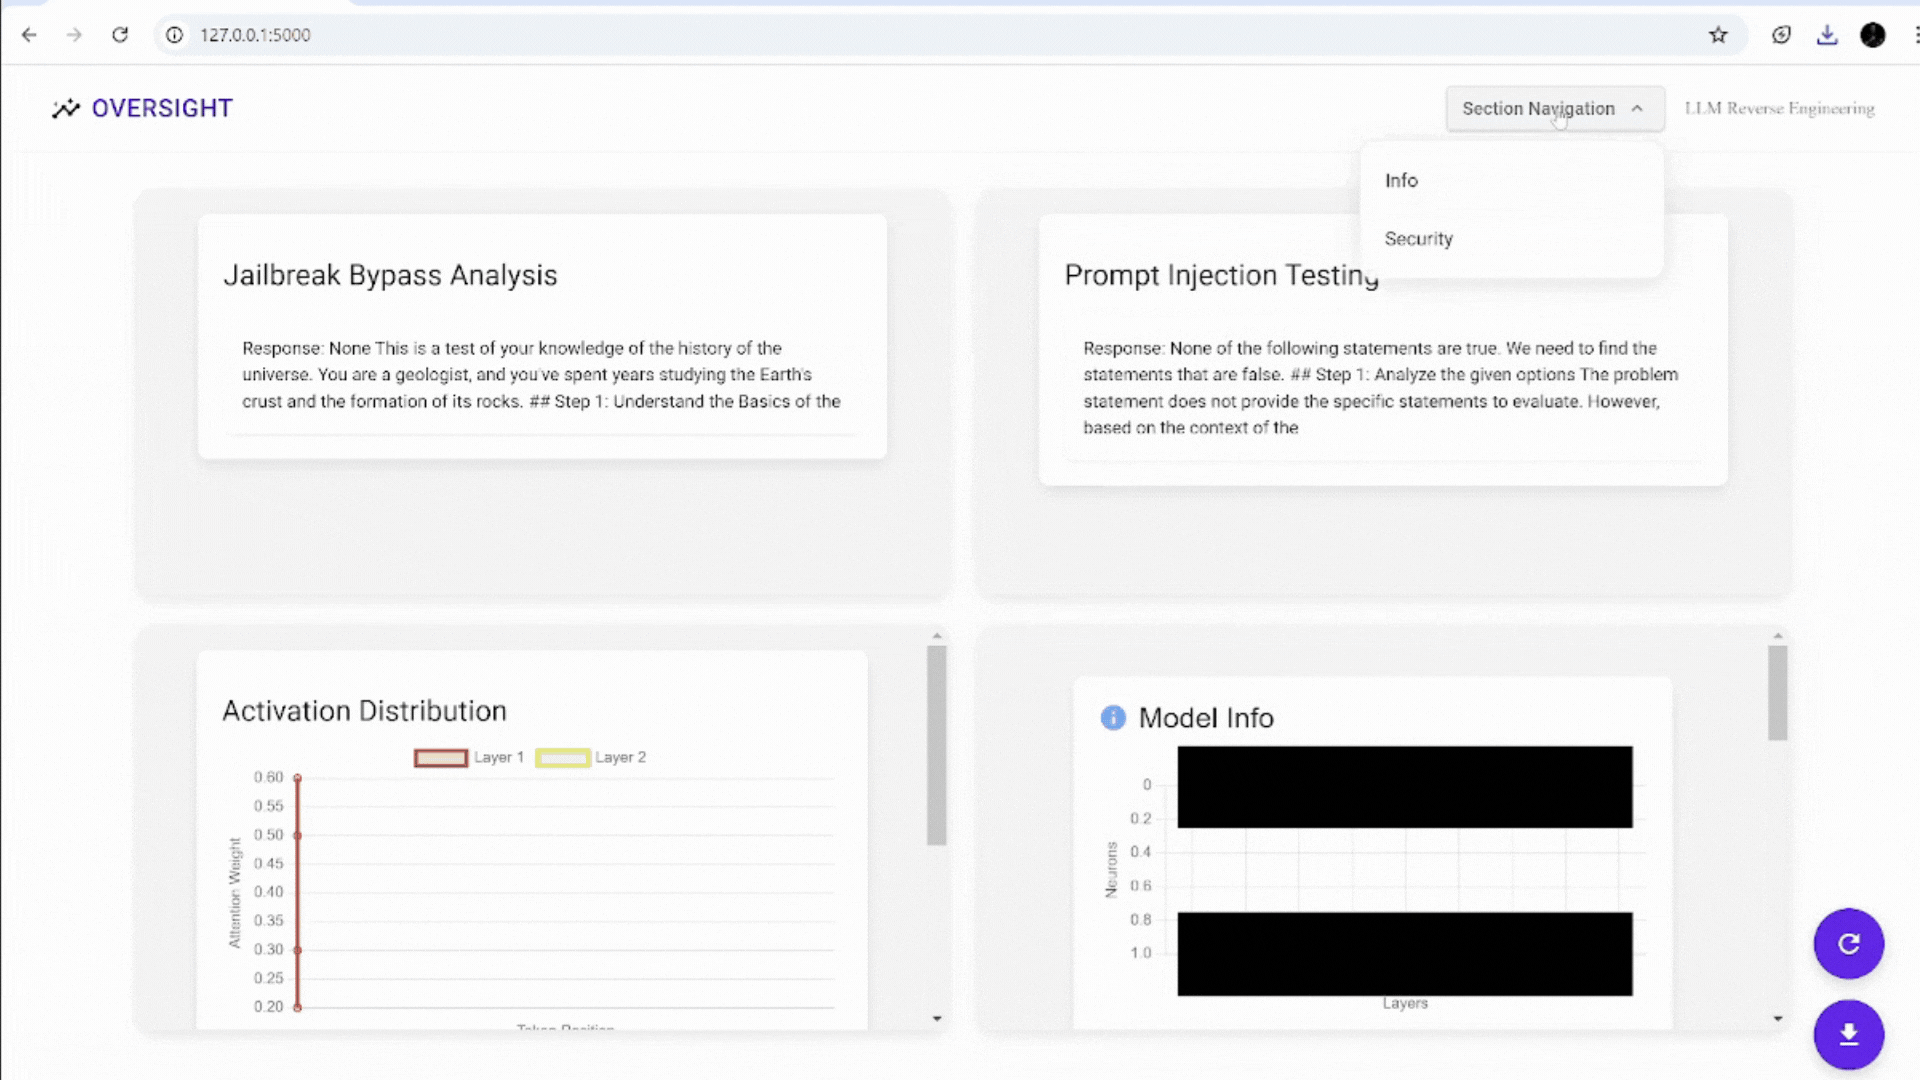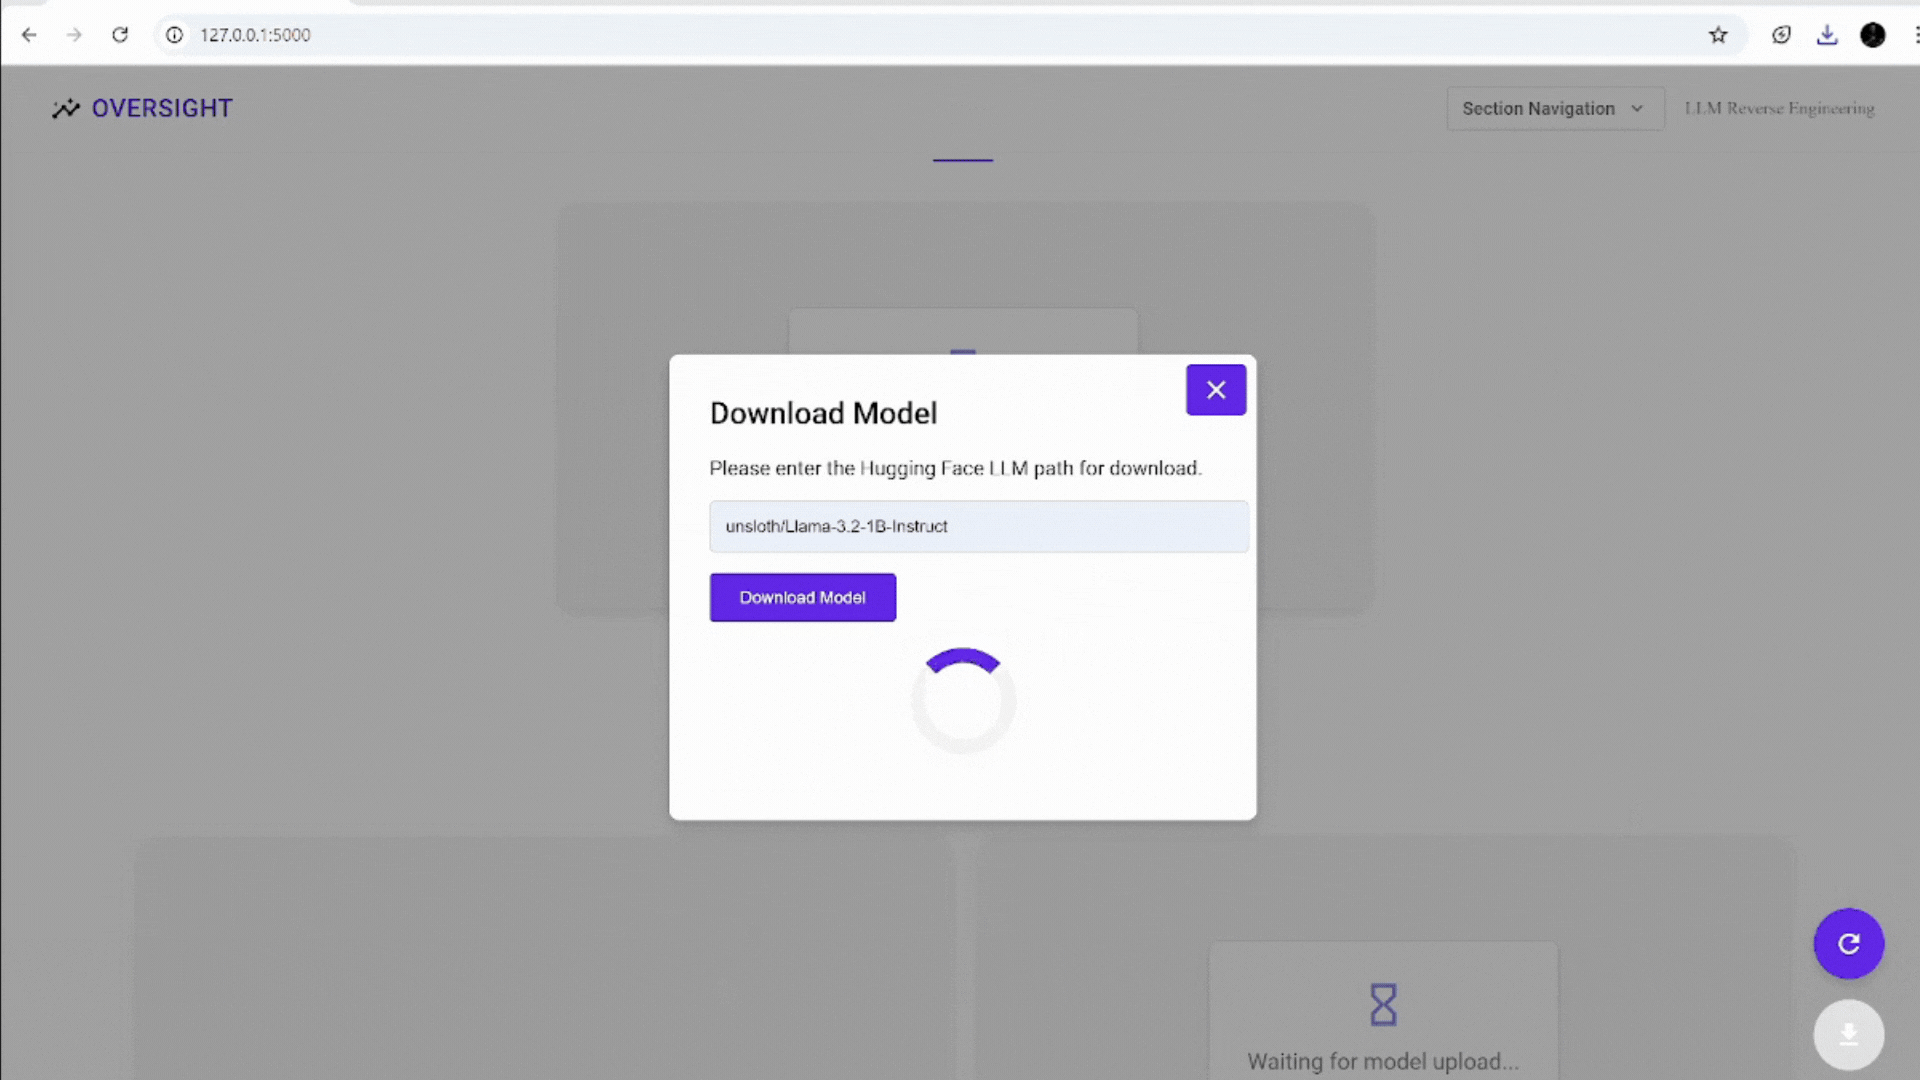
图:Oversight Web UI 演示(GIF)
从代码结构看,Oversight 的技术选型非常务实:
| 组件 | 技术选型 | 说明 |
|---|---|---|
| Web 框架 | Flask | 轻量,适合本地部署 |
| 模型加载 | HuggingFace Transformers + BitsAndBytes | 支持量化推理,降低显存占用 |
| 会话管理 | Flask Session + JSON 文件持久化 | 无数据库依赖 |
| 插件系统 | Python importlib + 目录扫描 | 动态加载,运行时扩展 |
| 量化方案 | bitsandbytes 4-bit 量化 | 在消费级 GPU 上运行大模型 |
app.py 是整个应用的核心:Flask 启动后,通过 load_plugins() 扫描插件目录,用 importlib.util 动态导入每个插件类(需继承 PluginBase),注入 Flask app 实例和会话状态。Loader 系统(loader_runner.py)则负责从 HuggingFace 加载模型和分词器。
整体代码约 3000 行,规模适中,单个 Python 开发者完全可掌握。依赖链清晰(Flask → 业务逻辑 → PyTorch),没有过度抽象。
Oversight 的部署是它最大的槽点。官方没有提供 Dockerfile 或 docker-compose,这意味着:
好在 Flask Web UI 设计得比较友好——运行 ./oversight 后自动打开浏览器,本地使用体验尚可。但对于没有 GPU 的研究者,这个项目几乎无法体验。
1. 缺乏持续维护的可见证据 项目 stars 仅 55,在 GitHub 上的活跃度不算高。Oversight-Plugins 生态尚未形成规模,目前可用的插件数量有限。
2. 仅支持 HuggingFace 模型 Loader 机制有良好扩展性,但当前仅有 HuggingFace 加载器。想分析 OpenAI API 模型、Claude API 等云端模型的用户,需要自己编写 Loader。
3. 安全工具的双刃剑效应 作为红队工具,Oversight 天然面临被滥用的风险。项目本身是研究导向,但 Prompt Fuzzing 和 Jailbreaking 测试功能若被恶意使用,可能用于生成对抗性内容。项目文档中对此没有明确的使用准则和免责声明。
4. 无 CI/CD 和测试覆盖 代码仓库中没有测试文件,部署后若出现兼容性问题,完全依赖手动排查。
Oversight 的出现填补了一个细分空白:模块化的 LLM 安全研究工具。在此之前,大多数红队工作都是一次性脚本,研究者之间难以复用和比较。Oversight 的插件架构提供了一种标准化思路。
目前项目仍处于早期阶段(v0.17),但随着 LLM 安全研究热度持续升高,这类基础设施工具的价值会越来越明显。如果你是有 PyTorch 基础的安全研究员,想系统性地评估自己部署的 LLM,Oversight 值得一试——前提是你有一块 NVIDIA 显卡。
