yolov3
ultralytics/yolov3加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
2018 年,一篇名为《YOLOv3: An Incremental Improvement》的论文让整个计算机视觉圈沸腾。它的核心观点粗暴而有力:人不需要看两次。传统检测器(R-CNN 系列)先"扫描"找出可能存在目标的区域,再"分类"确认;而 YOLOv3 把这两步压缩成一次前向传播——一张图进去,边界框和类别概率直接吐出来。这就像一个熟练的出租车司机,不会先在地图上标出所有可能的乘客位置再挨个去问,而是扫一眼街道就报出"前面路口有三人"。
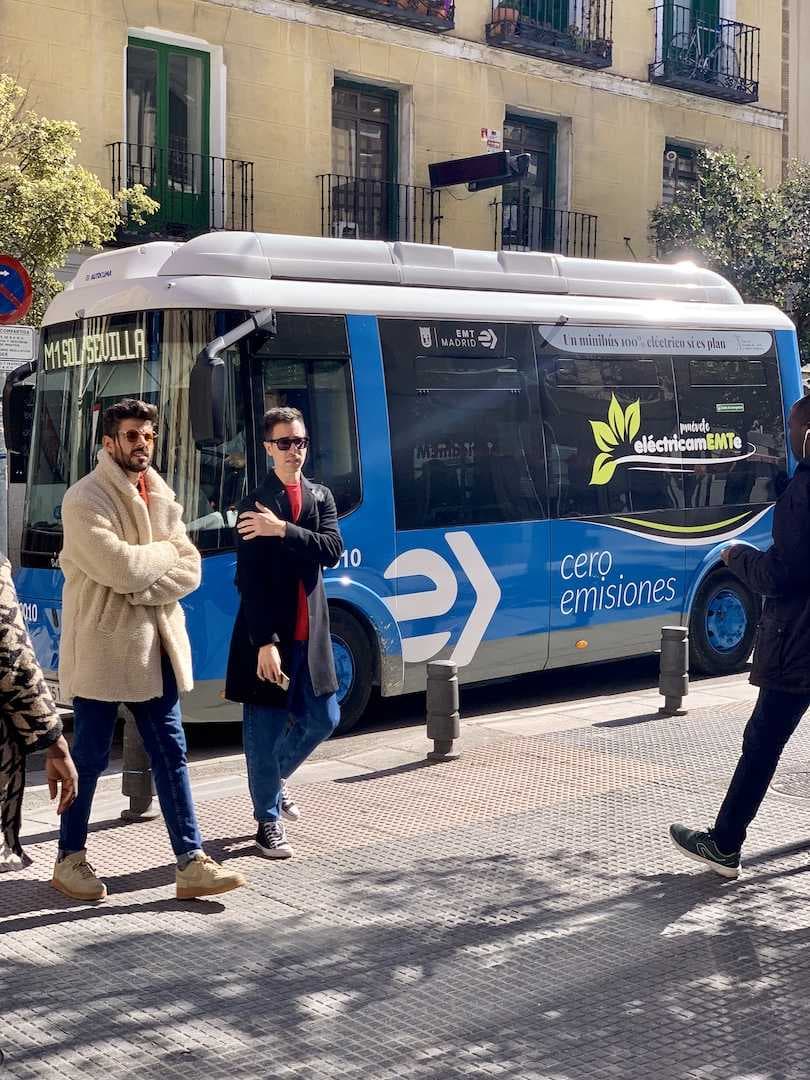
YOLOv3 也留下了那个著名的画面:一张公交车照片,车上密密麻麻的检测框标出"人"、"公交车"。这个例子后来几乎成了目标检测的入门仪式——几乎每个学视觉的人都在某个教程里见过它。而它背后所属的仓库,正是你今天正在读的 ultralytics/yolov3。
七年后,2026 年 10 月,这个仓库的最近一次推送仍然活跃。它没有躺在尘土里,而是作为"基线"与"参照系"继续发挥着作用。
要理解这个仓库的分量,得先理解 Ultralytics 这家公司。创始人 Glenn Jocher 原本做的是"刺猬"(Hedgehog)这类嵌入式视觉项目,2016 年他把目标检测模型重写成一个可以直接训练、部署的轻量框架,取名 YOLO(You Only Look Once)。这个框架后来催生了 YOLOv2、YOLOv3,再演进出 YOLOv4(由他人贡献并以 YOLOv3 为基础)、YOLOv5、YOLOv8,直到今天的 YOLO11、YOLO26。
在这个家族谱系里,ultralytics/yolov3 是一个特殊的存在:它是"官方原教旨"版本。仓库结构非常克制——根目录只有 20 个文件,detect.py、train.py、val.py、export.py、benchmarks.py 五个入口脚本,models/ 放网络定义,utils/ 放数据加载、损失函数、增广、后处理,data/ 放 10 个数据集的 YAML 配置(COCO、VOC、Objects365、VisDrone、GlobalWheat2020 等)。总共 100 个文件、约 46 万行 Python,代码量轻量。
关键细节是:现在的 yolov3 已经不是一个"独立框架",而是重度依赖 ultralytics 这个 pip 包(requirements 里要求 ultralytics>=8.4.164)。也就是说,YOLOv3 的骨干、训练器、验证器都从新框架里来,这个仓库更像是一个"模型配置 + 入口脚本 + 文档"的门面。这既让老代码焕发新生,也带来一个隐忧:想跑 YOLOv3,你实际上必须装上全套现代 ultralytics 生态。
如果把目标检测比作"在菜市场里同时找出所有番茄和土豆并标出它们的位置",那么:
train.py)、怎么考核(val.py)、怎么上岗干活(detect.py)、怎么把技能迁移到别的平台(export.py)。训练与验证:train.py --cfg yolov3.yaml --weights yolov3.pt 启动,数据从 data/coco.yaml 拉取,utils/dataloaders.py 负责加载与增强(mosaic、HSV 抖动、随机仿射),utils/autoanchor.py 自动重算锚框,utils/autobatch.py 根据显存自动定 batch size——这套"自动化"是 Ultralytics 相比原始论文实现最大的易用性提升。val.py 输出 mAP@0.5、mAP@0.5:0.95。
推理:能力覆盖极广,detect.py 支持图片、目录、glob 通配、视频、摄像头、RTSP/HTTP 直播流、屏幕截图(screen),并支持多设备(CPU/CUDA/MPS/多 GPU)。模型可通过 PyTorch Hub 一行加载:torch.hub.load('ultralytics/yolov3', 'yolov3_tiny'),这对教学和快速验证极其友好。
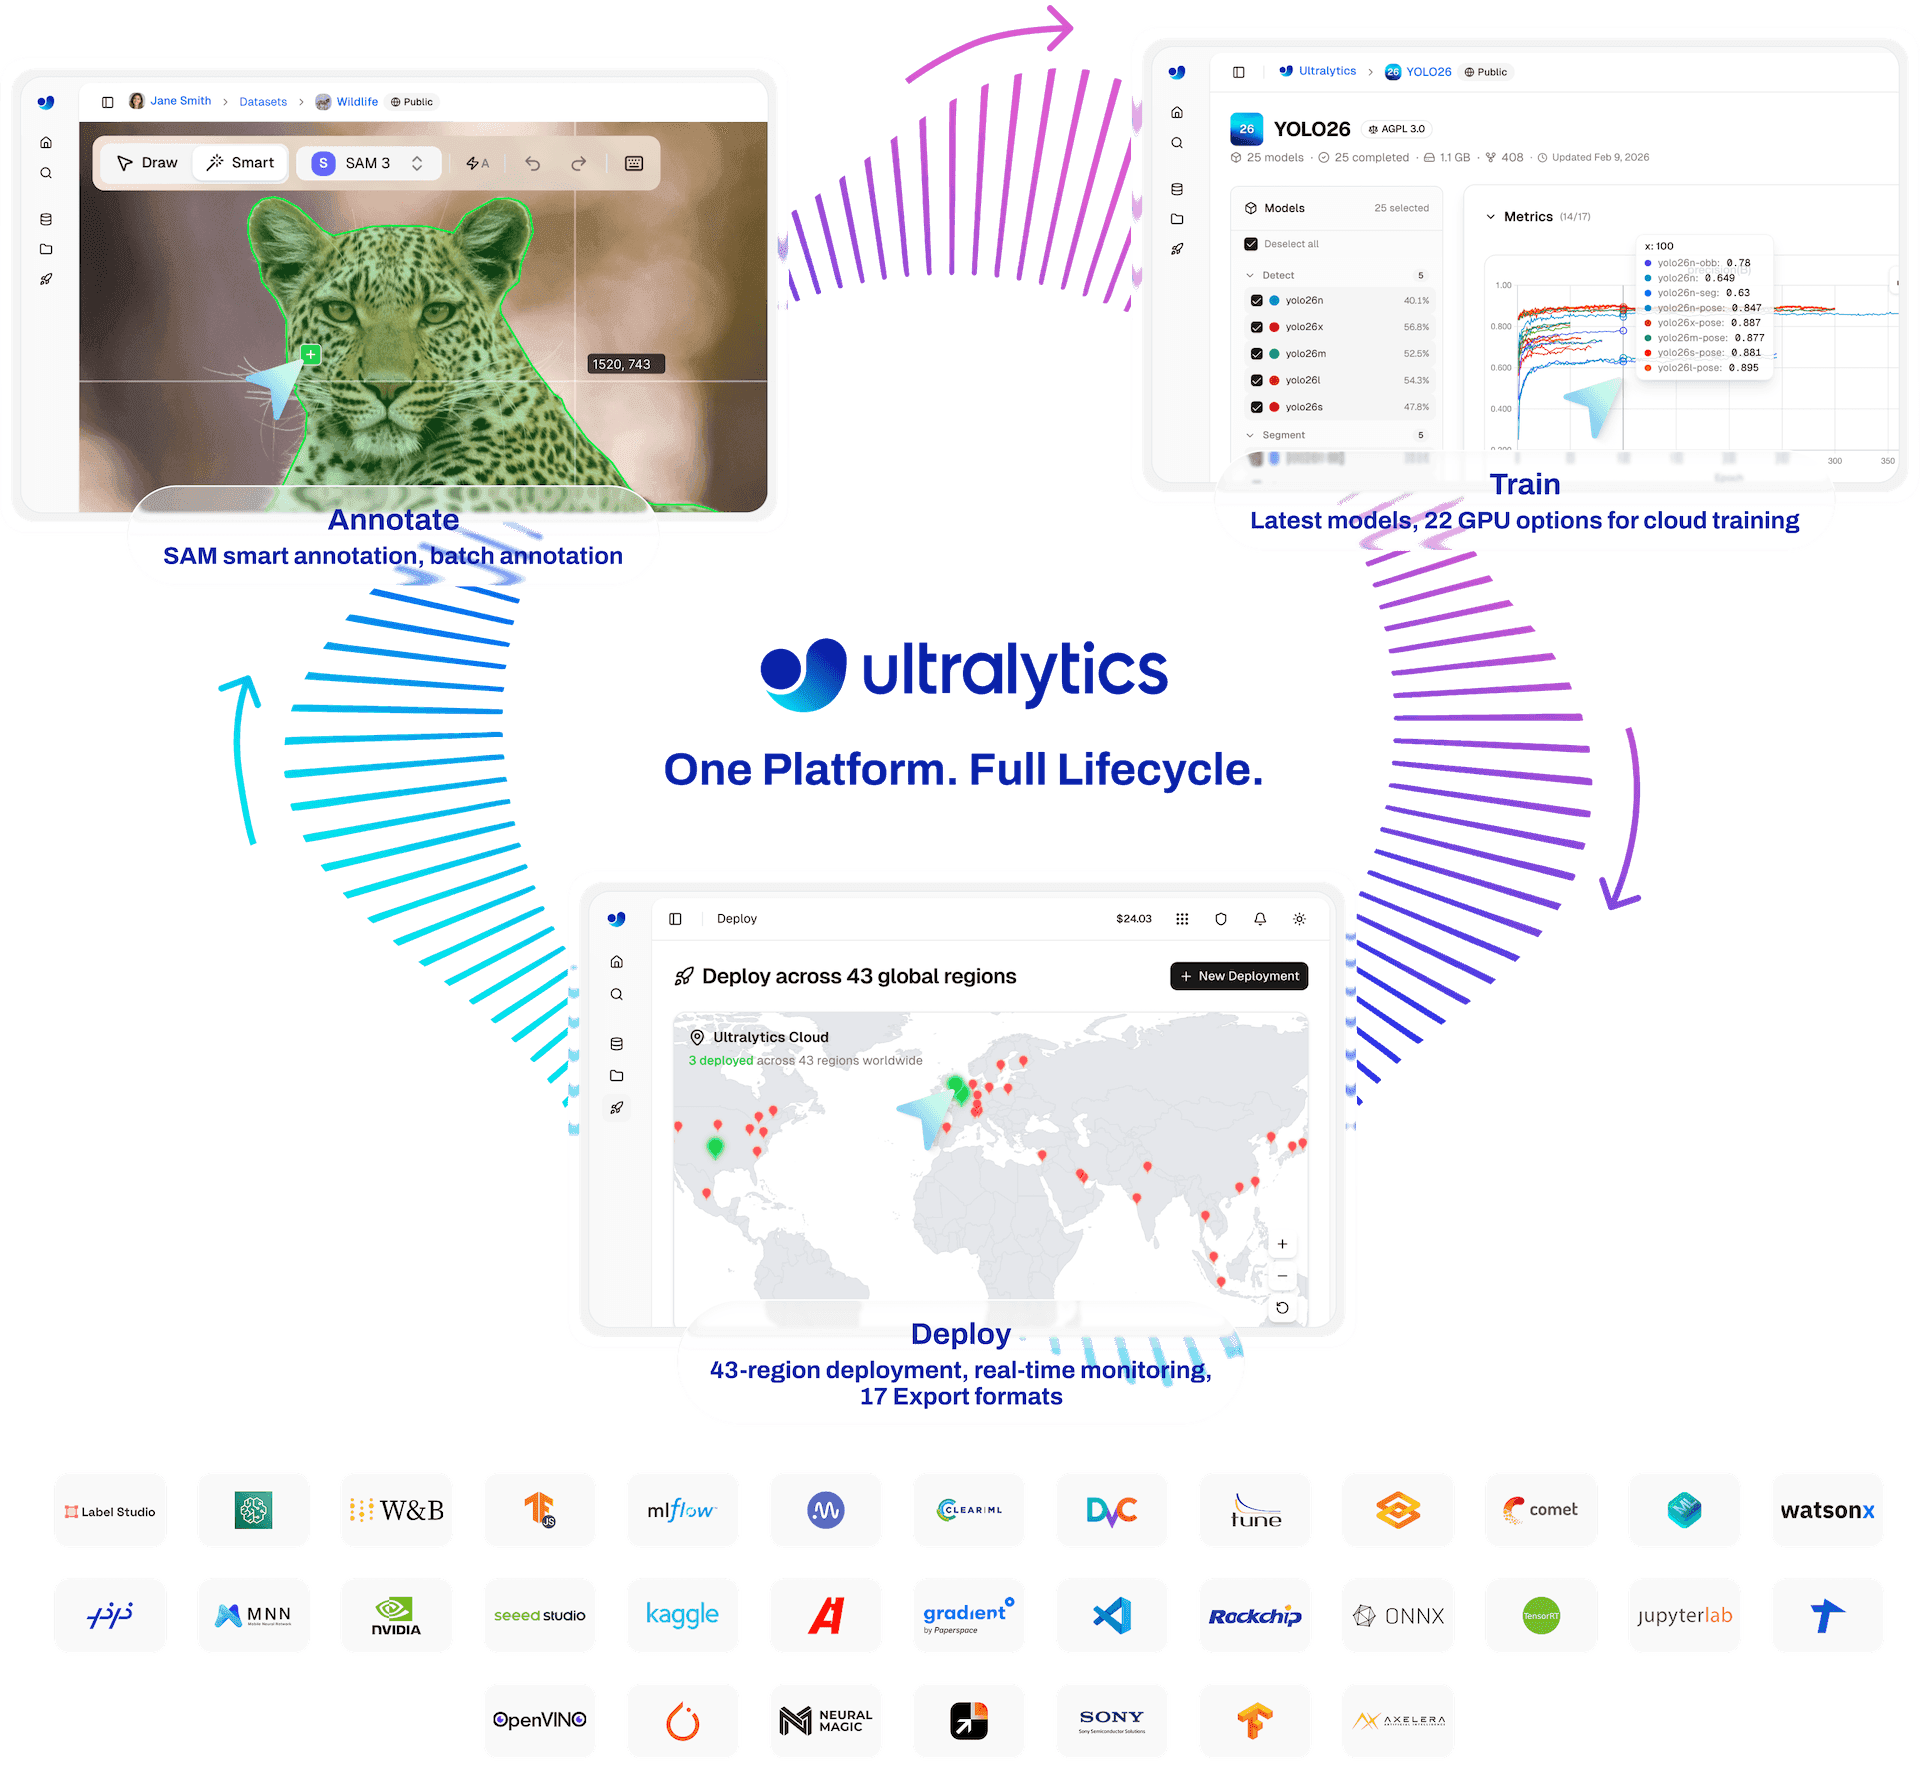
多格式导出——这是 YOLOv3 至今仍有生命力的核心原因。export.py 可导出 TorchScript、ONNX、TensorRT(.engine)、CoreML、OpenVINO,并支持 FP16/INT8 量化。硬件厂商们(Coral TPU、树莓派、Intel NUC、Jetson、Apple 生态)的早期适配几乎都绕不开这条路。
容器化:utils/docker/ 下有三个 Dockerfile——Dockerfile(pytorch/pytorch:2.14.1-cuda13.2-cudnn9-runtime 基础镜像,CUDA 优化)、Dockerfile-cpu(CPU 版)、Dockerfile-arm64(ARM64 版)。GitHub Actions 的 docker.yml 会自动构建并推送到 Docker Hub(ultralytics/yolov3:latest / latest-cpu / latest-arm64)。这意味着部署到服务器的最短路径是 docker pull ultralytics/yolov3:latest-cpu,无需折腾依赖。
工程规范:CI 矩阵覆盖 Ubuntu/Windows/macOS × Python 3.8/3.14,用 uv 管理依赖,还有 CLA 检查、格式检查、依赖机器人(Dependabot)、每日定时跑。代码风格现代化程度在这个"老项目"里出奇地高。
现实场景:安防摄像头的实时人流统计、产线上的零件缺陷检测、仓储货架盘点、野外相机(GlobalWheat2020 那类作物计数),以及"想在自己的设备上跑一个检测模型但不想折腾编译"的学习者。
tutorial.ipynb,torch.hub.load 三行跑通,权重自动下载。5 分钟出结果。pip install -r requirements.txt → python detect.py --weights yolov3-tiny.pt --source im.jpg。需要 Python ≥3.8 与 PyTorch ≥1.8,CPU 即可跑 tiny 版。AGPL-3.0 许可:这是最实际的商业约束。README 顶部明确写着"商业使用需申请 Enterprise License"。AGPL 的传染性对闭源 SaaS 产品是重大风险——大量公司因此转向 YOLOv5/8 的 AGPL 版本或 Ultralytics 的商业授权。README 同时提供 AGENTS.md、CLAUDE.md 等 AI 协作说明文件,说明 Ultralytics 也在积极适配 AI 编程助手的工作流。
精度已明显落后:YOLOv3 在 COCO 上约 33.0 mAP@0.5:0.95(YOLOv3-SPP 更高些),而 YOLO11n 已达 39.8 mAP、YOLO26n 更进一步。同等算力下新模型小目标检测优势显著。想要高精度场景,YOLOv3 不是选择。
架构僵化:YOLOv3 的 anchor-based、Darknet-53 骨干在今天已被 anchor-free + decoupled head 全面取代。它不再适合作为新项目的起点。
无 Web UI:仓库没有 Gradio/Streamlit 界面,quick_deploy 只能是 unsupported——所有交互都在 CLI 和 Python API 层面。utils/triton.py 提供了 Triton 推理服务器导出脚本,是最接近"服务化"的路径。
没有单元测试:CI 里的"测试"本质上是端到端冒烟(跑一遍 train/val/detect),没有 pytest 级别的断言覆盖率。
从 2016 到 2026,YOLO 系列的版本号走到了 v26,架构从 anchor-based 走到 anchor-free 再到 NMS-free 的端到端范式。但正因如此,YOLOv3 作为"起点"变得更有价值:它是计算机视觉开源社区共同语法的来源之一——"跑个 YOLO 检测一下"这句话,源头就在这里。
对研发团队而言,这个仓库的真实定位是参考基线与教学蓝本:想知道"一个完整、干净、现代化的小型深度学习项目应该长什么样",看它;要复现 2018 年的检测结果或验证某篇论文的基线,用它;要开发新的生产级检测服务,请直接看 YOLO11/26。
从 10629 个 Star、3413 个 Fork、49 位贡献者(按 GitHub Link header 统计)来看,这个数字背后站着几代工程师的共同记忆。它不性感,但极其可靠——就像一座建成于 2018 年、至今仍在通行的桥。