
awesome-ai-testing
tugkanboz/awesome-ai-testing加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个深夜:你的端到端测试流水线第三次红了,但不是因为功能坏了,而是登录页面的按钮从 #submit 改成了 button[type=submit]。你盯着 4000 行自动化脚本,不知道该改哪一行,更不敢把这条脆弱的选择器链路交给下一次发版。
这正是土耳其测试自动化工程师 Tuğkan Boz 在 2026 年 5 月创建这个仓库时面对的问题。他的解法不是写一个更聪明的测试框架——而是把整个行业正在造的这 172 个工具、平台和方法摊开在桌面上,让 QA 工程师自己决定该押注哪一条技术路线。
截至目前,这个名为 awesome-ai-testing 的清单收获了 160 个 Star、63 个 Fork,18 位贡献者参与,仓库采用 CC0-1.0(公共领域贡献)许可。
严格说,这个仓库里没有一行代码。根目录只有 README.md、LICENSE、contributing.md 和一个 GitHub Actions 工作流,整个项目体量仅 72 KB,GitHub 甚至没能识别出它的主语言。
但它的信息密度极高:25 个主题分类、195 个条目、其中 150 个带徽章的工具条目(🆓 开源 / 💰 商业 / 🆓💰 开放核心),覆盖 64 个不同域名,其中 86 个条目托管在 GitHub 上。
分类设计体现了作者对测试流程的完整理解——从「测试用例生成」「自愈框架」「MCP 测试」「自然语言编写用例」,一路延伸到「LLM-as-Judge 评估」「失败分析与 flaky 检测」「AI 测试数据生成」「Mock 与服务虚拟化」,最后收在「LLM 系统自身测试」(红队、越狱、幻觉检测)和「浏览器自动化」上。这不是按产品名堆砌,而是按测试工程师一天的工作顺序编排。
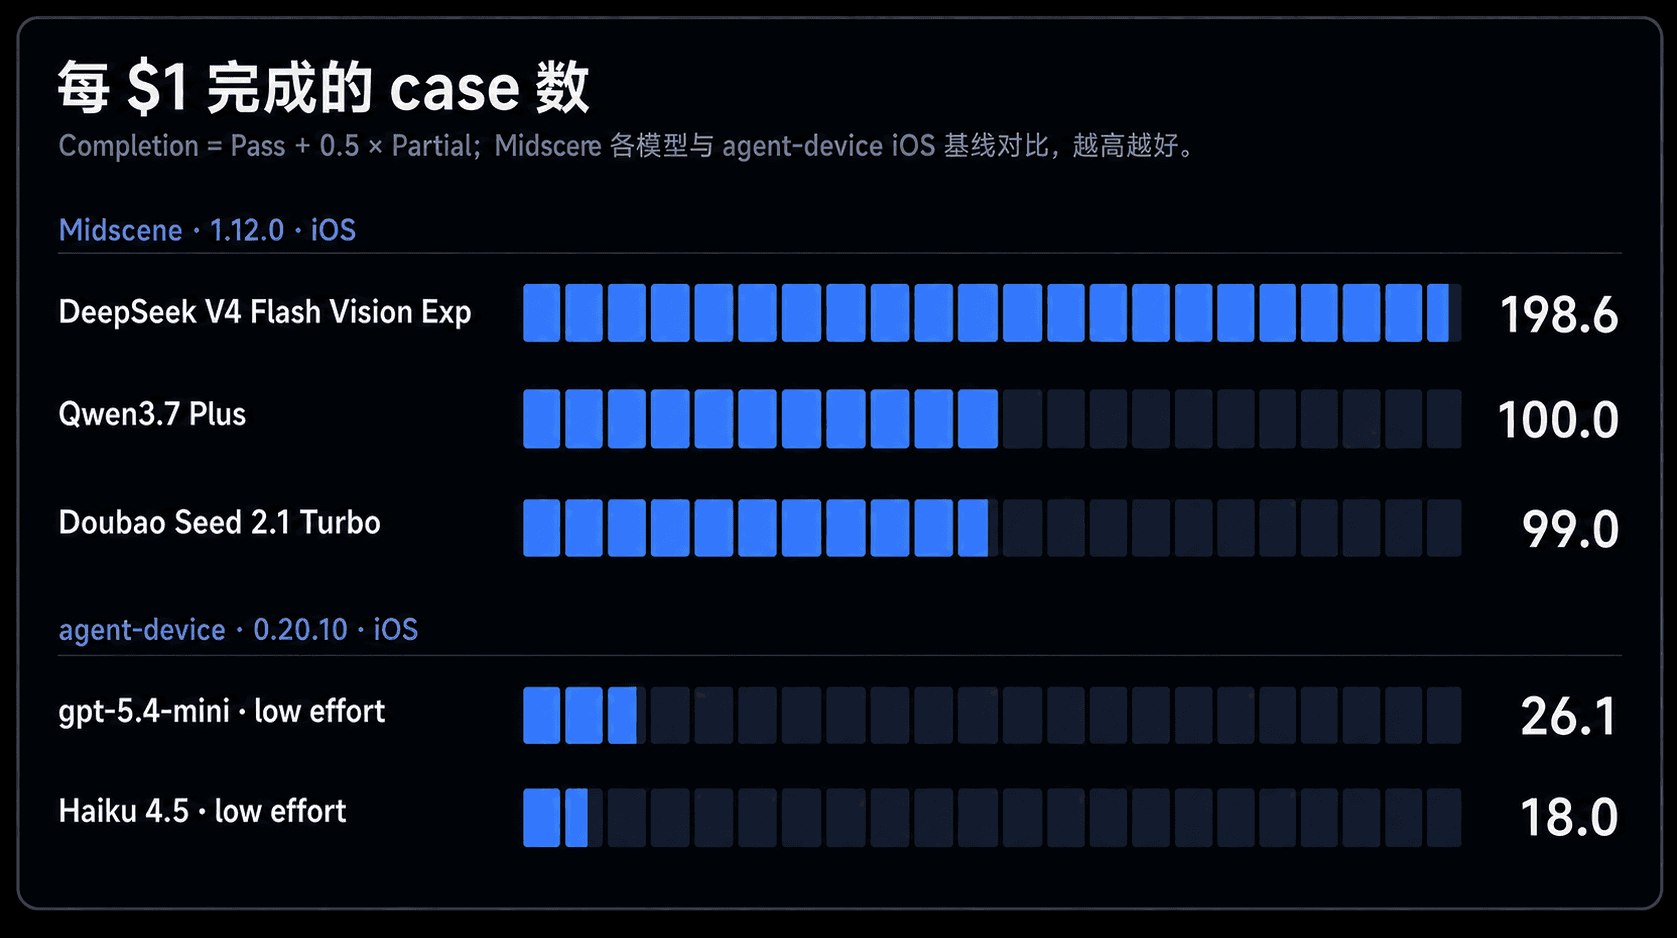
图中所列的 Midscene.js 只是清单里 150 个工具中的一个——它的自然语言 UI 自动化基准测试,正好说明了这份清单想传递的信息:AI 测试已经进入「可量化、可对比」的阶段。
如果 Awesome List 是「菜谱索引」,那这份清单就是「食材供应商黄页」。它不告诉你菜怎么做,但把每一家供应商的定价模式(开源/商业/开放核心)、擅长领域和社区活跃度标注得一清二楚。
最有参考价值的是它的「自我修饰」机制:contributing.md 明确列出「我不会合并的东西」——两年无提交、纯营销落地页、重复条目、没有明确 AI 组件的项目。这是一个持续维护清单能活过一年以上的关键,也是它区别于那些一炮而红后再无人问津的 AI 工具合集的地方。
清单里的 18 个浏览器自动化项目(Browser Use、Stagehand、Skyvern、Lightpanda 等)构成了 AI Agent 时代的「浏览器基础设施层」,作者把它们与测试框架并列收录,等于在提示:测试工具和 Agent 工具正在合流。
使用者不需要 clone、不需要 pip install、不需要 Docker。git clone 后用任意 Markdown 阅读器打开即可,或者直接在 GitHub 网页上读。CI 上只用一行 npx awesome-lint 做格式与链接校验。
这也意味着它的「部署」属性接近于零——它不能、也不打算作为服务运行。它是知识产品,不是软件产品。
第一,作者同时是自己清单的供应商。 清单收录了 llm-security-scanner——作者本人主导的红队工具,虽然描述客观且符合收录标准,但在商业利益上存在结构性偏向,读者需要自行打折。
第二,时效性靠人力维持。 仓库最后提交停留在 2026 年 10 月 27 日,AI 测试领域半年就是一代工具;商用工具的定价、功能甚至存续状态在清单里都可能已经过期。清单中没有标注每个条目的最后核验时间。
第三,条目质量参差。 部分商用工具只有一句营销式描述(例如「AI-native 端到端测试平台,自动编写、运行、维护测试」),读者无法据此判断真实能力,需要自行试用验证。
这份清单真正的价值在于它揭示的结构:AI 测试已经分化出明确的层次——底层是 Playwright/Chrome DevTools MCP 提供的浏览器与 MCP 控制能力,中层是自愈框架与自然语言用例编排,上层是 LLM 评审、幻觉检测、安全红队与失败归因的「质量保障面」。
同时,一个耐人寻味的对照是:清单把 OpenAI Evals 明确标注为「不再积极维护,但仍被广泛用作参考」,把 Browser MCP 标注为「自 2025 年中以来维护活动有限」。给存量项目标注停更状态,本身就是一种质量治理。
这也是为什么这份只有 72 KB、零代码的仓库能拿到 160 Star:当所有人都在造新的 AI 测试工具时,QA 工程师更需要一个可信的、高信噪比的「地图」。
tugkanboz/awesome-ai-testing 不是一个可以被「部署」的开源项目,它是一份基础设施级的知识索引。对研发团队而言,它的价值在于把「AI 能不能自动写测试」这个模糊命题,拆解成 25 个可分别调研、可分别落地的小切口;同时它也是一个提醒:在这个赛道,工具淘汰速度极快,选对工具之外,更要持续跟踪工具的存活状态。
