
toon
toon-format/toon加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一个场景:你是一个 AI 应用开发者,需要在每次调用大语言模型时,向它传递一份包含 500 条客户记录的结构化数据。JSON 是最自然的选择——你从数据库里导出数据,几行代码序列化,然后塞进提示词里。但问题来了:这些数据里,真正有价值的"内容"可能只占 30%,剩下 70% 都在重复着同样的字段名、括号、引号、逗号——这些语法噪音对人类来说可以忽略,对 token 计费系统来说却一分不少。
TOON(Token-Oriented Object Notation)就是为了解决这个问题而生的。
TOON 是由前端开发者 Johann Schopplich(GitHub: @nuqleo)提出并开源的数据序列化格式,专门为 LLM 提示词场景优化。它的核心理念是:**JSON 是给人写程序用的,TOON 是给 AI 模型读的。**两者编码的数据完全等价,但 TOON 的文本表达形式更贴合语言模型的"思维方式"。
TOON 的语法融合了两种经典格式的优点:
{},减少结构噪音一个简单对比:
JSON(约 117 tokens):
{
  "location": { "city": "Berlin", "country": "DE" },
  "alerts": ["frost", "wind"],
  "forecast": [
    { "day": "Mon", "temp": { "min": -2, "max": 4 }, "condition": "snow" },
    { "day": "Tue", "temp": { "min": 1, "max": 7 }, "condition": "cloudy" }
  ]
}
TOON(约 66 tokens):
location:
  city: Berlin
  country: DE
alerts[2]: frost,wind
forecast[3]{day,temp{min,max},condition}:
  Mon,-2,4,snow
  Tue,1,7,cloudy
注意看:数组前的 [3] 声明了元素数量,{day,temp{min,max},condition} 声明了字段列表。模型不仅知道数据内容,还知道"有多少行"和"有哪些列"——这是 JSON 无法直接表达的语义信息。
TOON 官方的基准测试覆盖了 244 道数据检索题,横跨 GPT-5 Nano、Gemini 3.6 Flash、Claude Haiku 和 Grok 4.5 四个模型,结果相当有说服力:
| 格式 | 准确率 | 平均 Token 数 | Token 效率(准确率/1K tokens) |
|---|---|---|---|
| TOON | 72.2% ±2.8 | 2,474 | 29.2 |
| JSON compact | 69.0% ±2.9 | 2,892 | 23.8 |
| YAML | 70.1% ±2.9 | 3,487 | 20.1 |
| JSON (格式化) | 71.4% ±2.8 | 4,308 | 16.6 |
| XML | 70.7% ±2.9 | 4,909 | 14.4 |
TOON 在准确率略高于标准 JSON 的同时,token 消耗减少了 42.6%。
但这还不是最震撼的场景。在 Uniform 数组(字段完全相同的对象数组)上,TOON 的优势会被进一步放大:一份 500 行的电商订单数据,JSON 需要 11,842 tokens,TOON 只需要 4,617 tokens,节省了 61%。在 GitHub Top 100 仓库数据上,也实现了 41.7% 的 token 节省。
值得注意的是,2026 年 arXiv 的一篇论文 Notation Matters: A Benchmark Study of Token-Optimized Formats in Agentic AI Systems 对 TOON 进行了更严格的评估。在 Agentic Pipeline(多轮工具调用循环)中,TOON 的 token 节省仍有 2-18%,但准确率出现了级联下降:在多轮场景下,一次解析失败会触发额外的推理迭代,额外的思考内容反过来抵消了单次调用节省的 token,最终整体收益被侵蚀。论文建议在多轮 Agent 场景中谨慎使用 TOON。
这并不意味着 TOON 不好,而是提醒我们:格式优化的收益是有上下文的。单轮数据注入场景(如 RAG、Few-shot 示例)TOON 表现优异;复杂多轮 Agent 场景需要结合实际情况评估。
TOON 的参考实现托管在 toon-format/toon,是一个 TypeScript 单体仓库(pnpm workspace),包含两个子包:
@toon-format/toon:核心库,导出 encode()、decode()、encodeLines() 等函数@toon-format/cli:命令行工具,支持 JSON ↔ TOON 互转、token 统计、streaming 模式代码质量方面:项目使用 Vitest 单元测试、ESLint 代码检查、Commitlint 规范提交信息,并遵循 automd 自动文档生成规范。tsdown 负责 TypeScript → JavaScript 的编译,输出 ESM 格式。同时通过 GitHub Actions 配置了 CI/CD 流程,每次提交自动运行测试和类型检查。
开发者体验(DX)打磨得相当到位:encodeLines() 支持流式编码,对大文件(数千行记录)可以边读边编码,避免一次性加载整个 JSON 字符串到内存——这对准备大规模上下文窗口的场景尤为重要。
TOON 的使用门槛极低。安装 CLI 只需一行:
npm install -g @toon-format/cli
# 或者免安装直接用
npx @toon-format/cli input.json -o output.toon
在代码中引入同样简单:
import { encode, decode } from '@toon-format/toon'

const jsonData = await fetch('./data.json').then(r => r.json())
const toon = encode(jsonData, { indentSize: 2, delimiter: ',' })

// 解码 LLM 返回的 TOON
const result = decode(llmResponse, { strict: true })
strict: true(默认开启)会在解析时检查 [N] 数量是否与实际行数匹配、缩进是否正确、转义是否合法——这能有效捕获 LLM 输出被截断或格式错误的情况。
TOON 不是银弹,有几个明显的适用边界:
TOON 的出现折射出一个更大的趋势:随着 AI 模型成为数据的主要消费者之一,我们可能需要重新设计数据格式,使其更适合机器阅读而非人类手工编写。 传统序列化格式(JSON、XML)诞生于 application-to-application 数据交换的时代,它们服务的对象是运行时解析器,而运行时解析器不关心 token 成本。
TOON 打开了这扇门。它不是要替代 JSON(JSON 在 API 领域仍然是王者),而是在"AI 上下文注入"这个新场景里提供了更优解。随着 AI 应用越来越深入各个行业,这种场景会越来越常见——TOON 的思路值得所有 AI 应用开发者关注。
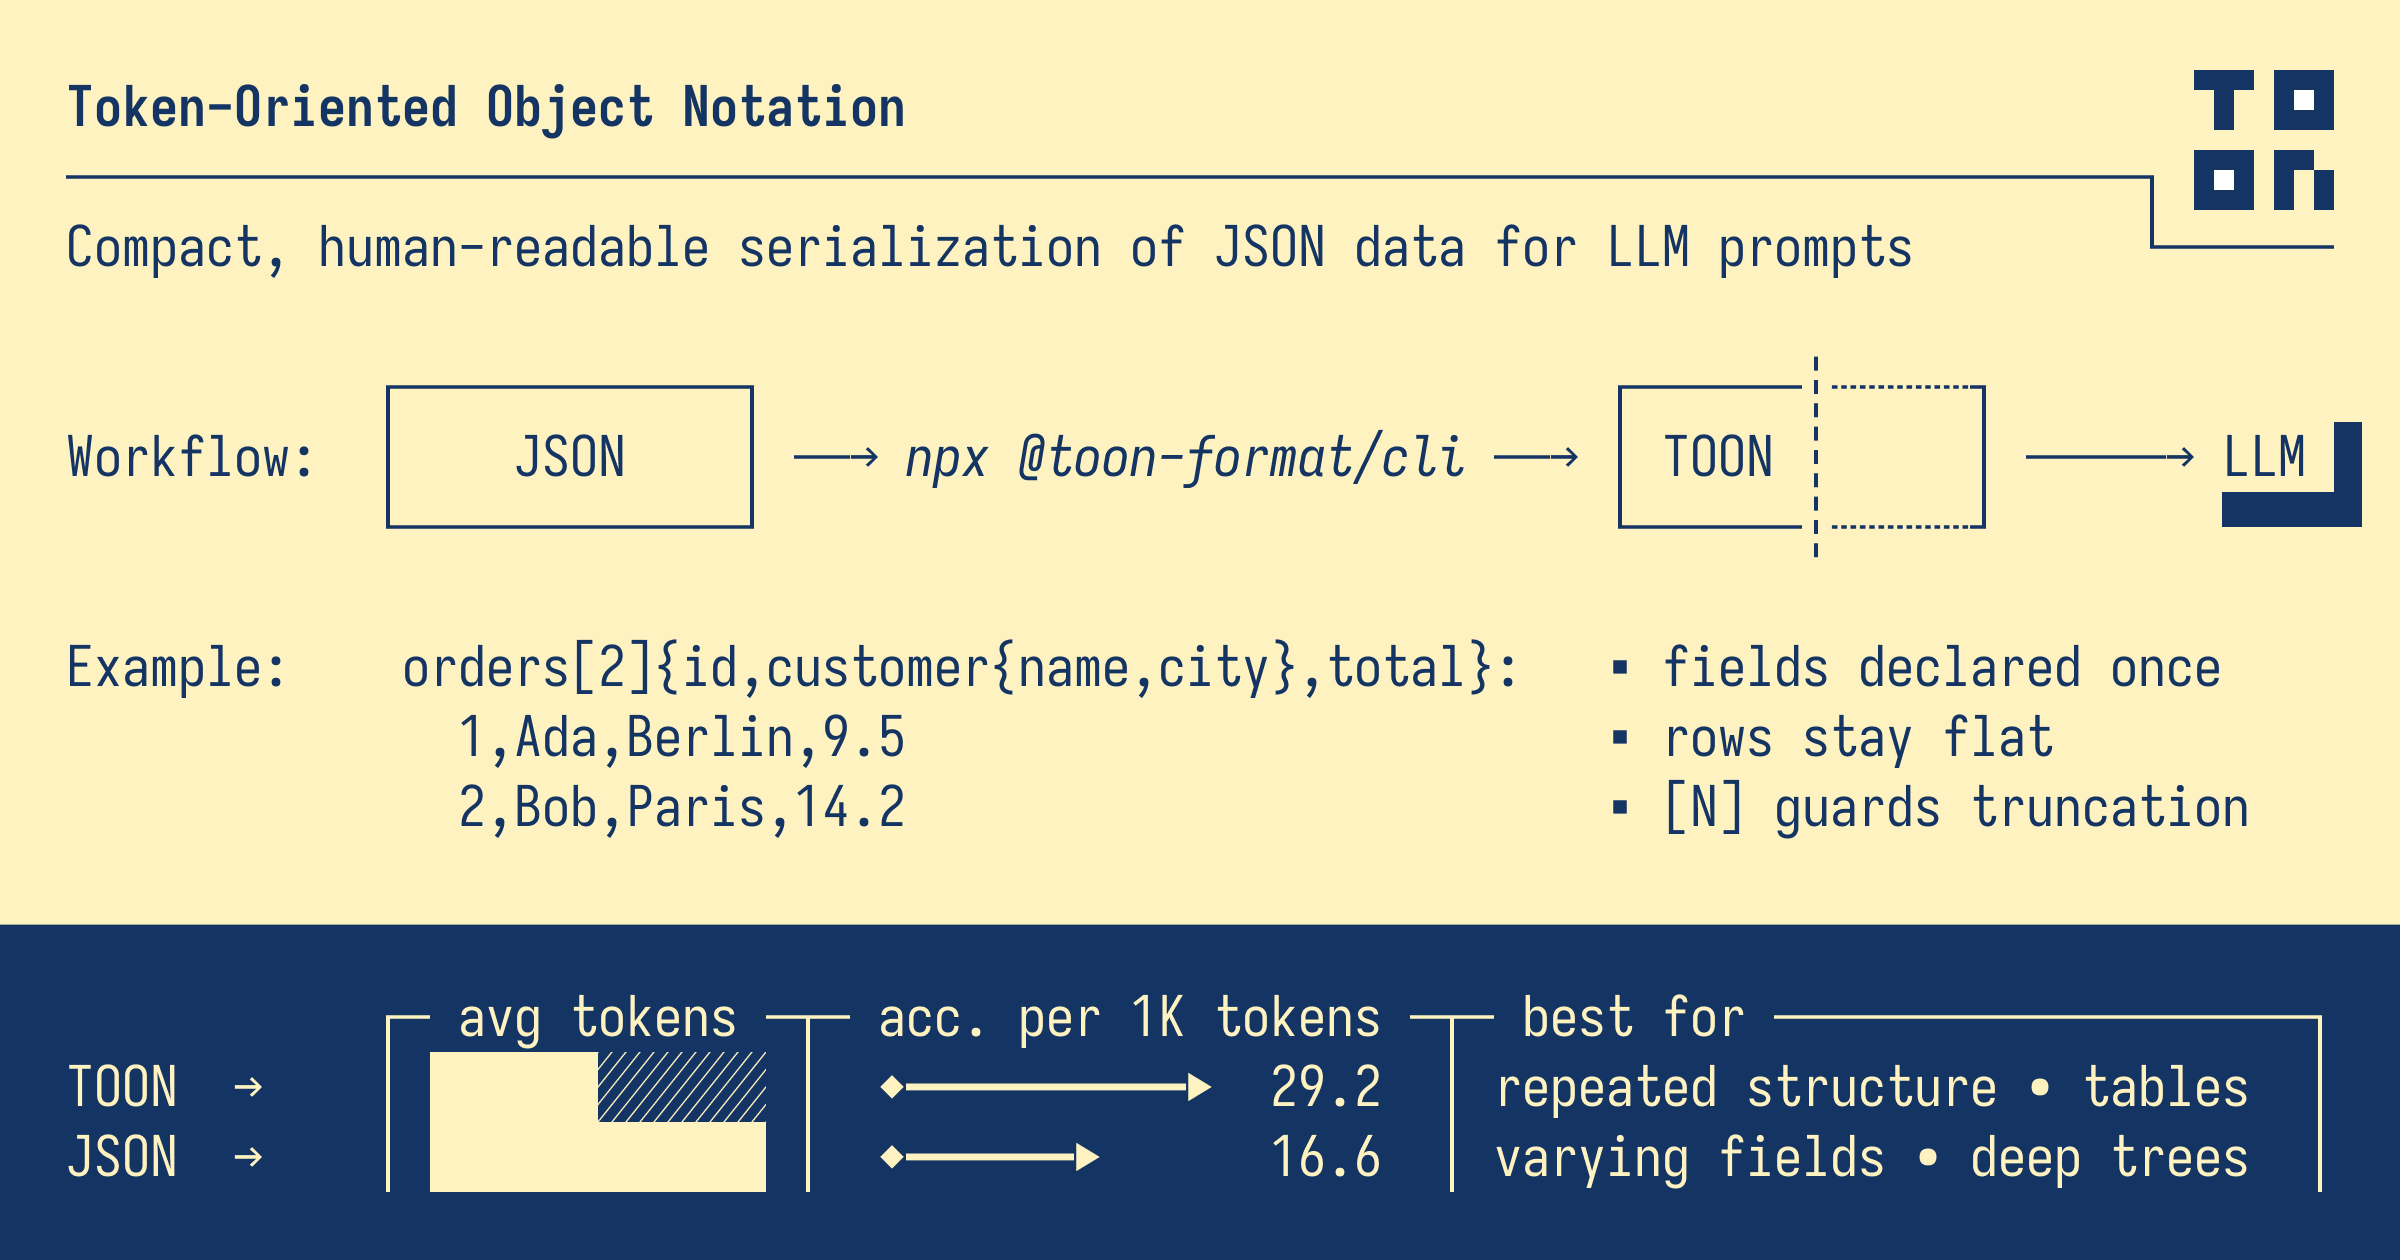 TOON 官方概览图,展示了 JSON 与 TOON 的 token 效率对比
 TOON 项目 Twitter 分享图
 TOON 官方 Logo
