
notebooklm-py
teng-lin/notebooklm-py加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
假设你是一名通信协议工程师,手上有一堆几十页的技术规范 PDF、一批同事分享的内部 Wiki 链接,以及十几场技术评审的会议录音转写稿。你的日常痛点不是"读不懂",而是"读不完、读散了、读完之后没法被 AI 智能体复用"。
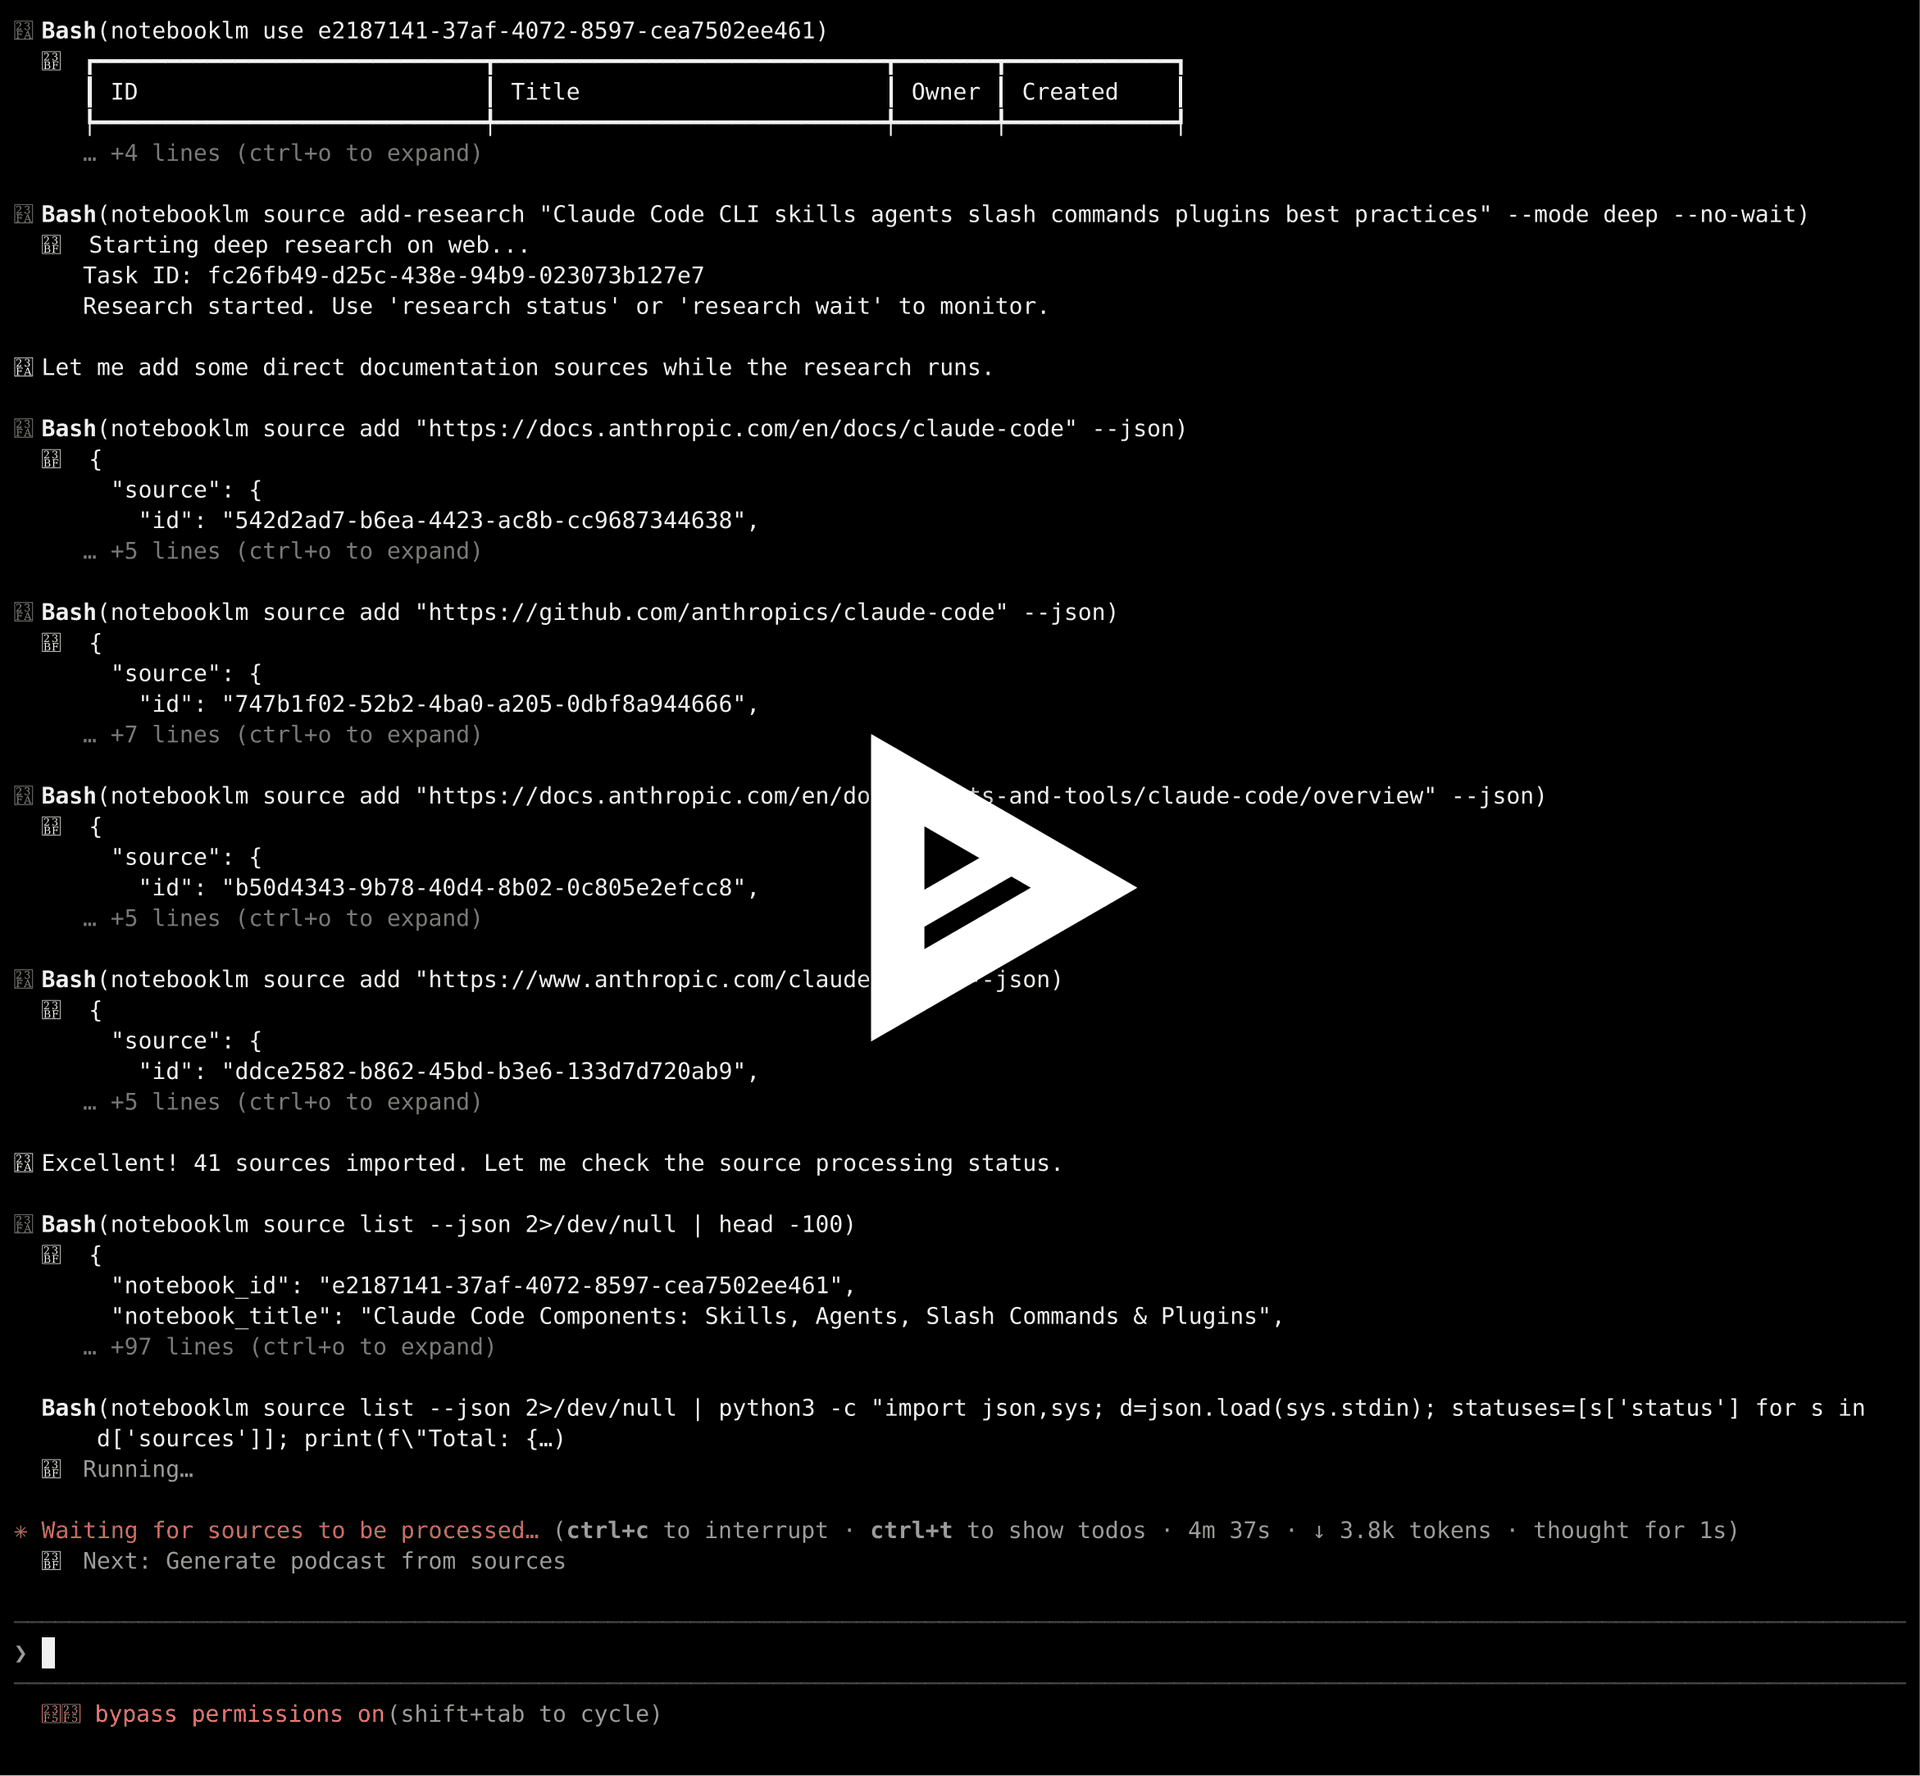
传统做法是:把这些材料一份份丢进 NotebookLM 的网页版,然后在网页里提问、复制答案、再手工整理成一份结论文档。整个链路里,AI 智能体(Claude Code、Codex 这类)完全插不上手——它无法自己创建一个笔记本、无法批量导入材料、无法在需要时触发生成一份播客或一份测验。
notebooklm-py 就是来拆掉这道墙的。它把 Google 的 Gemini Notebook(原 NotebookLM)服务包装成三层形态:Python 异步 API、命令行工具 notebooklm、以及可直接挂进 Claude Code / Codex / OpenClaw 的技能包(SKILL.md)。更关键的是,它暴露了一批官方网页界面根本不提供的能力——批量下载所有生成的产物、测验/闪卡的多格式导出、思维导图的 JSON 树提取、研究模式自动导入检索到的来源。
作者 Teng Lin 在 README 里把这个模式称为"零 token 的研究与综合层":让 NotebookLM 在服务端把昂贵的阅读和推理做完,智能体只负责编排和最后的润色。
2026 年 7 月,Google 把 NotebookLM 正式更名为 Gemini Notebook,产品形态保持不变,同时也能在 Gemini App 内访问。这个项目在 2026 年 1 月 7 日创建,几乎是在更名之前就起步了非官方客户端的逆向工作。到 2026 年 10 月 30 日,仓库已发布 v0.8.6 版本,累计 2574 次提交、38 位贡献者、超过 2 万星标。
它踩准了一个更大的趋势:2026 年真正的竞争不在"谁的模型更强",而在"谁能把模型接进工作流"。这个项目没有训练任何模型,没有跑 GPU,它的全部价值在于做"最后一公里"的管道工程——认证、协议、产物下载、错误分类、重试、多后端兼容。
如果把 NotebookLM 的网页版类比成一家只接受当面委托的办事窗口:你得亲自跑过去、排队、填表、然后把纸质结果带回来。
notebooklm-py 相当于给你配了一个"跑腿秘书 + 标准表单系统":
项目默认使用 Web 端的 batchexecute 传输协议(内部 RPC 方法 ID 全部逆向整理在 docs/rpc-reference.md 中,如 wXbhsf=列出笔记本、R7cb6c=生成产物)。同时提供一个可选的 Android 后端,走 NotebookLM 移动端 gRPC 服务 + Bearer 认证,通过 NotebookLMClient(backend="android") 或 CLI --backend android 切换。这在后端被 Web 端封锁时是一条退路。
架构上最值得称道的一点是分层:CLI(Click)、MCP(FastMCP)、REST(FastAPI)三个前端都只是 _app/ 这一层"传输无关业务逻辑"的适配器——ID 校验与解析、计划构建、状态投影、重试与等待编排、错误分类、诊断信息都在这一层共享。文档里用 40 张结构图/时序图把这套边界画得极其清楚。
notebooklm login 打开浏览器登录;--browser-cookies chrome 复用已登录浏览器的 Cookie;--browser msedge 兼容要求 Edge 做 SSO 的企业环境;headless extra,基于 gpsoauth):从持久化的 Google 主令牌换取网页 Cookie,无需每次开浏览器,适合服务器与 cron 场景。配套还有 auth check --test、auth refresh(Cookie 保活)、auth inspect、多账号 profile 切换等运维命令。
研究侧:批量导入来源(URL / PDF / YouTube / Google Drive / 纯文本)、Fast Research 与 Deep Research(含 --import-all 自动导入)、来源刷新与新鲜度检查、相关段落检索。
生成侧:音频概览(播客)、视频、白板风格视频、文档级视频、幻灯片、测验、闪卡、信息图、数据表、思维导图(交互式 Studio 地图 / 笔记支撑的 JSON 树两种)。
下载侧:MP3 / MP4 / PDF / PNG / CSV / JSON / Markdown 全格式落地,测验与闪卡支持多格式导出,并可导出到 Google Docs / Sheets。
1653 个 Python 文件中 549 个在 src/、1039 个在 tests/——测试代码体量接近源码的两倍。测试体系包含 VCR 录制回放(cassettes)、故障注入服务器、离线资格测试(offline-qualification)、覆盖阈值检查、公开 API 兼容性白名单(api-compat-allowlist.json)、认证导入图审计等。CI 有 16 个 workflow,包含 CodeQL 安全扫描、依赖审计、认证补丁审计、RPC 健康检查、nightly 与 fault-stress 压测。
| 方式 | 门槛 | 说明 |
|---|---|---|
| Python API | 低 | pip install notebooklm-py,但需先完成一次 Google 认证 |
| CLI | 低 | 推荐 uv tool install "notebooklm-py[browser]",首次运行会下载约 170MB Chromium |
| MCP Server | 中 | 需 pip install "notebooklm-py[mcp]",实验性特性,工具面不受 semver 保证 |
| 远程 MCP(Docker) | 中高 | 需要 Bearer/OAuth 配置、profile 目录挂载、以及域名或 Tailscale 通道 |
真正的门槛不在安装,而在认证:这个库操作的是你的 Google 账号,必须有一个已登录的浏览器环境或有效的主令牌,且 Cookie 有保活周期,服务器场景需要额外挂 cron 做 auth refresh。
非官方身份是最大风险源。README 首屏就挂着"⚠️ Unofficial Library - Use at Your Own Risk",明确声明与 Google 无关联,接口随时可能变。作者自己的建议是"适合原型、研究和个人项目"。对企业生产环境而言,这是一条需要架构评审签字的依赖。
依赖逆向协议,长期维护成本由用户承担。整个 Web 后端建立在 batchexecute 的内部 RPC ID 上,Google 一次内部调整就可能让一批方法失效。项目用兼容性白名单 + RPC 健康检查来缓解,但无法根治。
安全边界敏感。项目直接管理 Google 账号凭据,因此提供了独立的 SECURITY.md、凭据脱敏模块(_redact.py)、密钥管理(_secrets.py)、非 root 容器用户、以及 0.0.0.0 绑定下的 fail-closed 门禁。但对于企业审计,账号 Cookie 落盘仍然是需要重点评估的环节。
配额限制不可控。NotebookLM 按账号层级限制笔记本数、来源数、Studio 产物数,批量任务随时可能撞墙(项目里有 docs/quota-limits.md 和 notebooklm usage 命令专门对付这件事)。
实验性组件占比不低。MCP Server、REST Server 都标注为实验性,Android 后端也是 opt-in 的新路径。
这个项目代表了一类正在成型的开源形态:"服务逆向 + 智能体适配"的中间层。它不训练模型、不提供算力,而是把一个封闭的 SaaS 产品改造成可编程、可编排、可被智能体驱动的组件。
从数据上看,它在 2026 年 1 月到 10 月的十个月里从零涨到 2 万星标、2667 个 fork,版本从 0.1.1 一路迭代到 0.8.6 仍在高速演进——这说明市场对"把 AI 产品接进 Agent 工作流"的需求非常迫切。
更有意思的是它提出的"零 token 记忆层"和"自验证技能"两个用法:让 NotebookLM 生成测验当作 Agent 技能的评测集,用 NotebookLM 自身的输出当作 Ground Truth。这种"用产品本身构建产品自身的验证闭环"的思路,可能是比 API 封装本身更有长期价值的部分。
分析时间:2026-10-31 | 数据来源:GitHub API(仓库快照 v0.8.6 / commit 956400a)| Star 数会随时间变化,请以 GitHub 实时数据为准
