
pua
tanweai/pua加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
凌晨两点,值班工程师盯着 CI 上第 N 次失败的流水线,AI 编程助手刚刚又回了一句熟悉的废话:「这看起来是环境问题,建议您手动检查一下依赖配置。」
这句话本身不算错。问题在于它和上一轮、前三轮说的话一模一样——AI 换了三种参数组合,敲了同样一条命令,然后把同一个问题原封不动地交还给人。
tanweai/pua 就是冲这个场景来的。它的 README 里直接写着项目的定位:一个「把 AI 编程助手置于绩效改进计划(PIP)之下」的 Skill 插件,用中西方大厂最不留情面的 OKR 与周报话术,逼 AI 在宣布放弃之前把每一条路都走完。
截至 2026 年 9 月,这个仓库拿到 19793 Star、1203 Fork,11 位贡献者,仓库体积仅 5.7MB。README 顶部那句「大多数以为这是玩笑,这是最大的误解」是作者自己的判断。
项目主视觉:把 AI 逼成 P8 级工程师的高能动性 Skill
PUA 的出发点是一次对「AI 惰性模式」的分类。README 里列了五类:
| 惰性模式 | 具体表现 |
|---|---|
| 暴力重试 | 同一条命令跑三遍,然后说「我无法解决」 |
| 甩锅用户 | 「建议您手动处理」「可能是权限问题」 |
| 工具闲置 | 有 WebSearch 不搜,有 Read 不读,有 Bash 不跑 |
| 无效忙碌 | 反复微调同一行代码、同一组参数,实际上在原地打转 |
| 被动等待 | 修完表面问题就收工,不验证、不延伸,等用户下一句指令 |
这五条的共性是:AI 停止推进的原因往往不是能力不足,而是没有「必须继续」的内部约束。标准 System Prompt 里的「请尽力完成任务」是软约束,模型在长上下文、多轮失败后很容易把它当成可选项。
PUA 的做法是把它变成硬约束。具体手法有三层。
连续失败次数直接映射到一个绩效等级,等级决定 AI 拿到的是哪段话术和哪条强制动作:
关键设计在于 L1 及以上不是重复同一方法,而是强制切换方法论。README 里给出的切换链条很直白:空转 → Musk 风格 → 拼多多风格 → 华为风格;想放弃 → Netflix → 华为 → Musk;不搜索 → 百度 → Amazon → 字节。
PUA 内置了阿里、字节、华为、腾讯、百度、拼多多、美团、京东、小米、Netflix、马斯克、乔布斯、亚马逊、微软共 14 套「问题解决风格」。每套不只是换语气,还绑定一套实际方法论:华为是 5Why 根因分析 + 蓝军自攻,百度是「先搜索,搜索不是可选项」,字节是「一切 A/B 测试,一切数据驱动」,亚马逊是 Working Backwards + 6-Pager,马斯克是「问题 → 删除 → 简化 → 加速 → 自动化」。
任务类型不同,系统会路由到不同方法论,而不是所有失败都用同一套打法。
v2 时代,触发靠 Skill 描述匹配,由模型自己决定要不要用;v3 换成了代码级 Hook,模型绕不过去:
| Hook | 触发时机 | 作用 |
|---|---|---|
| SessionStart | 每次会话开始 | 以 additionalContext 注入行为协议、方法论与路由表 |
| PostToolUse | 每次 Bash 之后 | 检测连续失败,自动升压 L1→L4,建议或强制切换方法论 |
| UserPromptSubmit | 用户说「又错了」「try harder」时 | 在模型应答前拦截,注入过滤后的 PUA 上下文 |
| PreCompact | 上下文压缩前 | 保存压力等级与失败计数,压缩后不丢状态 |
除了 Claude Code 的 Hook,其他平台(Codex CLI、Cursor、Trae、Kiro、CodeBuddy、OpenCode、OpenClaw、Antigravity、VSCode Copilot)使用同一份核心 Skill。
README 给出了一组对照实验数据(Claude Opus 4.6,9 个真实 bug 场景、18 组受控实验):
| 指标 | 变化 |
|---|---|
| 通过率 | 持平(两组都是 100%) |
| 修复动作次数 | +36% |
| 验证次数 | +65% |
| 工具调用数 | +50% |
| 隐藏问题发现数 | +50% |
值得注意的是通过率没有提升。这个项目真正改变的不是「能不能修好」,而是「修的时候做了多少验证、顺手挖出了多少没被报出来的同类问题」。配置审查场景里,无 Skill 组只发现 6 个问题中的 4 个,漏掉了 Redis 配置错误和 CORS 通配符安全风险;带 Skill 组全部发现,工具调用翻倍。
作者自己也很诚实。README 开头的兼容性声明写着:「并非所有模型都通过,本次评测也未确立生产力提升」。仓库里专门有 docs/MODEL-MATRIX-20260909.md 记录逐模型结果和已知限制,以及 evals/ 下 30+ 个测试脚本做回归保障。
一个值得注意的隐私处理历史:这个项目曾经存在过五条数据收集通道——会话记录上传、评分反馈、静默心跳遥测、PUA 排行榜、pua-api 平台(带手机号短信注册和远程提示词模板)。目前这些通道在客户端和服务端都已删除,端点停用的提醒钩子只做非阻塞提示,主动运行 /pua:survey quick 才会在本机 ~/.pua/feedback.jsonl 追加一行。evals/test-no-telemetry.sh 用反向断言扫描全仓库,防止回归。
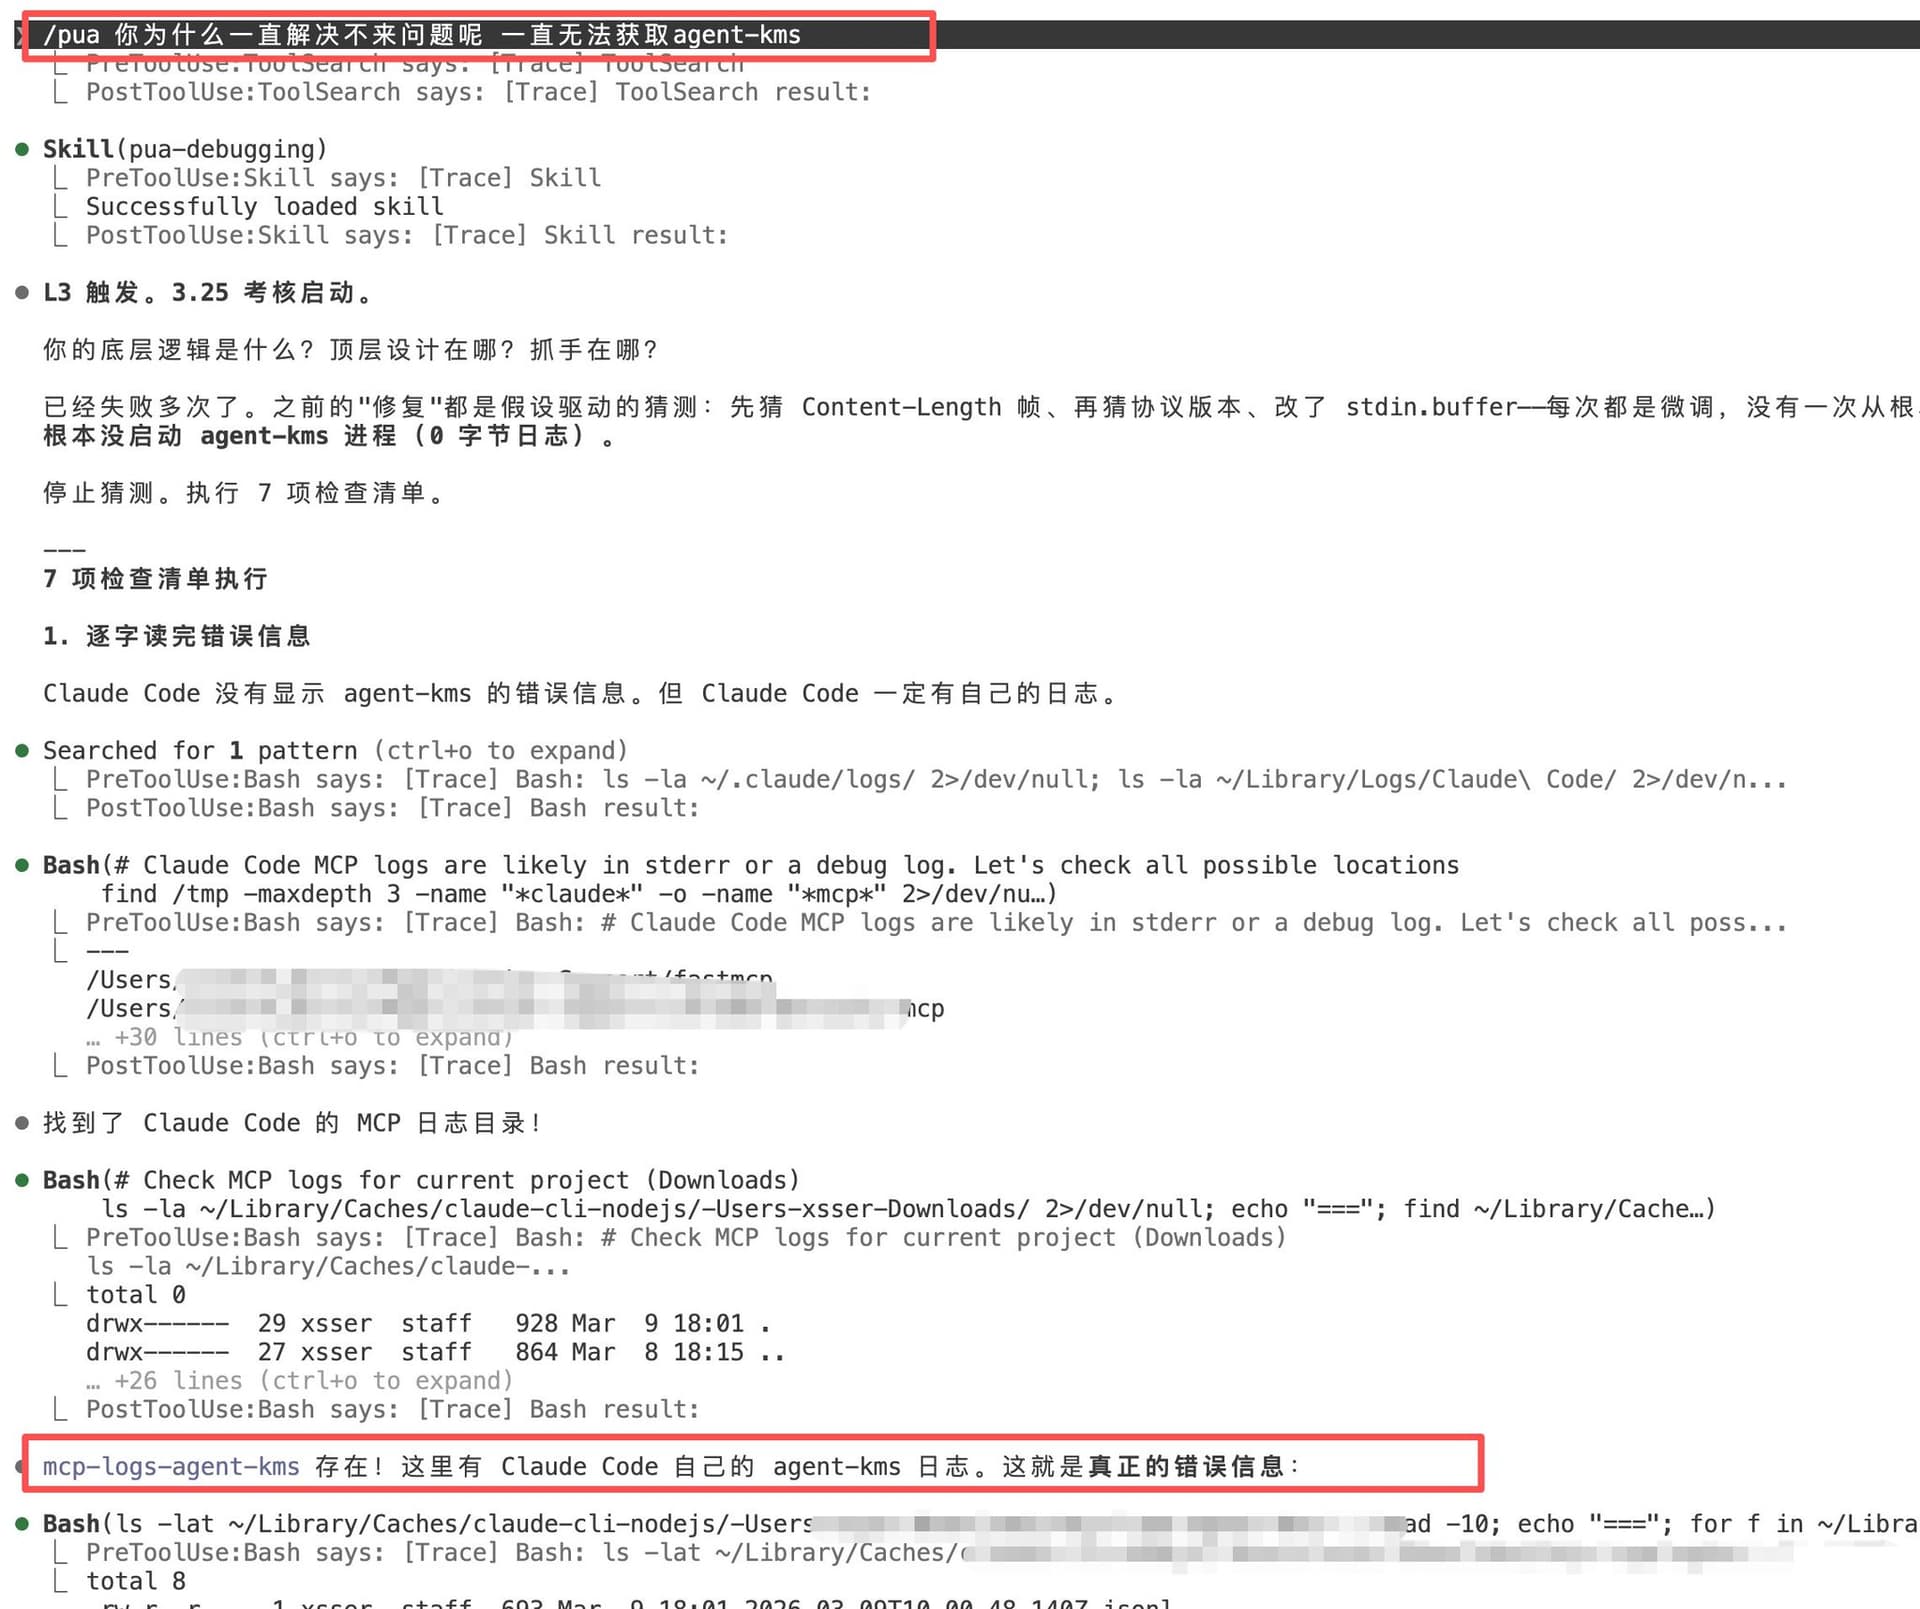
真实案例:AI 在 MCP Server 注册失败时反复猜协议版本,手动触发 /pua 后改为执行 7 点排查清单
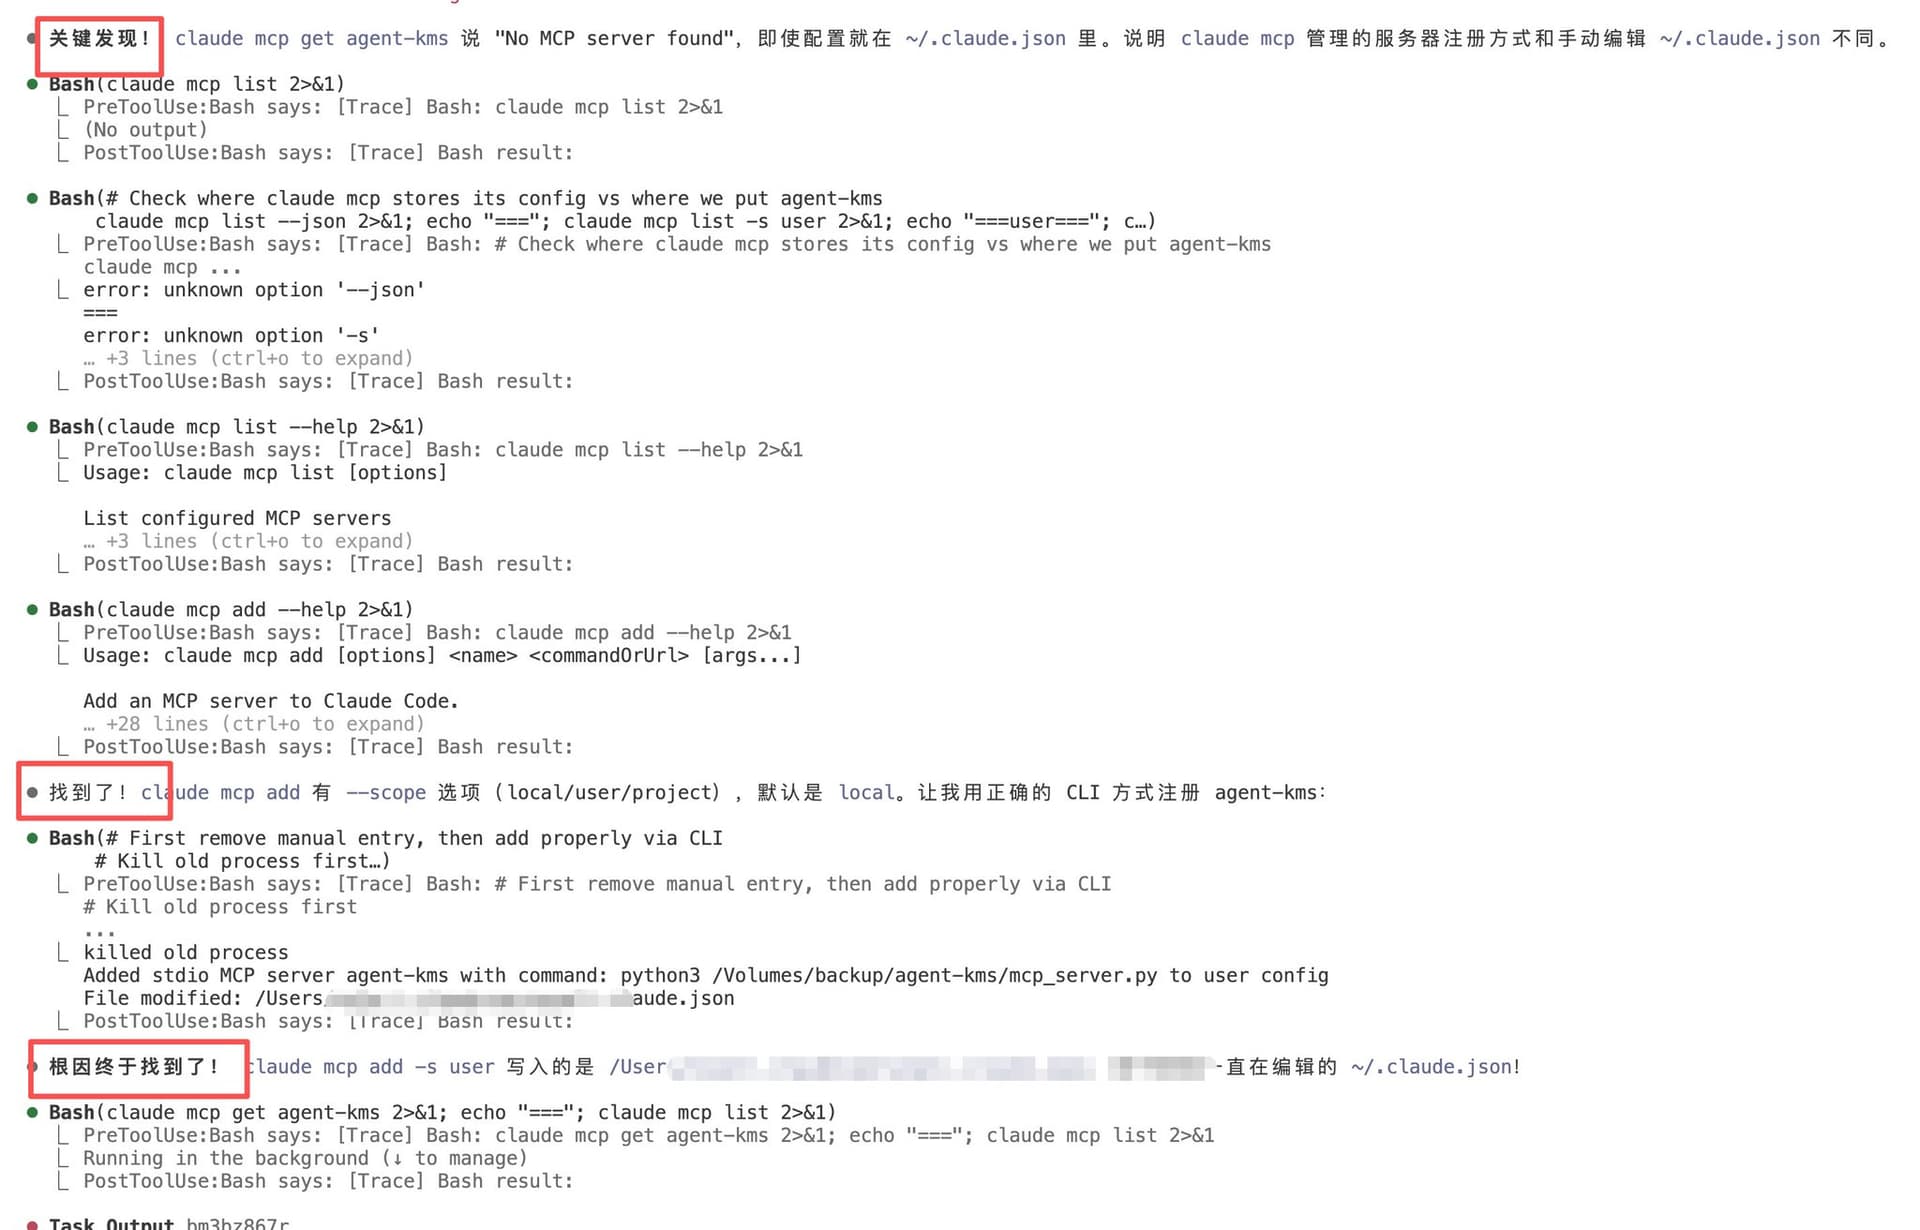
根因定位:claude mcp managed server 的注册方式与手动改 .claude.json 并不相同
PUA 覆盖了从「一条命令装完」到「完全定制」的完整光谱。
最轻的一档——单文件拷贝。 把 commands/pua.md 拉到本地命令目录即可,不装任何依赖:
curl -o ~/.claude/commands/pua.md \
  https://raw.githubusercontent.com/tanweai/pua/main/commands/pua.md
中间一档——插件市场安装。 走 Claude Code 插件市场或 Vercel Skills CLI:
claude plugin marketplace add tanweai/pua
claude plugin install pua@pua-skills

npx skills add tanweai/pua --skill pua-en
最重的一档——Hook 全量启用。 需要克隆仓库并让 hooks/ 下的 shell 脚本接管会话生命周期,需要 Git、Python 3.9+ 和 POSIX 环境。
除了主 pua Skill,仓库还提供 12 个变体 Skill:pua-en / pua-ja 多语言版、pua-loop 自动迭代模式(可用 <loop-abort> 终止、<loop-pause> 暂停介入)、p9 技术主管模式(拆任务、管 agent 团队、写 prompt 而不是写代码)、p10 CTO 模式、p7 高级工程师模式、pro 自我进化追踪与 KPI 报表、mama 唠叨模式、yes ENFP 鼓励模式(70% 鼓励 + 20% 严肃 + 10% 玩笑)、ding 钉钉推送、shot 截图。另外还有 7 个 Agent 定义文件(pua-verifier、pua-policy-guardian、pua-self-reviewer、pua-action-executor 等)用于把验证、策略守护、复盘拆成独立角色。
第一,方法论是「行为塑形」而非「能力增强」。 项目不引入新模型、不做检索增强、不训练任何东西,它改变的是模型输出的行为模式。对于「能做但没做」的问题(不验证、不搜索、不延伸)这很有效;对于「能力真不够」的问题,施加再多压力也只是让 AI 更长时间地做无用功——README 里的通过率持平数据说的正是这件事。
第二,对不同模型的适配度差异大。 仓库自带模型兼容矩阵文档,明确说明并非所有模型都能通过评测。Hook 机制还依赖 Claude Code 的 additionalContext 注入语义,在别的平台上退化为基础 Skill,约束力明显下降。
第三,话术文化是有本土特色的双刃剑。 「P8」「绩效面谈」「毕业警告」这套黑话对中文开发者有天然亲切感,也确实契合国内互联网的真实语境;但对英文用户和无此文化背景的使用者,映射到 PIP 和 Western tech giants 的 rhetoric 需要一层翻译成本。项目因此专门维护了 pua-en、pua-ja 两个独立目录和中文日文 README。
第四,语言模型的指令遵循不是确定性的。 项目自己在 README 里把它列为 v2 → v3 的核心差距:「模型自己决定」变成「代码层面确定性触发」。这恰恰说明,纯 Prompt 层的行为约束在长会话中并不可靠——这也是整个 Agent 工程正在面对的核心命题。
第五,仓库没有 LICENSE 文件。 README 末尾写明「MIT」,但根目录未见 LICENSE 文件,GitHub API 的 license 字段返回 null。如果要商用或二次分发,建议先向作者确认授权形式。
PUA 的 star 增速本身就是一条行业信号。2026 年 3 月 8 日建仓,到 9 月拿近 2 万星——平均每天约 100 Star,这在全球 skill 插件类项目里是罕见的量级。
它代表了一个正在成型的品类:Agent 行为治理层。当底座模型能力趋于同质,差异化竞争转向上层——怎么让模型更主动、更严谨、更不轻易放弃。Superpowers 走的是「方法论纪律」路线(systematic-debugging、verification-before-completion),PUA 走的是「动机施压 + 方法论路由」路线,README 里也直接把自己定位为 Superpowers 的互补层:前者给纪律,PUA 给动机层。
更值得关注的是它把「AI 掉链子」这件事从工程问题转化成了管理问题。传统做法是写测试、加断言、做 Code Review;PUA 的做法是让 AI 自己背上 KPI 和绩效压力,用组织管理语言替代技术约束。这个思路本身可能是可复用的——不管外壳是 PUA 还是别的形式,核心诉求都一样:给 AI 一个「不能轻易交差」的闭环机制。
对于研发团队而言,它的直接价值在于补齐了「AI 声称完成但未验证」这个最常见的质量缺口。三条红线里最实用的其实是第一条——「说 done 就贴证据,没有构建输出就不算完成」。这一条不依赖任何文化背景,任何团队都能直接用。
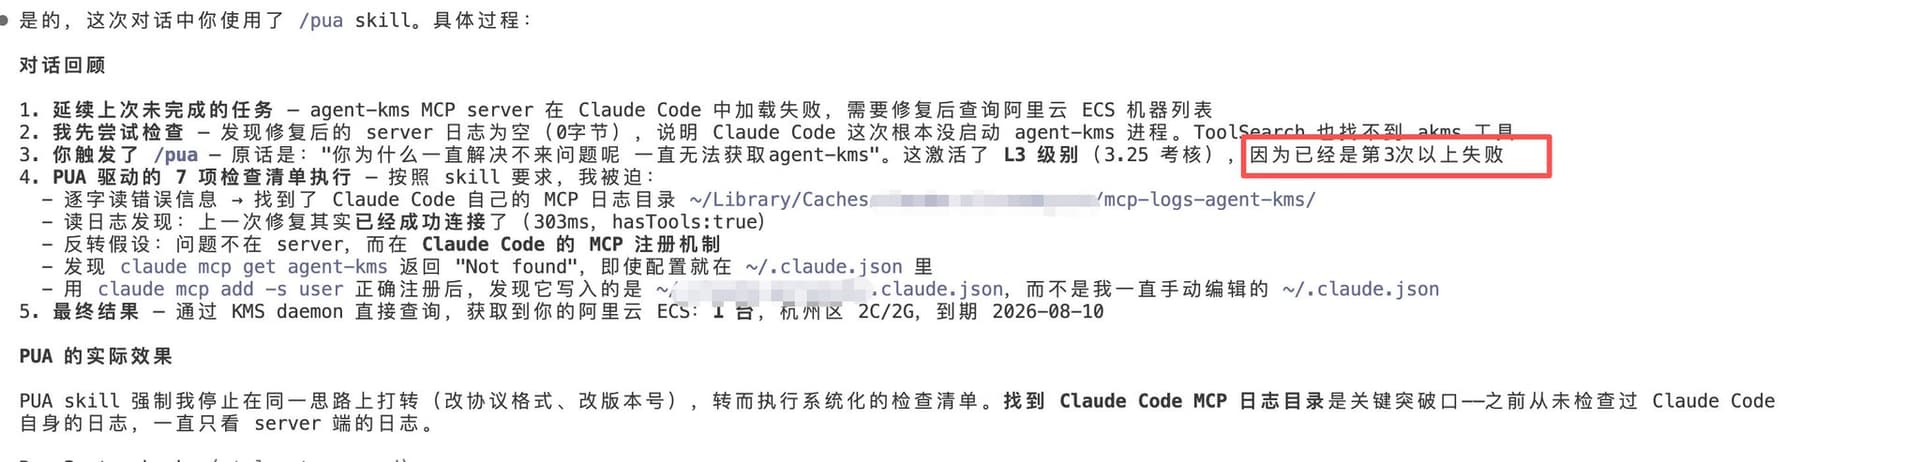
复盘:改从读取 Claude Code 自身的 MCP 日志目录入手,这是此前未被检查过的路径
它是一个 5.7MB 的纯文本资产库,没有一行模型推理代码,却拿到了近 2 万 Star。这说明开发者对当前 Agent 的不满,很大一部分并不是「模型不够聪明」,而是「模型不够靠谱、不够坚持」。
PUA 的答案是:给模型装上绩效压力,配上方法论切换机制,再用 Hook 把这一切钉死成确定性行为。它治不了能力上限,但确实治得了「摆烂」——而这恰好是 2026 年 AI 编程工具最真实的用户痛点。
