
VisionTransformer
tahmid0007/VisionTransformer加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
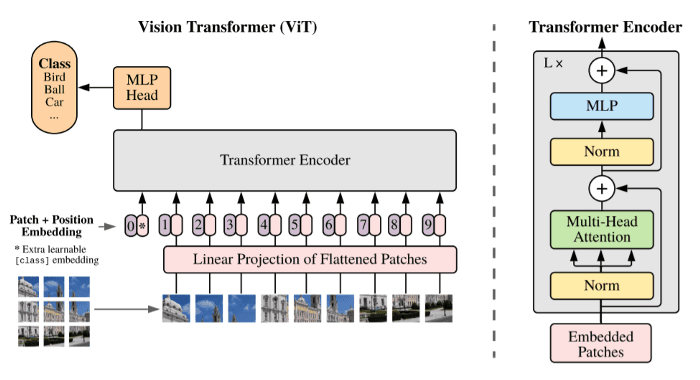
2020年,Google在一篇轰动学术圈的论文**"An Image is Worth 16x16 Words"**中提出了一个大胆的设想:既然自然语言处理中的Transformer在序列建模上如此成功,为什么不能把同样的思想迁移到图像领域?
这个项目——tahmid0007/VisionTransformer——正是这一设想的完整PyTorch复现。它用不到300行代码,把Transformer的核心思想移植到了计算机视觉任务中,在CIFAR-10数据集上验证了可行性。
简单来说:它让计算机学会"看图说话",而不仅仅是识别猫和狗。
长期以来,卷积神经网络(CNN)几乎是计算机视觉的代名词——ResNet、VGG等架构牢牢占据着图像分类的SOTA位置。然而Google的这篇论文揭示了一个重要事实:Transformer不仅能处理文字序列,同样能处理图像序列,而且在大规模预训练的场景下,ViT的性能可以全面超越CNN。
这个项目完整实现了论文的核心架构:
不同于很多追求极致性能的工业级实现,这个项目的最大特色是代码注释极其详尽,专门为Transformer初学者设计。作者在每个关键步骤都附上了注释,例如:
qkv = self.to_qkv(x)  # gets q = Q = Wq matmul x1, k = Wk mm x2, v = Wv mm x3
q, k, v = rearrange(qkv, 'b n (qkv h d) -> qkv b h n d', qkv = 3, h = h)  # split into multi head attentions
dots = torch.einsum('bhid,bhjd->bhij', q, k) * self.scale  # 1/sqrt(dim)
attn = dots.softmax(dim=-1)  # follow the softmax,q,d,v equation in the paper
这种"代码即文档"的风格,让任何一个想入门ViT的开发者都能在阅读源码的过程中理解论文的核心公式,而非囫囵吞枣地调用封装好的API。
市面上有多个ViT复现项目,但这个项目有几点不同:
| 特性 | 本项目 | lucidrains/vit-pytorch |
|---|---|---|
| 贴近原论文程度 | 更高(patch embedding和初始化更接近原论文) | 封装更好但做了部分简化 |
| 代码可读性 | 极高,带详细注释 | 中等 |
| 预训练权重 | 无(需自行训练) | 支持加载预训练权重 |
| 部署难度 | 极简,单文件 | 依赖较多 |
整个模型的数据流如下:
输入图像 (32×32×3)
  ↓
Patch Conv (Conv2d: 3→64, kernel=4, stride=4)
  ↓ 将图像分成 (32/4)² = 64 个 patch
每个patch拉平为 3×4×4 = 48 维向量
  ↓
线性投影 (Linear: 48→64) —— 对应论文中的 E 矩阵
  ↓ 64 个 patch embedding
添加 [CLS] Token (可学习参数)
  ↓ 65 个 token(1个分类token + 64个图像块token)
添加位置编码 (Positional Embedding)
  ↓
N× Transformer Encoder Block
  ↓ N=6(depth=6)
取 [CLS] token 的输出
  ↓
MLP Head (Linear: 64→10)
  ↓
分类结果 (CIFAR-10的10个类别)
Attention模块:这是整个ViT的核心。代码中通过 torch.einsum 实现高效的矩阵乘法,避免了显式的循环展开,性能优异。
# QKV联合投影,一次矩阵乘法得到Q、K、V三个矩阵
self.to_qkv = nn.Linear(dim, dim * 3, bias=True)
# 经典的注意力分数计算
dots = torch.einsum('bhid,bhjd->bhij', q, k) * self.scale
attn = dots.softmax(dim=-1)
MLP Block:采用GELU激活函数(而非ReLU),与原论文一致,配合Xavier均匀初始化,训练稳定性良好。
rearrange 操作简化张量维度变换,代码可读性极高pip install torch torchvision einops
from Google_ViT import ImageTransformer, train, evaluate
import torch.optim as optim

model = ImageTransformer(
    image_size=32, patch_size=4, num_classes=10, channels=3,
    dim=64, depth=6, heads=8, mlp_dim=128
)
optimizer = torch.optim.Adam(model.parameters(), lr=0.003)
| 参数 | 默认值 | 含义 |
|---|---|---|
| image_size | 32 | 输入图像尺寸(CIFAR-10为32×32) |
| patch_size | 4 | 每个patch的大小(论文推荐16) |
| dim | 64 | 每个token的嵌入维度 |
| depth | 6 | Transformer Encoder的层数 |
| heads | 8 | 多头注意力的头数 |
| mlp_dim | 128 | MLP中间层维度 |
注意:作者在README中明确指出,如果从零训练(无预训练),ViT在小数据集(如CIFAR-10)上的准确率可能不如ResNet。要充分发挥ViT的优势,需要先在大规模数据集(如ImageNet-21k)上预训练,再在小数据集上微调。
ViT的核心代价是注意力机制的计算复杂度随序列长度呈**O(n²)**增长。对于ImageNet这样的224×224图像,切分成16×16 patch后会产生196个token,注意力计算量是传统CNN的数倍。本项目在CIFAR-10(32×32)上使用较小的dim=64,相对可控,但切换到ImageNet时需要大量GPU显存。
这个项目没有提供预训练权重,意味着如果直接在小数据集上从头训练,模型需要消耗大量时间和计算资源才能收敛。对于只是想快速体验ViT效果的开发者来说,这是一个门槛。
作为一个单文件实现(Google_ViT.py),这个项目没有模块化拆分、没有配置文件、没有超参数管理系统。在实际项目中,这种"一次性的notebook风格"代码难以维护和扩展。
代码中 DL_PATH = "C:\Pytorch\Spyder\CIFAR10_data" 是硬编码的Windows路径,在Linux/Mac环境下需要手动修改,否则会报错。
自2020年Google发布ViT以来,这条技术路线已经催生了大量后续研究:
这个项目作为ViT的入门级复现,为后来者提供了一个理解这些前沿工作的"起点"。可以说,理解了这个项目,你就掌握了解读上述所有SOTA论文的第一把钥匙。
截至目前(2026年),tahmid0007/VisionTransformer 获得了 101 stars 和 14 forks。考虑到ViT本身是2020年的工作,这个关注度属于"学术教学型项目"的正常水平——它的价值不在于star数量,而在于帮助了多少人真正理解了Transformer在视觉领域的原理。
一句话总结:这不是一个追求SOTA的工程级项目,而是一个用300行代码讲清楚ViT核心原理的教学级宝藏。如果你正在学习Transformer或想理解为什么"注意力机制"能在图像领域革命,这个项目是极好的起点。
