
ChiMed-GPT
synlp/ChiMed-GPT加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下这样的场景:一位基层医生面对一份密密麻麻的病历报告,希望 AI 能帮忙快速提取关键诊断信息——症状、药品名称、检测指标——但通用大模型却给出了似是而非的答案,甚至把"高血压"识别成了"低血压"。这并非虚构的困境,而是 2022 年前后医疗 AI 落地面临的真实瓶颈:通用模型缺乏足够的医学知识深度,无法在命名实体识别、医学问答等关键任务上达到临床可用水平。
正是在这一背景下,ChiMed-GPT 应运而生——一款由中国科学技术大学联合研发团队打造的中文医疗大语言模型,基于 Ziya-v2 底座,综合运用预训练、SFT(监督微调)和 RLHF(人类反馈强化学习)三种训练手段,在 CCKS2019 命名实体识别任务上以 40.82 的 F1 分数接近 GPT-4(41.37),在 ChiMST 数据集上更是以 41.04 大幅领先,展现了垂直领域大模型的独特价值。
选择基座模型是医疗大模型的关键第一步。ChiMed-GPT 没有从零预训练,而是基于Ziya-v2(由 IDEA-CCNL 团队开发的中文预训练语言模型)进行持续训练。这一策略在学术和工程层面都有充分依据:Ziya-v2 本身在大规模中文语料上完成了充分的预训练,具备良好的语言理解和生成基础;在其之上叠加医疗领域数据的二次预训练,可以实现"通用能力保留 + 医疗能力增强"的双重目标。
ChiMed-GPT 的完整训练流程分为三个阶段:
第一阶段:领域持续预训练。 团队将 Ziya-v2 在中文医疗语料上进行二次预训练,使模型在医疗语境下的语义表示更加精准。这一阶段主要解决"医学术语理解"问题——例如让模型准确区分"心电图 ST 段抬高"与"ST 段压低"这两种截然不同的病理表现。
第二阶段:监督微调(SFT)。 使用人工标注的高质量医疗问答数据对模型进行有监督微调,让模型学习"什么样的回答是医生认可的标准答案"。这个阶段决定了模型输出的格式规范性和医学专业性。
第三阶段:人类反馈强化学习(RLHF)。 引入人类偏好信号对模型进行进一步对齐,使生成内容不仅准确,而且表达自然流畅,符合医患沟通的表达习惯。RLHF 是弥合"技术正确"与"人文表达"之间鸿沟的关键环节。
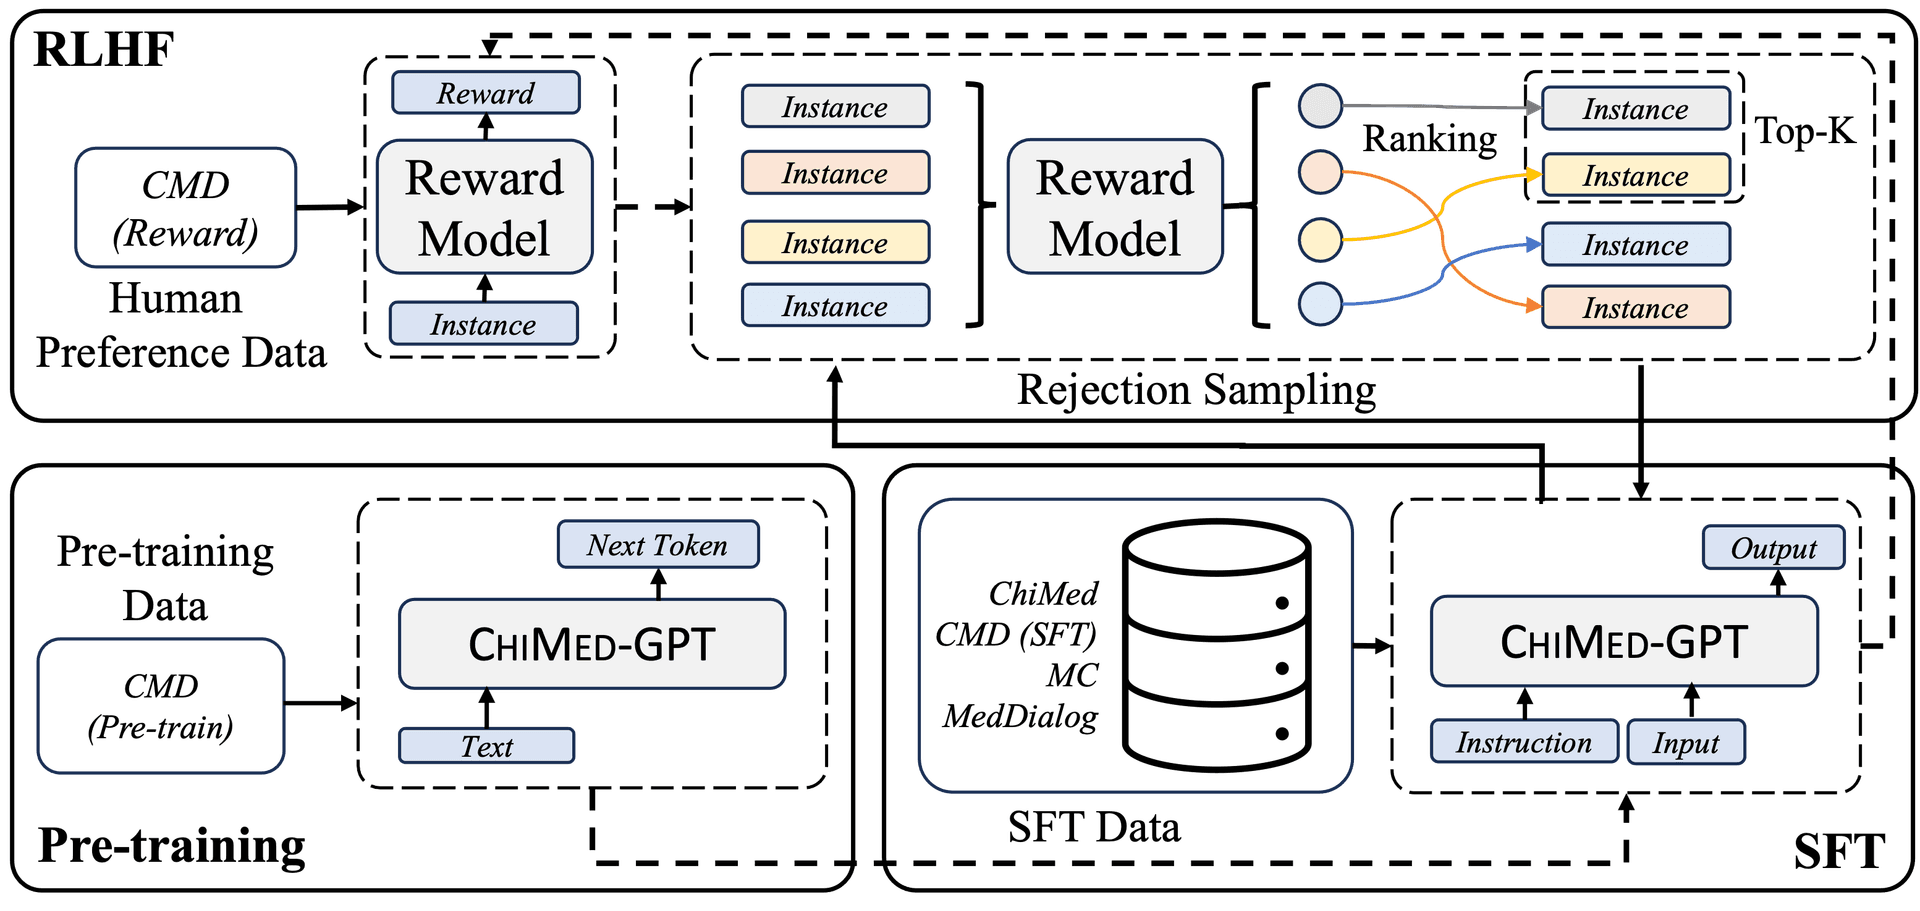
ChiMed-GPT 三阶段训练流程:预训练 → SFT → RLHF(来源:GitHub 官方仓库)
ChiMed-GPT 在多个权威医疗基准上进行了系统评估,以下为核心结果摘要:
命名实体识别(NER)——这是医疗信息提取的核心能力。在 CCKS2019 数据集上,ChiMed-GPT 达到 40.82 F1,接近 GPT-4(41.37),大幅领先 GPT-3.5-Turbo(31.42)和其他国产医疗模型。在 ChiMST 数据集上,ChiMed-GPT 以 41.04 F1 超越 GPT-4(41.25 在 CCKS 上)——这意味着在中文医学命名实体识别任务上,ChiMed-GPT 已具备与 GPT-4 相当的竞争力。
医学问答(QA)——在 C-Eval 基准上达到 68.29 分,在 CMMLU 上达到 52.92,在 MedQA(美国执业医师考试题)上达到 44.50 分。虽然与 GPT-4(71.29/69.55/67.99)仍有差距,但相比 Ziya-v2 原始底座(39.02/49.06/13.00)已有显著提升,尤其是在 MedQA 上的进步(从 13.00 到 44.50)体现了 RLHF 阶段的有效性。
多轮对话——在 MC 数据集上,ChiMed-GPT 在 BLEU-1、BLEU-2、ROUGE-1/2/L 等指标上均全面领先 GPT-4 和 GPT-3.5-Turbo,体现了其在中文医学多轮对话场景中的优势。
适合的场景: 医疗文献的结构化信息提取(NER)、医学知识问答、医学教育场景下的习题讲解、医疗记录摘要生成。对于已有 GPU 基础设施的医疗机构或研究团队,ChiMed-GPT 可以在本地部署并作为医学知识助手使用。
需要注意的局限: ChiMed-GPT 仅提供模型权重和研究论文,没有推理代码、Docker 部署包或 Web 界面。要让它真正运行起来,需要自行准备 PyTorch 环境、加载 transformers 模型权重、实现推理服务——这对工程团队有一定要求。更重要的是,医疗场景对模型输出的准确性和可靠性要求极高,任何 AI 辅助诊断系统都需要经过严格的临床验证和监管审批,不能直接将模型输出作为临床决策依据。
ChiMed-GPT 的核心贡献不仅在于模型本身,更在于其完整的三阶段训练范式验证。论文(arXiv:2311.06025)系统证明了"预训练 + SFT + RLHF"这一组合在中文医疗垂直领域同样有效,为后续研究提供了可复现的技术路线参考。此外,ChiMed-GPT 与同期发布的 ChiMST 数据集形成协同——模型和数据集的配套开源,有助于推动中文医学 NLP 研究的规范化发展。
ChiMed-GPT 的部署难度较高,属于"困难"级别。没有提供 Docker 镜像或 docker-compose 配置,仓库中仅有论文、README 和模型架构图。要运行该模型,团队需要具备以下能力:
对于普通用户,建议关注该模型对应的 HuggingFace 页面或魔搭社区(ModelScope)的在线 Demo,暂不推荐自行部署;对于有 AI 基础设施的医疗机构或 AI 研究团队,ChiMed-GPT 是当前中文医疗大模型中学术背景最扎实、开源最完整的方案之一。
| 维度 | 评估 |
|---|---|
| 学术价值 | ★★★★★ — 三阶段训练 + 多 benchmark 系统验证 |
| 中文医疗 NER | ★★★★★ — 接近 GPT-4 水平,领先国产同类 |
| 部署便捷性 | ★☆☆☆☆ — 无推理代码/Docker/WebUI,需自行工程对接 |
| 工程成熟度 | ★★☆☆☆ — 纯研究导向产物,非生产级应用 |
| 持续活跃度 | ★★☆☆☆ — 2023 年发布后更新较少 |
如果你正在构建医疗知识抽取系统或进行医学 NLP 研究,ChiMed-GPT 值得重点关注——但请先确认你的团队有足够的工程能力来承接模型落地工作。
