
swirl-search
swirlai/swirl-search加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
SWIRL 品牌图(图片源已失效)
想象这样一个场景: 你在一家拥有 200 人的中型企业工作,日常工作中需要在 Confluence 查产品文档、在 Salesforce 查客户记录、在 Slack 翻聊天记录、在 GitHub 找代码片段——每次切换工具都要重新登录、重新搜索,好不容易找到相关信息,还要手动复制粘贴到 Word 报告里。这就是大多数企业知识工作的现状:数据分散在数十个应用中,却没有一个统一的入口。
传统的企业 AI 搜索方案通常要求你先把所有数据导入向量数据库,再在副本上做检索。这听起来很美好,但实际落地时意味着:
SWIRL Community 正是为解决这个问题而生——数据不动,只派查询过去。
SWIRL 由 SWIRL AI 公司开发,核心团队成员曾在 Google、Microsoft 等公司从事搜索基础设施工作。创始人 David Robson 于 2022 年 4 月在 GitHub 上创建了该项目(swirlai/swirl-search),目前已获得超过 3000 颗星,fork 数达 286 个,贡献者 34 人,Apache 2.0 许可证。
项目的核心理念是 Zero-ETL 联邦搜索(Zero-ETL Federated Search)。这个概念最早由数据库领域提出——与其把数据搬来搬去,不如让查询"穿透"到各个数据源原地执行,再将结果汇聚回来。SWIRL 将这一理念与 LLM 驱动的 RAG 结合,实现了无需数据迁移的智能搜索体验。
2024 年底,SWIRL 发布了 4.x 版本,将 Galaxy UI 深度集成到开源版本中,同时支持多 LLM 后端(通过 LiteLLM 兼容 OpenAI、Claude、Gemini 等),进一步扩大了技术覆盖面。
SWIRL 的技术架构分为三个层次:
连接器是 SWIRL 与外部数据源交互的桥梁。目前支持 100+ 连接器,覆盖:
| 类别 | 代表连接器 |
|---|---|
| 搜索引擎 | Google PSE、Bing、PubMed |
| 数据库 | PostgreSQL、BigQuery、Elasticsearch、OpenSearch、MongoDB |
| SaaS 应用 | Microsoft 365(SharePoint/OneDrive/Outlook)、Salesforce、Confluence、Jira、GitHub |
| 通用 API | REST API、GraphQL、RSS |
连接器的设计遵循适配器模式(Adapter Pattern):每个连接器实现统一的接口,将不同数据源的查询语法和响应格式标准化。这意味着新增一个数据源只需实现一个连接器,而无需修改核心逻辑。
当用户输入一个查询时,SWIRL 会依次经过以下处理器:
在结果融合后,SWIRL 可以将排名靠前的搜索结果作为上下文,调用用户自己的 LLM API(如 OpenAI)生成带引用的答案,并附上可点击的来源链接。整个过程数据从未离开用户的网络环境——LLM API key 由用户自己提供,SWIRL 只负责将结果传递给 LLM。
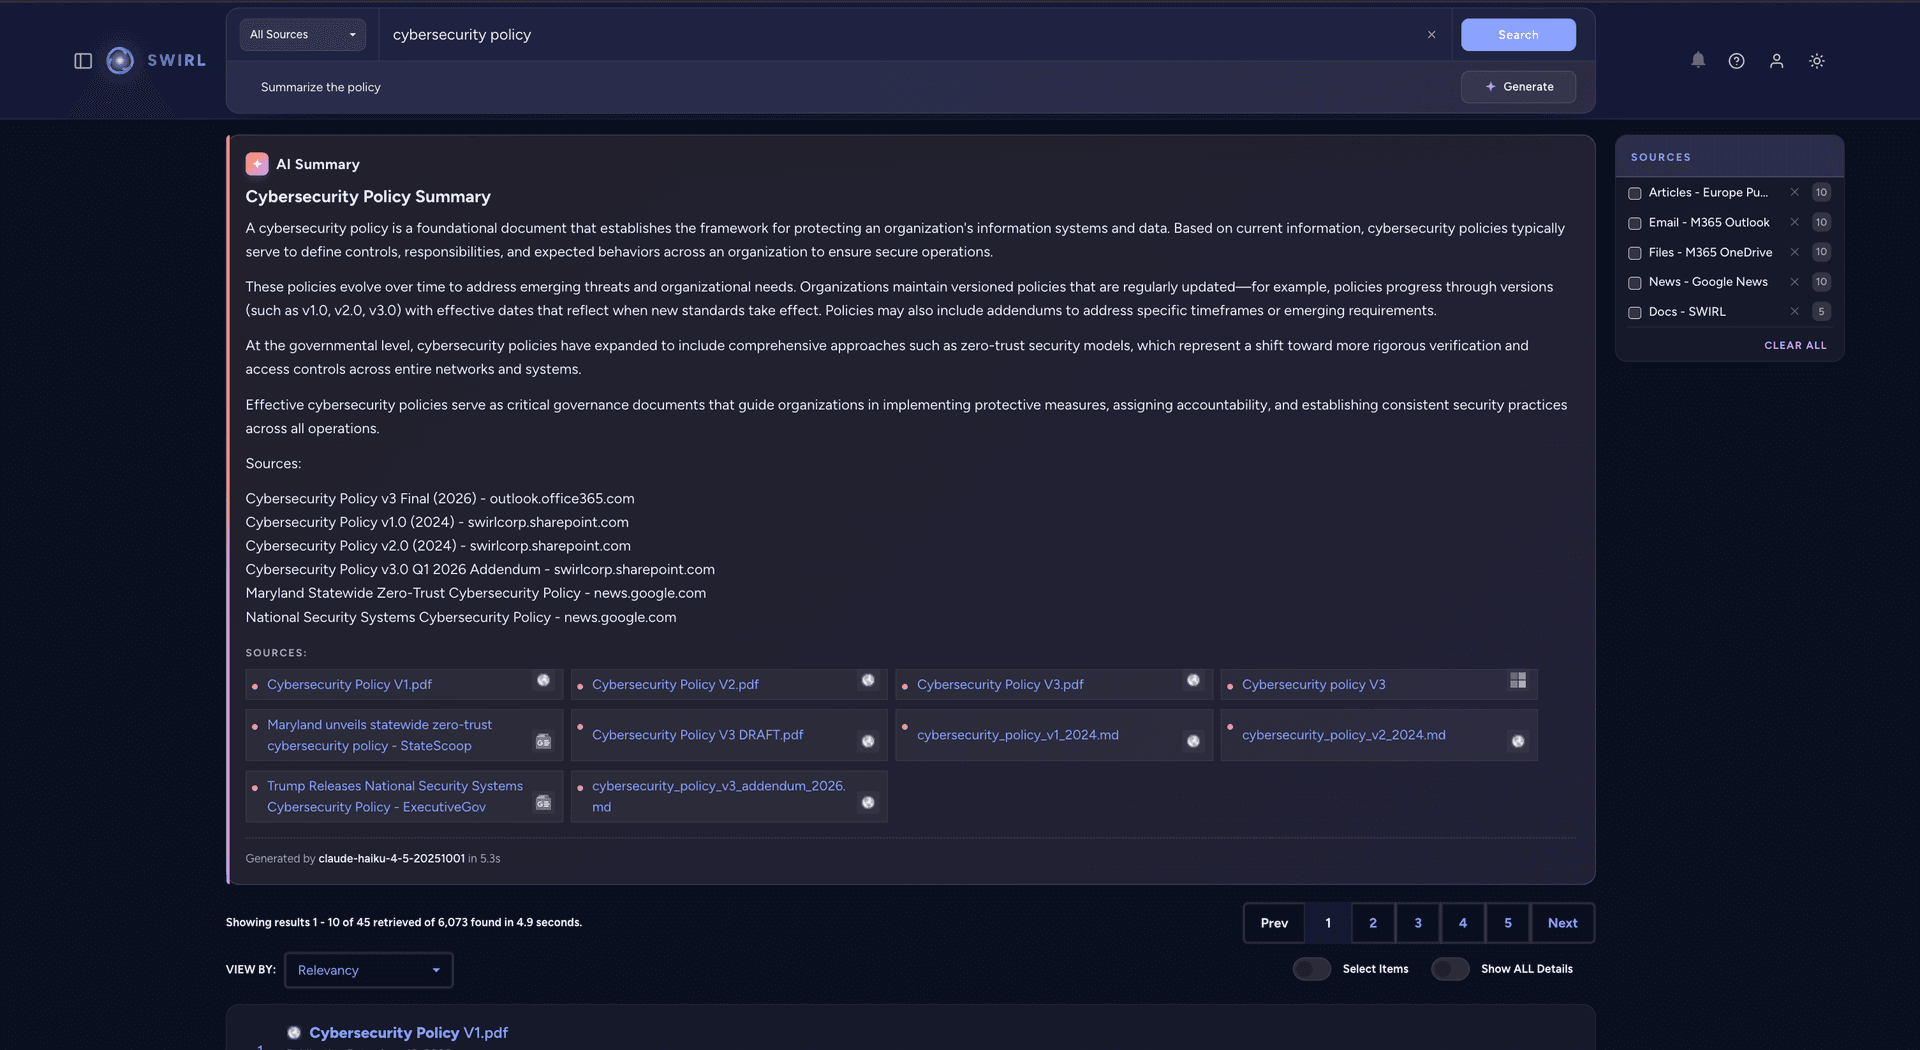
图:Galaxy UI 展示来自多个数据源的统一搜索结果,每个结果附有来源标签和 RAG 生成的摘要。
SWIRL 的技术选型非常务实:
| 组件 | 技术选型 | 说明 |
|---|---|---|
| 后端框架 | Django 5.2 + Django REST Framework | 企业级 Python Web 框架 |
| 异步任务 | Celery + Redis | 分布式任务队列,支持异步联邦查询 |
| 语义嵌入 | spaCy (en_core_web_lg) + NLTK | Community 版本地计算,无需 API key |
| LLM 路由 | LiteLLM | 统一接口,兼容 50+ LLM 提供商 |
| 数据库 | SQLite(开发)/ PostgreSQL(生产) | 开箱即用,扩展友好 |
| 实时通信 | Django Channels + Daphne | 支持 WebSocket |
| 依赖管理 | requirements.txt | 依赖较多(约 200+),需要 Python 3.9+ |
整体代码组织清晰:swirl/ 目录为核心业务代码,swirl/connectors/ 放置各数据源连接器,swirl/mixers/ 放置结果融合算法,swirl_server/ 放置 Django 项目配置。
SWIRL 提供了开箱即用的 Docker 部署方案,这是它最大的优势之一:
# 下载 compose 文件
curl https://raw.githubusercontent.com/swirlai/swirl-search/main/docker-compose.yaml -o docker-compose.yaml

# 可选:配置 OpenAI API key 以启用 RAG
export MSAL_CB_PORT=8000
export MSAL_HOST=localhost
export OPENAI_API_KEY='<your-OpenAI-API-key>'

# 启动
docker-compose pull && docker-compose up
启动后访问 http://localhost:8000/galaxy,使用 admin / password 登录,即可开始使用。SWIRL 预置了对 Arxiv、Google News、European PMC 三个数据源的连接器,无需额外配置即可体验。
硬件需求方面,SWIRL 不需要 GPU,官方推荐 2GB+ RAM 和 2GB+ 磁盘空间即可流畅运行,门槛极低。
requirements.txt 超过 200 个包,首次安装耗时较长。SWIRL 的出现反映了一个重要趋势:AI 搜索正在从"向量库中心"向"联邦查询"演进。
过去两年,RAG 一直是企业 AI 搜索的主流范式,但随着企业数据规模扩大和数据隐私法规趋严,"先搬家再检索"的局限性日益凸显。SWIRL 代表了一种实时联邦 RAG(Real-time Federated RAG)路线:数据不动、查询穿透、结果融合。
这一方向也引起了学术界的关注——2025 年 2 月 arXiv 上发表的论文《RAGRoute》提出了类似的动态数据源选择机制,进一步印证了这一技术方向的可行性。
从市场角度看,SWIRL 面临的竞争对手包括:
SWIRL 的差异化在于:最少的配置、最低的门槛、最快的上手时间。对于想快速验证 AI 搜索价值的团队,这是目前最具性价比的开源选择。
