
Julia-LLM-Leaderboard
svilupp/Julia-LLM-Leaderboard加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
当一位科研人员用 Julia 编写微分方程求解器时,他向 GPT-4 提问,却得到了语法完全错误的代码——括号错位、函数不存在、包名对不上。这样的场景在 AI 代码助手爆发式普及的今天并不罕见,却暴露出一个核心问题:通用代码评测基准(如 HumanEval)无法准确反映特定语言社区的真实需求。
Julia 语言以其高性能数值计算闻名,但在语法层面有着独特的表达方式——多重分派(multiple dispatch)、链式比较、宏系统——这些特性让通用大模型频繁"踩坑"。正是为了填补这一空白,开发者 svilupp 创建了 Julia LLM Leaderboard,一个专门评测大模型生成 Julia 代码能力的开放平台。
这个项目不仅仅是排行榜,更是 Julia 社区集体评估 AI 代码助手实用性的协作工具。任何人都可以提交新的测试用例、参与评测流程,推动 AI 模型对 Julia 的支持不断进步。
Julia LLM Leaderboard 的评测方法独树一帜,核心理念简单直接:"生成代码 → 运行它 → 看是否工作"。 但背后有严谨的四层打分机制:
第一层:语法解析(Parsing) — 生成的代码能否被 Julia 编译器正确解析?这是最基本的门槛,也是大多数失败案例倒在这一步。
第二层:执行无错(Execution) — 代码能否成功运行而不崩溃?运行时错误(Runtime Error)在这里被捕获。
第三层:单元测试(Unit Tests) — 每个测试用例内置单元测试,生成的代码是否能通过这些测试?
第四层:示例运行(Example Runs) — 在提供的真实场景中,代码是否能产出预期的结果?
每项测试用例满分 100 分,通过一项扣 25 分,完全通过得 100 分。这种量化方式让不同模型的表现一目了然,也为社区提供了可量化的参考标准。
项目基于 Julia 1.10+,克隆仓库后,进入 Julia REPL 安装依赖即可运行:
julia --project -e 'using Pkg; Pkg.instantiate()'
参考 examples/code_gen_benchmark.jl 文件,设置模型 API key,选择提示词模板,点击运行。评测脚本会自动调用各大模型的 API(或通过 Ollama 调用本地模型),运行所有测试用例并生成评分报告。
项目采用 TOML 格式定义测试用例(definition.toml),社区成员可以按照标准模板贡献新的测试场景。这意味着评测基准会随 Julia 语言生态一起成长,保持持续更新。
除了云端 API,项目还支持通过 Ollama 评测本地部署的模型。这意味着用户可以在完全不调用外部 API 的情况下,对 Llama、Mistral、Codellama 等本地模型进行隐私友好的评测。
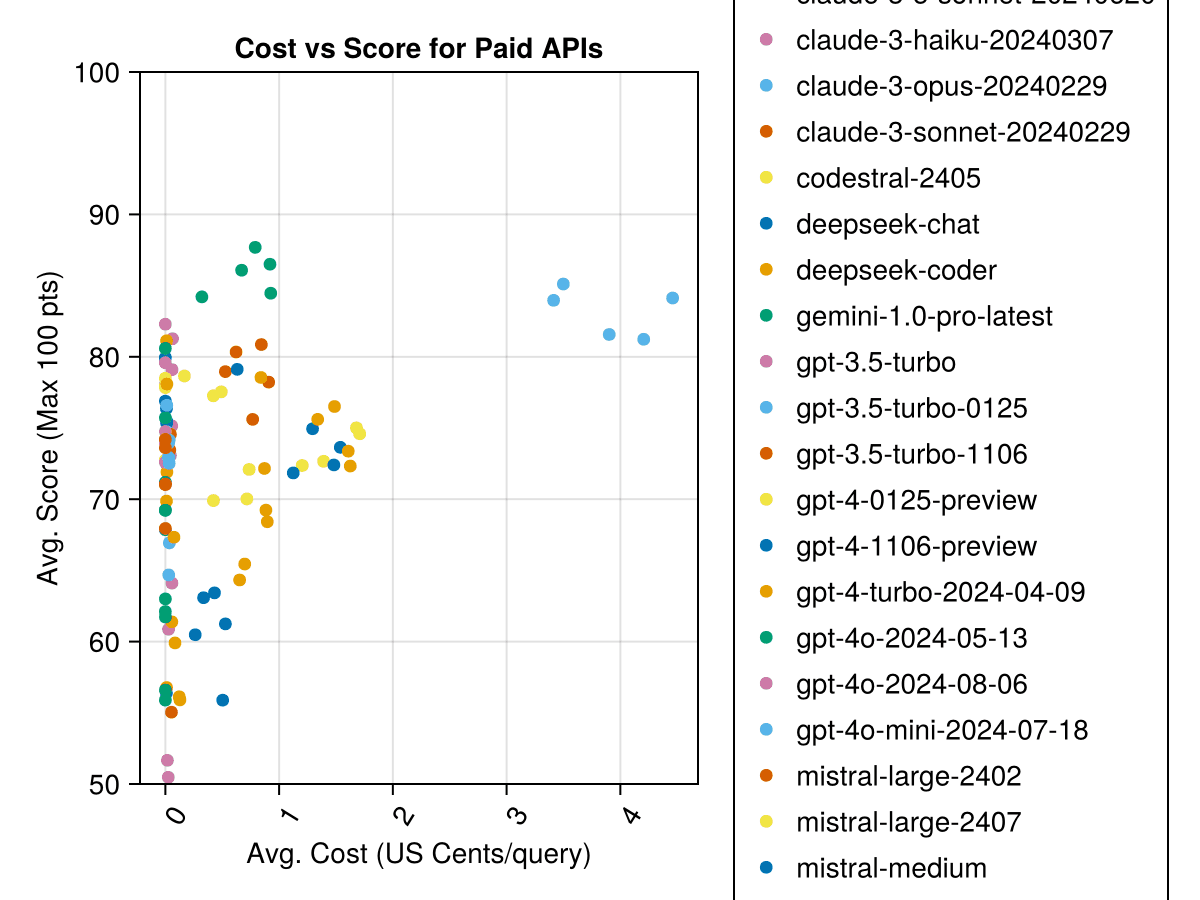
根据公开评测结果,Claude 3.5 Sonnet 以 85.8 分稳居榜首,领先第二名 Claude 3 Opus(83.2 分)两个身位。GPT-4o 以 76.6 分位列第四。
值得关注的是 Mistral Codestral(76.3 分)的出色表现——作为一款专注于代码的模型,它在 Julia 特定语法上展现了不错的理解能力。而 GPT-3.5-Turbo 仅得 61.7 分,说明通用模型在 Julia 这种特殊语法上仍有明显短板。
性价比方面,Claude 3 Haiku(74.9 分,成本仅 0.05 美元/次)和 GPT-4o mini(74.0 分,成本 0.03 美元/次) 是性价比最高的选择,远超 GPT-3.5-Turbo 的表现。
本地模型赛道竞争激烈,Mixtral-8x22B-Instruct(77.6 分)和 Llama-3-70B-chat(76.8 分) 表现最为接近顶级付费 API。
值得注意的是 Meta Llama-3 8B(67.7 分) 以最小的参数规模展现了令人印象深刻的 Julia 代码生成能力,堪称"小钢炮"。而 codellama 系列虽然在 Python 上表现优异,但在 Julia 上得分明显偏低(13B 版本仅 56.4 分)。
评测还对比了不同提示词模板的效果,核心发现:
评测局限性 — 当前的评测以"能否通过测试"为标准,无法评估生成代码的算法正确性和性能优化。一段能运行的代码未必是最高效的实现。
模型同质化风险 — 测试用例由社区贡献,可能存在对特定 API 模型架构的偏向性。不同模型在相同测试上的得分差异,部分原因可能来自 API 调用的不确定性。
时间漂移 — README 中已注明,评测结果会随底层支持功能的迭代而变化。例如 2024 年 3 月测试的 GPT-3.5-Turbo 与最新版本已不可同日而语。
本地模型评测的不一致性 — 项目指出 Ollama/llama.cpp 在不同时间点的评测结果存在波动,说明本地模型的推理结果受版本影响较大。
Julia LLM Leaderboard 的价值不仅在于提供了一个评测工具,更在于它代表了一种社区驱动的垂直领域 AI 评测思路。通用基准无法覆盖每种编程语言的独特语法和最佳实践,而像这样由语言社区自发维护的评测平台,能够提供更精准的选型参考。
从数据来看,Claude 系列在 Julia 代码生成上的优势非常明显,这可能与 Anthropic 在训练时对代码能力的侧重有关。对 Julia 开发者而言,优先选择 Claude 系列(或性价比更高的 Claude Haiku)作为日常编码助手,能获得最佳体验。
同时,榜单也展示了开源模型快速追赶的趋势——Llama-3-70B 已经接近顶级付费 API 的表现,这为注重数据隐私的团队提供了可行的本地部署方案。
