
academic-commercialization-agent
shuxiachai/academic-commercialization-agent加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
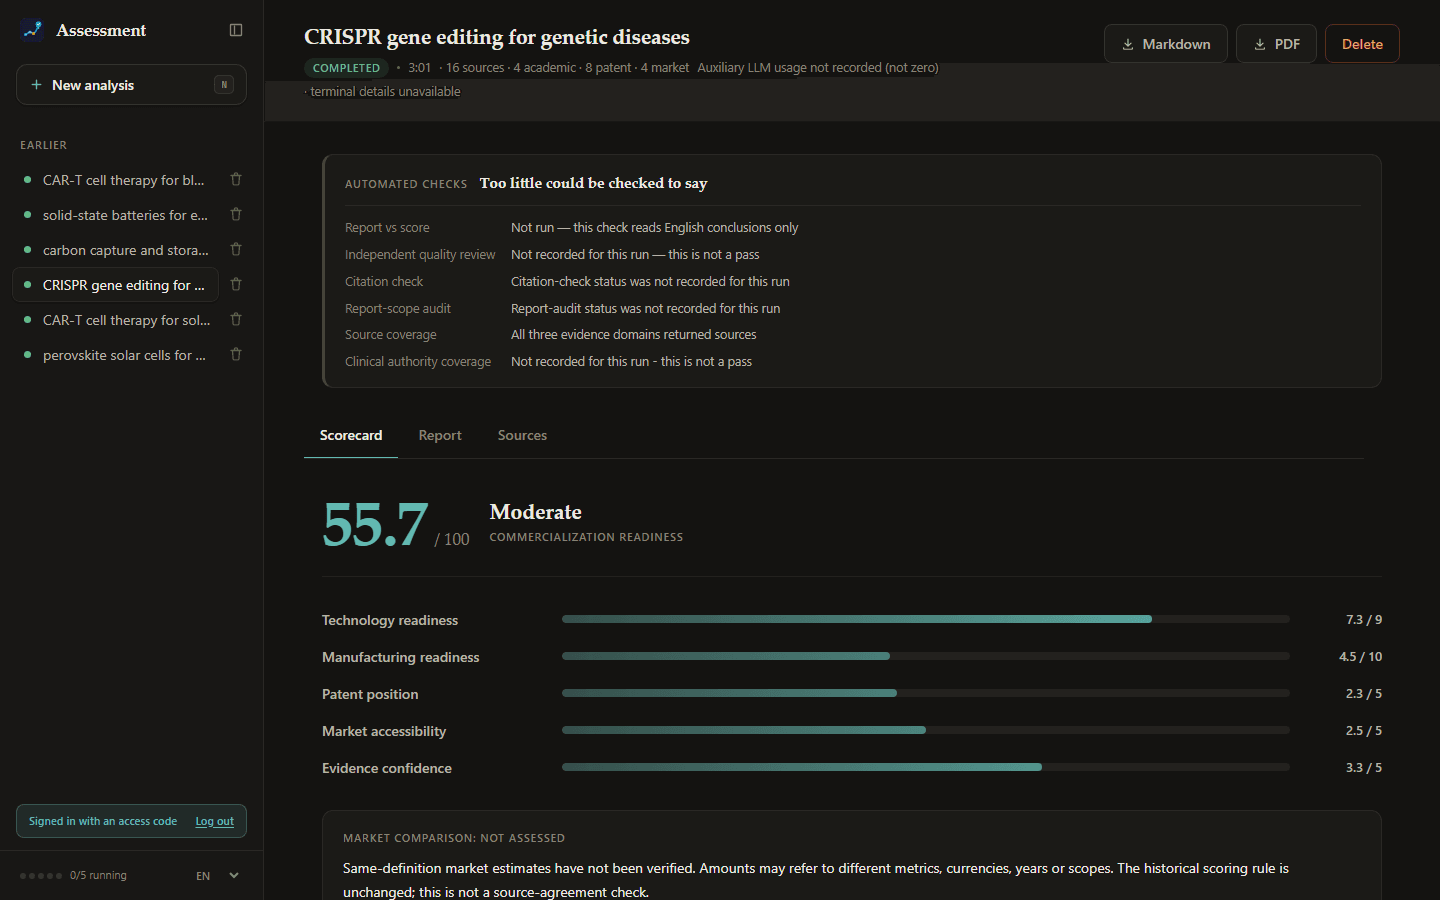
图:真实历史运行的结果界面,含自动检查面板、评分维度与来源计数(项目截图,2026-10-20 截取)
你是一家新能源车企的技术战略部。CEO 扔过来一份论文:「固态电池这个方向,我们该不该投?」
要回答这个问题,你需要:技术成熟度(TRL)到几级?能不能造?专利墙有多厚?市场进得去吗?证据够不够硬?
AI 写一份报告很容易。但真正的问题是——你怎么知道报告里的数字不是编的?
这个项目的作者 Jason Chai 把整件事的难点定位在这里:不是让 LLM 写得更像专家,而是让 LLM 无法编数字。
官方定位:"AI multi-agent tool that turns research papers into cited commercialization and tech-transfer assessments: TRL, patent landscape, market and risks."
技术栈:Python、CrewAI、FastAPI,加一个免构建的 JavaScript 客户端。
项目的核心设计原则写在 README 里:"Deterministic code retrieves and validates sources first; six LLM stages then reason over that frozen evidence. Autonomy is limited on purpose."
翻译过来:确定性代码先取材并验证,然后六个 LLM 阶段才在这份冻结的证据上推理。自主性被刻意限制。
传统做法是「让 AI 写报告」——你把论文丢进去,它结合训练知识写出一份漂亮的分析。数字从哪来的?不知道。引用的文献支持那个说法吗?不知道。
这个项目的流程像是司法鉴定:
关键那句话写在 README 里:"A valid citation ID does not establish that the source supports the claim." 一个合法的引用 ID 并不能证明来源支持了该主张——这是清醒到有点冷的表述。
Scorecard 覆盖五个维度:TRL(技术成熟度)、MRL(制造就绪度)、专利强度、市场可达性、证据置信度。加权总分由代码计算而非模型输出。
可选输入,用于区分「探索性摸底」与「某个具体主体的决策」,以及某个阈值是否已获决策负责人批准。这让同一套评分能适配不同决策场景。
README 写得很明确:报告支持研究筛选,但不是技术、法律、监管、投资或自由实施(FTO)尽调。
Web 应用在线可用:academic-commercialization-agent.up.railway.app,还有无需任何 Key 就能看的样例报告页 /samples(三份完成的评估,且不发起模型或搜索请求)。同样的报告在 examples/ 目录里,例如固态电池电动车那份(冻结在 2026-07-19 的版本)。
启动新分析需要运营方签发的访问码,或者 BYOK(自带 LLM API Key 与模型,加 Tavily 或 Serper 搜索 Key)。
本地运行:
docker compose up
compose 固定 PYTHON_VERSION: "3.12"(注释写明理由:「锁定而非 latest,这样重建的镜像能解析出与 lockfile 和 CI 矩阵测试过的同一解释器」)。Dockerfile 是两阶段构建,注释解释了分离原因:「CrewAI 及其传递依赖需要数分钟解析;不做这个拆分,改一个 .py 文件就要重装全部 26 个依赖」。还额外安装了 fonts-wqy-zenhei 中文字体(PDF 导出器要内嵌 CJK 字体,python:slim 不带)。
环境变量通过 env_file 从宿主 .env 读取,故意不烘焙进镜像层——注释说得很清楚:「镜像层对任何拉取镜像的人都是可读的,而这些 Key 是计费的」。
依赖:crewai[anthropic,tools]==1.14.7、fastapi>=0.115、httpx==0.28.1、pydantic>=2.0、reportlab>=4.0、pypdfium2>=4.0、uvicorn>=0.34,以及 OpenInference 的 anthropic/crewai/openai 三个 instrumentation 与 arize-phoenix-otel。
Web UI:有——FastAPI + 原生 HTML/CSS/ES modules(无框架),单应用副本。
硬件:CPU 2 核、内存 4GB 起、磁盘 5GB,不需要 GPU(推理走外部 API)。
作者自己下调了预期。 README 明确写:截图与样例是历史运行,既不代表当前模型准确率,也不是最新市场评估;期望 TRL 区间在早期观察后被调整过,所以这不是独立留出验证。
冻结基线:10 个主题 × 3 次实跑
| 检查项 | 结果 |
|---|---|
| 端到端完成 | 30/30 |
| TRL 校准 | 26/30 |
| 加权公式正确性 | 30/30 |
| 报告结构完整 | 30/30 |
| 无支撑的数字行 | 30 份报告中 0 |
作者自己强调:这些是不同的检查项,不是合并的准确率分数;「无引用数字」的代理指标也不能测量所有幻觉。10 个主题中有 7 个在三次运行中全部落入 TRL 区间。
留出检验(held-out check)更诚实:在 10 个全新主题上(区间由外部证据在运行前固定,模型 qwen3.7-plus,2026-10-18),21/30 落在区间内——这是预注册的「supported」阈值。但作者也指出分数向 7 压缩:没有一次得分超过 7,成熟、已部署的技术被低估。
这个「成熟技术被低估」的偏差很值得注意——它说明评分体系对新技术友好、对成熟技术不友好,而这恰恰是技术转移评估最需要准确的方向之一。
仓库结构混乱。 README 自己承认根目录有大量 Python 文件(benchmark.py、ablation.py、evidence_gap_phase2/3/4_audit.py 等),是「基准命令与冻结实验运行器,其协议绑定了路径,所以留在原地」,并强调没有一个是运行应用所必需的。这对新人相当不友好。
成本与配额。 新分析需要付费 Key 且按供应商计费;有持久每日配额——超出后无法运行。
访问码 vs BYOK。 运营方签发访问码意味着有中心化管控,BYOK 意味着完全自给自足,两种模式的可用性差异需要按场景选。
单作者项目。 4 位贡献者,2.0.0 版本。
这个项目在 AI 应用里属于少见的类型:不是「让 AI 做事」,而是「让 AI 在可验证的约束下做事」。
它的做法可以概括为一句话:把不可信的部分(模型输出)限制在可验证的部分(确定性代码、冻结证据、代码计算的分数)之内。
这个模式的价值随 AI 渗透深度上升而放大。在「让 AI 写代码」的场景里,编译器是天然的验证者;在「让 AI 做技术评估」的场景里,验证者必须由你自己提供——这就是为什么「确定性取材 + 冻结证据 + 代码算分」这套组合不可替代。
第二个值得学习的地方是作者对自己数据的态度:明确标注区间被调整过(所以不是独立留出)、明确区分不同检查项(所以不能加总成一个准确率)、明确指出分数压缩的方向性偏差(所以成熟技术被低估)、明确声明「无引用数字」不等于「无幻觉」。这种自我批评的密度,在开源 AI 项目里非常罕见。
第三个是成本与可靠性意识:付费请求的持久收据、断点续跑不覆盖原运行、最终状态只写一次、用量报告三态(完整/下界/不可得)——这些不是 AI 功能,是软件工程基本功,但恰恰是大多数 AI Demo 项目缺的东西。
对高校技术转移办公室与产业投资部门的现实价值:把「读论文判断能不能立项」从专家一周的案头工作,变成一份带证据登记、可复核、可追溯的初筛报告;对做 AI 应用的团队:这是「如何让 AI 输出的可信度可审计」的一份具体可抄的工程范本。
