
memonto
shihanwan/memonto加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
"记忆是灵魂的国会大厦。"——忘掉这句话吧,大多数 AI Agent 连昨天和你聊了什么都不记得。
想象一下这样的场景:你花了一个小时向 AI 助手详细介绍公司的技术架构、团队成员和项目进度。第二天再问它,它一脸茫然,仿佛你们从未交谈过。
这不是 AI 的"性格缺陷",而是工程层面的根本限制——大多数 AI Agent 缺乏持久记忆机制。上下文窗口(Context Window)就那么大,塞进去的信息有限,窗口一满,旧的记忆就被挤出去了。
Memonto 正是为解决这一痛点而生。它为 AI Agent 构建了一套基于**知识图谱(Knowledge Graph)**的长期记忆系统,让 AI 能够在多次会话中持续积累和利用信息。
Memonto(Memory + Ontology 的合成词)由独立开发者 shihanwan 创建,发布于 2024 年 9 月,目前在 GitHub 拥有 99 Stars 和 12 Forks。
项目的核心定位非常清晰:为 AI Agent 提供结构化、可查询、可推理的长期记忆能力。与简单的向量数据库存储方案不同,Memonto 选择了 RDF 知识图谱作为记忆的底层表示,这让它天然具备关系推理和语义查询的能力。
Memonto 采用**三元组存储(Triple Store)+ 向量存储(Vector Store)**的双引擎架构:
(张三,参加了,会议A)。支持 SPARQL 查询,可以精确回答"谁参加了哪个会议"这类关系型问题。两者协同工作:Triple Store 保证精确查询,向量存储加速语义检索。
Memonto 不需要你手动把信息转化为 RDF 三元组——它使用 LLM 来"理解"输入文本,自动从中提取符合预定义本体(Ontology)的结构化信息。
用户首先需要用 RDF 语法定义自己的本体(Ontology),声明关心的实体类型(如"人"、"会议"、"地点")和它们之间的关系(如"参加"、"位于")。然后 Memonto 会用 LLM 分析输入文本,只提取匹配到本体中的信息。
| 模块 | 功能 |
|---|---|
retain() | 将文本转化为 RDF 三元组并存入记忆 |
recall() | 基于上下文检索相关记忆,生成摘要 |
retrieve() | 原始查询,支持 SPARQL 和 Schema 两种方式 |
forget() | 删除记忆 |
auto_expand | 自动扩展本体,LLM 发现新实体类型时自动补充 Ontology |
Memonto 的设计哲学中最有趣的部分是**本体驱动(Ontology-Driven)**的记忆方式。
传统 RAG 系统把文档切成块,塞进向量数据库,检索时靠"相似性"碰运气。而 Memonto 要求你先定义关心的知识结构,再让 AI 从中提取信息。这意味着:
一行 pip 安装:
pip install memonto
以 Ephemeral 模式(无持久化存储,适合快速测试)为例:
from memonto import Memonto
from rdflib import Graph, Namespace, RDF, RDFS

# 定义本体
g = Graph()
HIST = Namespace("history:")
g.bind("hist", HIST)
g.add((HIST.Person, RDF.type, RDFS.Class))
g.add((HIST.Event, RDF.type, RDFS.Class))
g.add((HIST.Person, HIST.participatesIn, HIST.Event))

# 配置 LLM
memonto = Memonto(ontology=g, namespaces={"hist": HIST}, ephemeral=True)
memonto.configure({"model": {"provider": "openai", "config": {"model": "gpt-4o", "api_key": "..."}}})

# 存入记忆
memonto.retain("张三和李四在上周的技术大会上做了关于 RAG 的分享")

# 检索记忆
summary = memonto.recall("技术大会上的演讲者")
print(summary)
Memonto 代表了一个重要的技术方向——从"向量检索"到"知识图谱"的记忆范式转变。
随着 AI Agent 在企业场景的深入落地,"让 AI 记住什么、如何记住、如何查询"将成为核心工程问题。RDF 知识图谱方案虽然学习成本较高,但在需要精确推理和关系查询的场景下,远比纯向量检索更可靠。
Memonto 踩在了 Agent Memory 这个细分赛道的早期节点上,99 Stars 的体量虽然不大,但项目定位精准,技术选型有深度,值得持续关注。
 项目 Banner,Memonto 名称由 Memory 和 Ontology 合成
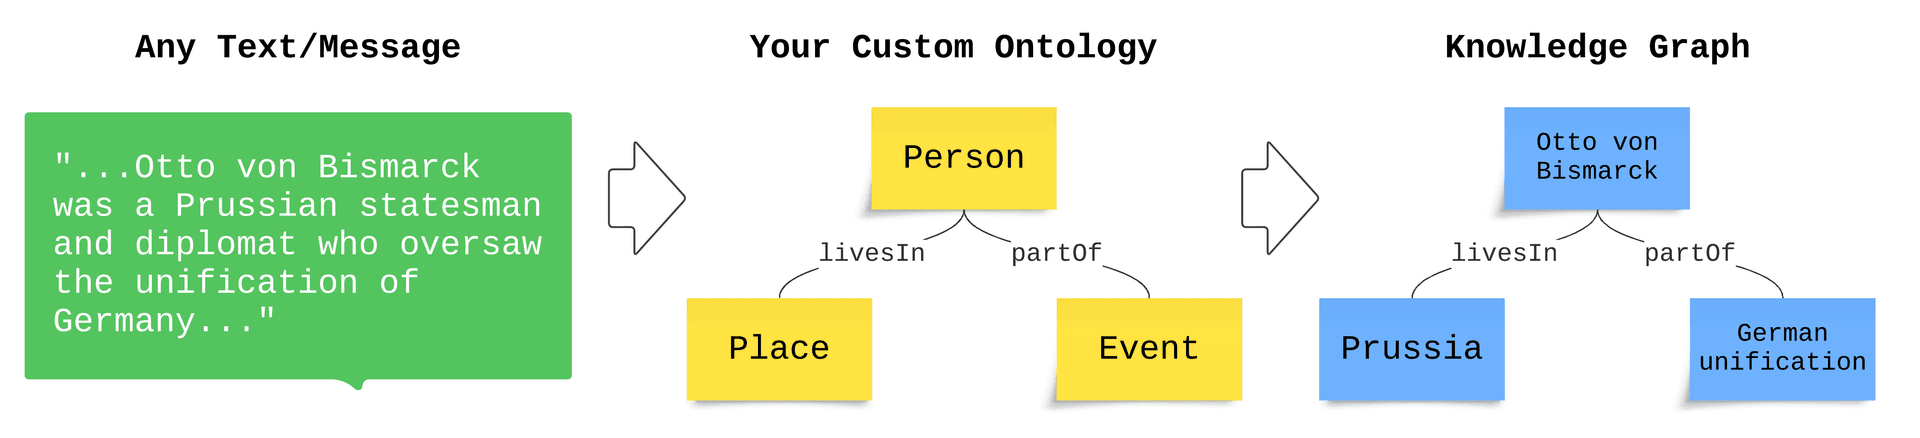 Memonto 工作流程:从非结构化文本到知识图谱的记忆提取与检索
