
ChatPDF
shibing624/ChatPDF加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
深夜赶论文,导师问:「你把这个 PDF 第三章的核心结论找出来。」你在键盘前愣了三秒——这是份 287 页的学术论文,而且你知道里面至少有三个地方提到了相关内容但措辞各不相同。
传统的 Ctrl+F 能告诉你关键词在哪一页,却无法告诉你哪个段落真正回答了这个问题。大多数市面上的 ChatPDF 工具需要你把文档上传到云端,数据隐私?文件安全?——不好意思,你的 PDF 可能已经在某个服务器上存了备份。
shibing624/ChatPDF 告诉你:本地跑,不需要云,不需要 LangChain,一行命令搞定。
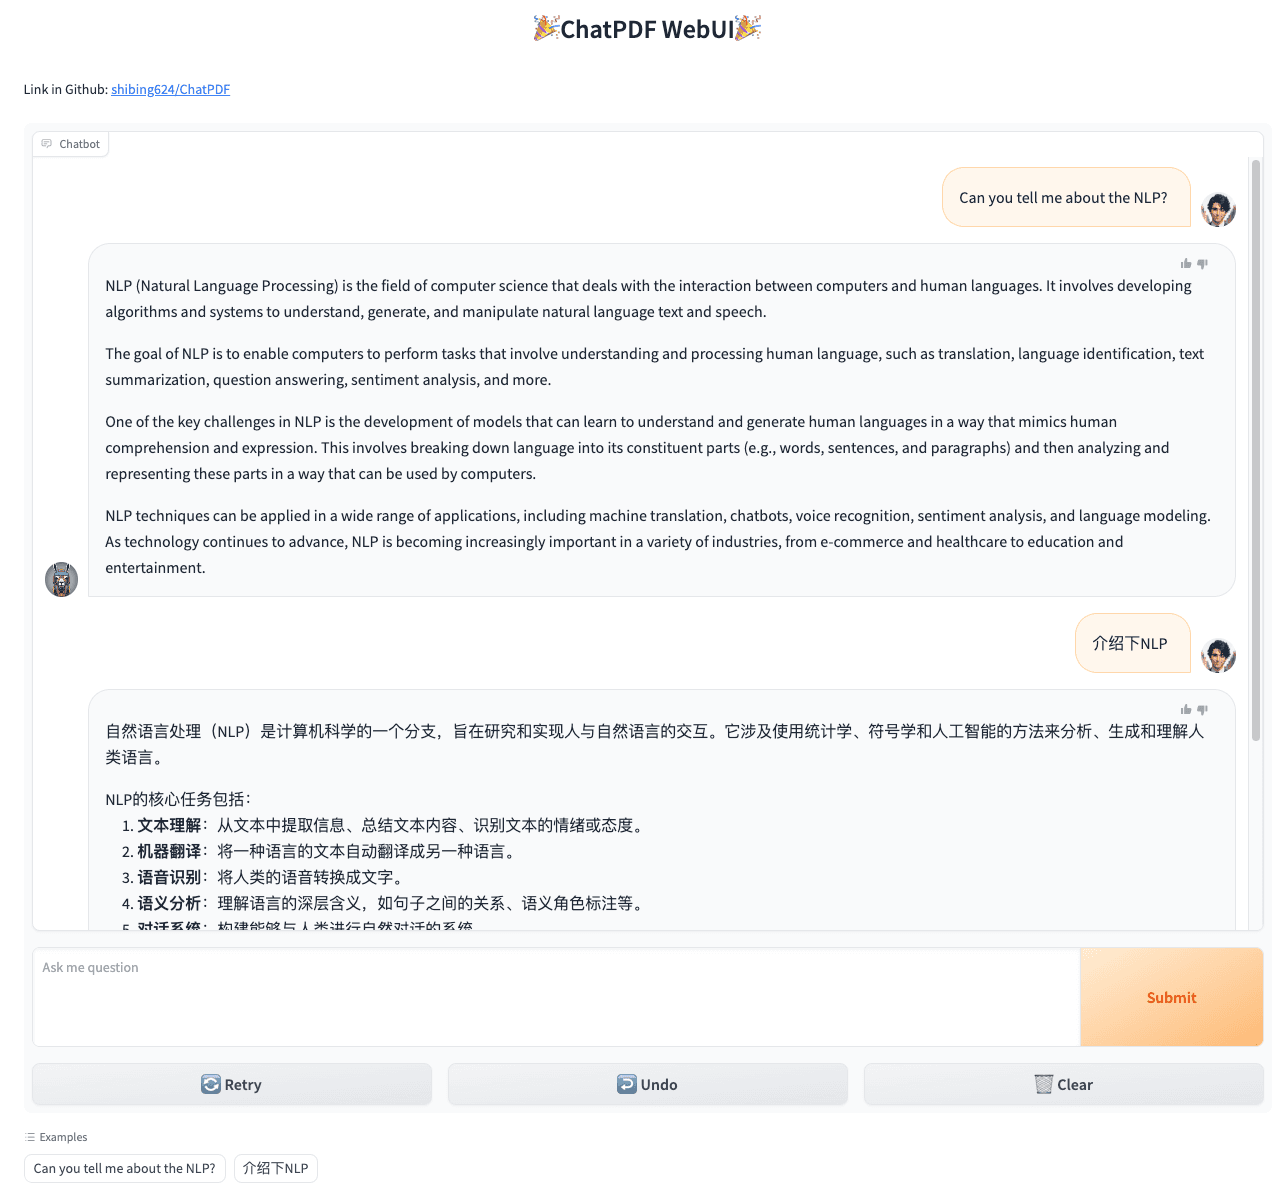
RAG(检索增强生成)的概念很简单:找到和问题最相关的文档片段,让大模型基于这些片段回答问题。但当你要处理的是私有文档——医疗记录、法律合同、内部技术报告——把文件上传到 OpenAI 的服务器就不太现实了。
本地 RAG 的核心挑战有三个:
ChatPDF 选择了一条务实路线:不引入 LangChain 等重型框架,所有 RAG 逻辑用纯 Python 实现,开发者可以一行一行看懂。
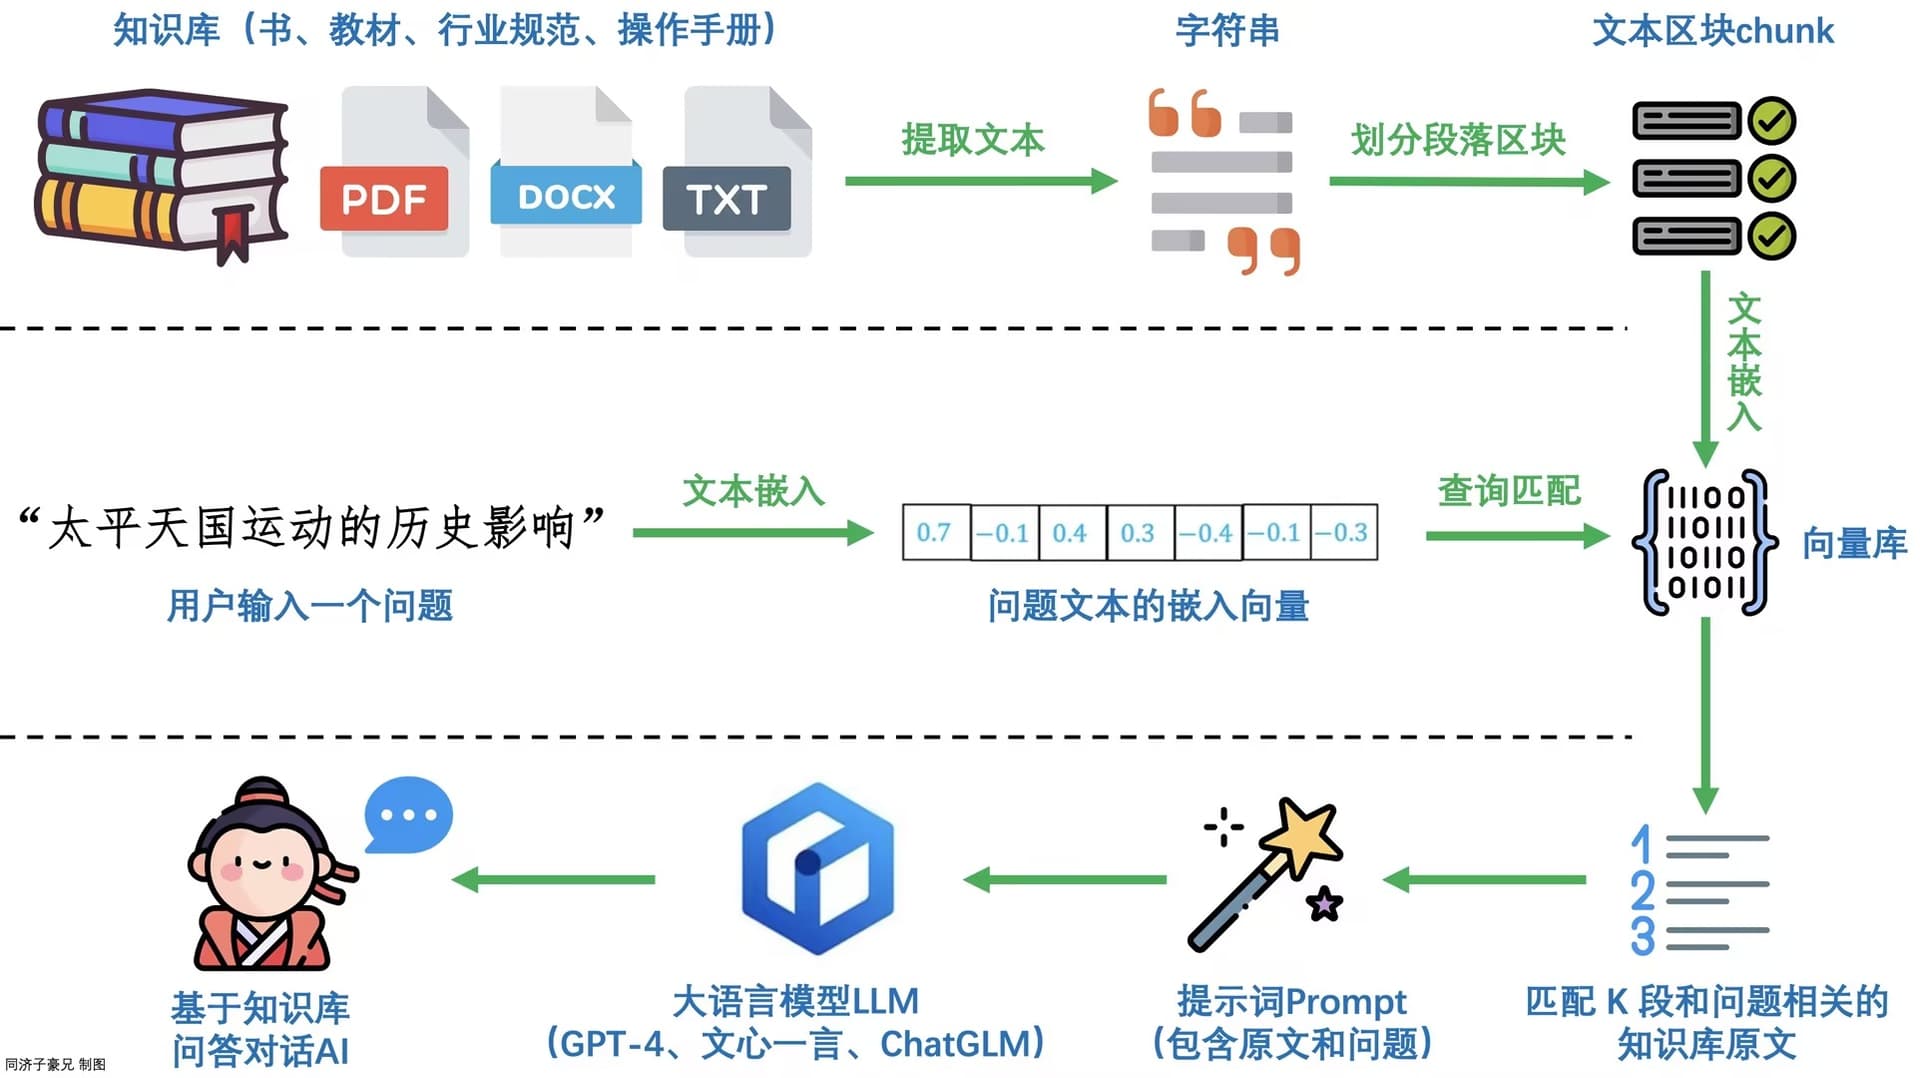
ChatPDF 的检索流程分为四个阶段,每一阶段都有明确的优化点:
第一阶段:文档解析(Chunking)
支持 PDF、docx、markdown、txt 四种格式。切分策略针对中英文混合文档做了专门优化(Chinese Chunk),不是简单按字符数切分,而是考虑句子边界和段落结构。
第二阶段:双路检索
系统同时维护两套检索索引:
两路结果加权合并,兼顾语义理解和关键词精确匹配。这是很多商业 RAG 系统采用的双塔思路,ChatPDF 在本地实现了它。
第三阶段:重排序(Rerank)
候选集过大时,reranker 模块对字面+语义检索的结果做二次排序,用 rerank_model_name_or_path 参数指定 rerank 模型。减少最终送入 LLM 的上下文窗口大小,降低 token 消耗。
第四阶段:上下文扩展
命中 chunk 前后扩展 num_expand_context_chunk 个额外段落,解决「答案被腰斩」的问题。这个细节很多开源 RAG 方案都没做。
除了基础 RAG,项目还实现了轻量版 GraphRAG,核心模块在 graphrag/ 目录下。
传统 RAG 按文本片段检索,适合「是什么」类问题。但当用户问「这家公司近三年的发展战略有什么变化?」——这类问题需要理解实体之间的关系和演变,传统 chunk 检索容易遗漏。
GraphRAG 的做法:先用 NLP 提取文档中的实体和关系,构建图结构(networkx),然后基于图结构做关系路径检索。当 query 涉及多跳推理时,图谱问答比纯文本检索有明显优势。
项目还提供了 Ollama 版本 graphrag_ollama_demo.py,在没有 OpenAI API key 的情况下也能跑通 GraphRAG 全流程。
ChatPDF 不绑定特定 LLM,通过统一接口支持:
| 后端 | 说明 |
|---|---|
| OpenAI API | GPT 系列,需配置 OPENAI_API_KEY |
| DeepSeek API | 性价比高,支持长上下文 |
| Ollama | 本地模型(Qwen、DeepSeek 等),完全离线 |
Embedding 模型同样支持多种选择:OpenAI Embedding、text2vec 本地模型、HuggingFace Embedding、sentence-transformers。开发者可以根据硬件条件和隐私需求自由组合。
命令行模式(rag.py)
适合有 Python 经验的用户。核心调用:
CUDA_VISIBLE_DEVICES=0 python rag.py
配置好 LLM 后,在命令行输入问题,即可在终端查看回答结果和引用来源。异步并发设计,多文档场景下响应速度不错。
Web 界面模式(webui.py)
基于 Gradio 开发,打开浏览器就能用:
python webui.py
# 访问 http://localhost:8082
支持流式输出,对话历史管理,多文件上传。Gradio 的进度条和状态提示做得比较完善,长文档解析时用户体验较好。
GPU 是必须的:虽然 Ollama 可以用 CPU 跑本地模型,但实际体验会明显卡顿。Embedding 模型 + LLM 双开,8GB VRAM 是底线,16GB 以上体验更好。
中文长文档效果依赖模型:底模的选择直接影响回答质量。通用 LLM 对学术 PDF 中的专业术语可能「一本正经胡说八道」,建议配合 generate_model_name_or_path 参数使用经过 RAG 微调的专用底模。
不支持多模态:PDF 中的图片和表格会被当作文本处理,无法理解图表内容。相比之下,GPT-4V 等多模态方案在复杂 PDF 场景下效果更好。
GraphRAG 有一定学习成本:图谱构建和查询需要理解实体抽取逻辑,配置项较多。demo 示例清晰,但生产环境调优需要一定时间。
ChatPDF 代表了本地 RAG 的一条务实路径:不追求框架完整,选择自己造轮子而非依赖 LangChain,最终成品代码量可控、逻辑透明。
作者 shibing624(徐明)在 NLP 领域有多年积累,同系列还有 MedicalGPT 等项目。这套 RAG pipeline 已经被不少中文 NLP 社区的开发者作为入门本地 RAG 的参考范本。
从增长曲线看,local-RAG 赛道正在从「极客玩具」向「企业级工具」演进。随着 embedding 模型和 LLM 的推理效率持续提升,未来在本地跑一个生产级文档问答系统的门槛会进一步降低。
