
ProPainter
sczhou/ProPainter加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
设想一个短视频团队接到一支被路过的卡车蹭掉的商品特写镜头。补拍成本高、上镜周期赶不上发布时间,唯一的出路是把那一块"脏"的地方抹掉,再让画面自己长回来。
这就是视频修复(Video Inpainting)的典型场景。输入是一段视频和一帧帧的遮罩,输出是"洞被补上"之后看起来从未受过伤的视频。听起来简单,做起来却是计算机视觉里出了名的地狱级任务——因为补上的内容不仅要空间上合理,还要在时间上保持一致。
ProPainter 是这个方向上被引用最多的开源基线之一,南洋理工大学 S-Lab 团队 Shangchen Zhou、Chongyi Li、Kelvin C.K. Chan 与 Chen Change Loy 的成果,发表于 ICCV 2023,论文编号 arXiv:2309.03897。截至目前仓库已积累 7020 星、818 个 fork,是这个细分方向的事实标准之一。
单张图像补洞,只要"补得像个合理的背景"就够了。但视频不一样。
想象你从路人手里接过一块遮挡画面的招牌,要把它从整段连续运动中抹掉。你会发现这块招牌遮住的东西在每一帧都不一样:招牌后面可能是停在路边的汽车,也可能是正在走过的人,还有可能是随镜头推移而变化的远处树影。如果只盯着当前帧找相似像素,很容易把错误的内容补进去。
更麻烦的是运动。镜头在动、物体在动、被遮挡的背景也在动。所有这些运动必须保持时间连续性——否则会出现那种让人瞬间出戏的"果冻感":补出来的区域像果冻一样颤动。
ProPainter 的论文标题就是答案的一半:"Improving Propagation and Transformer for Video Inpainting"——传播(Propagation)与 Transformer。
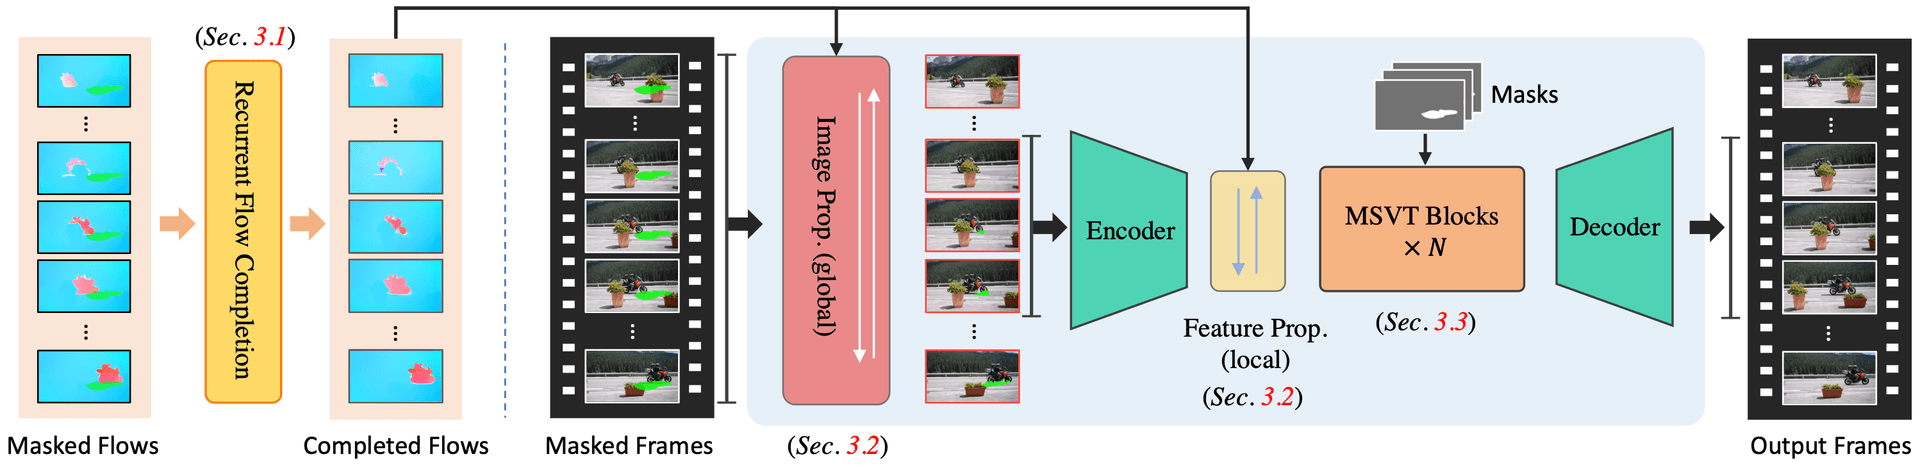
光流(optical flow)可以理解为"像素的运动轨迹"。ProPainter 先训练一个专门的循环网络,把被遮罩挡住的那部分运动轨迹"猜"出来并补全。
生活比喻:你看一段有人走过你面前遮挡了视野的录像,虽然看不到他身后发生了什么,但你从遮挡边缘的运动方向能推断出后面大致有什么。循环网络就是那个"从边缘推断内部"的大脑。
补全后的流场被用来在两个层面搬运像素:一是图像域(原始 RGB 像素),二是特征域(深度网络学出来的抽象特征)。两者联合训练。
比喻:这就像记忆有两套系统——"看到过原图的具体细节"和"知道那大概是个什么形状"。只依赖其中一套都容易出错,双管齐下更稳。
Transformer 擅长长程关系建模,但把所有视频 token 全丢进注意力窗口,计算量爆炸。ProPainter 用遮罩引导,只在真正需要补的区域上计算注意力。
比喻:不是把整本书每个字都重新分析一遍,而是只精读"被撕掉的那几页",同时保留对全文的记忆。
仓库自带两组示例,输入目录 inputs/ 下有现成素材。
物体移除(Object Removal)——给一段视频和逐帧遮罩,把不想出现的物体抹掉:
python inference_propainter.py --video inputs/object_removal/bmx-trees --mask inputs/object_removal/bmx-trees_mask
视频补全(Video Completion)——遮罩是程序生成的方形区域,内容完全靠模型推断:
python inference_propainter.py --video inputs/video_completion/running_car.mp4 \
  --mask inputs/video_completion/mask_square.png --height 240 --width 432
除了这两个官方案例,README 还列出了一系列社区衍生项目:流式版本 Faster ProPainter、ComfyUI 节点、ProPainter WebUI,以及基于它做角色迁移的 Cinetransfer 和 Motionshop。生态相当活跃。
conda create -n propainter python=3.8 -y
conda activate propainter
pip3 install -r requirements.txt
预训练权重从 Releases v0.1.0 下载放进 weights/ 目录(ProPainter.pth、recurrent_flow_completion.pth、raft-things.pth),首次推理时也会自动下载。核心依赖是 PyTorch >= 1.7.1、Torchvision >= 0.8.2、CUDA >= 9.2,以及 einops、timm、opencv-python 等一票常规库。
web-demos/hugging_face/ 下是完整的 Gradio 应用,支持用画笔或点选交互式生成遮罩,2026.10.27 的更新还接入了 SAM 2.1 做交互式视频分割(需要额外下载 SAM-2 权重)。本地运行需要 Python 3.10+、torch 2.8.0、gradio 6.9.0。
在线体验:Hugging Face Spaces 与 OpenXLab 都已上线,不用装任何东西。
官方给出的显存参考表非常直观(fp32 / fp16):
| 分辨率 | 50 帧 | 80 帧 |
|---|---|---|
| 1280 x 720 | 28G / 19G | OOM / 25G |
| 720 x 480 | 11G / 7G | 13G / 8G |
| 640 x 480 | 10G / 6G | 12G / 7G |
| 320 x 240 | 3G / 2G | 4G / 3G |
处理 720p 视频,单帧处理就要吃掉 11GB 显存起步。消费级显卡(12GB 以内)在 720p 上会直接 OOM。
省显存的手段很直接:--neighbor_length 调小减少局部邻居、--ref_stride 调大减少全局参考帧、--resize_ratio 降分辨率、--fp16 半精度、--subvideo_length 缩短子视频长度(默认 80 帧,这个参数把显存开销和视频长度解耦,是最有效的开关)。
许可证是硬门槛。 GitHub API 返回的 license 字段是 NOASSERTION,因为它不是标准 SPDX 许可证——实际是 NTU S-Lab License 1.0,明确限定"仅限非商业用途"。任何商业场景(接单、广告、影视修补、对外 SaaS)都需要单独联系作者取得授权。这是落地前必须先解决的法律问题。
作者主动下架了水印移除演示。 2023.09.24 更新明确写明"官方移除水印移除演示,以防止我们的工作被不道德地使用"。仓库 topics 里至今仍留着 watermark-removal,但功能已不再公开演示。这个决定本身值得尊重,但也意味着能力仍在、只是不再推广。
训练成本不低。 训练需要在 YouTube-VOS(3471 个训练视频)上跑两阶段(先训流补全网络,再训 ProPainter),还要用 scripts/compute_flow.py 预计算光流。复现论文指标需要 DAVIS-2017 480p 与论文提供的遮罩数据。
模型更新停滞。 主代码自 2023 年发布后基本未动(pushed_at 的近期更新主要来自社区维护的 Gradio demo 依赖升级,比如 torch 2.8 / gradio 6.9 / SAM 2.1 适配)。基座模型迭代有限。
生态依赖社区续命。 ProPainter WebUI、ComfyUI 节点、Faster ProPainter 这些关键体验层都由社区维护,官方不背书,质量参差。
把 ProPainter 放进近几年的视频编辑版图,可以看到一条明确的技术路线:
从 2023 年 9 月开源至今两年多,7020 星、387 个文件、活跃的社区衍生生态,说明它已经稳稳占据了视频修复开源基线的位置。
适合的场景:影视/广告素材修补、旧素材修复、非商业创作辅助、内容审核中的敏感元素遮挡。
不适合的场景:任何商业授权未澄清前的生产使用;以及没有 NVIDIA GPU 的环境——纯 CPU 跑视频扩散级模型不现实。
落地路径建议:
技术栈:PyTorch、OpenCV、einops、timm、Gradio;模型代码在 model/,训练与数据加载在 core/,工具函数在 utils/,数据集为 DAVIS 2017 与 YouTube-VOS。
论文:Zhou et al., "ProPainter: Improving Propagation and Transformer for Video Inpainting", ICCV 2023, arXiv:2309.03897 许可证:NTU S-Lab License 1.0(仅限非商业用途)
