
Vision-language-models-VLM
sayedmohamedscu/Vision-language-models-VLM加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:你在医院放射科工作,手头有上千张胸片,需要训练一个 AI 模型来辅助筛查肺部疾病。传统方案是找算法团队从头训练,耗时数周、费用高昂。但现在,有一位开发者 sayedmohamedscu 分享了一套可以直接在 Google Colab 上运行的微调笔记本,涵盖 PaLIGemma、Florence-2 和 MedGemma 三个当前最受关注的视觉语言模型,让这一切变得触手可及。
这就是 Vision-Language-Models-VLM 开源项目 —— 一个专注于视觉语言模型微调的实战笔记本集合。
视觉语言模型(Vision-Language Models,VLMs)是 2023-2024 年 AI 领域最活跃的方向之一。与传统计算机视觉模型只能"识别"图像不同,VLMs 将视觉理解与语言生成融为一体,能够根据图片回答问题、生成描述、执行复杂的多模态推理。
这个项目的核心价值在于降低微调门槛。PaLIGemma(Google 的图像问答模型)、Florence-2(微软的多任务视觉基础模型)和 MedGemma(专门针对医学影像优化的变体)都是学术界和工业界高度关注的模型,但它们的官方仓库通常只提供预训练权重和基础推理代码,缺乏系统性的微调指南。本项目填补了这一空白。
理解 VLM 的工作原理,是理解这个项目的钥匙。从架构上说,一个典型的 VLM 包含四个核心组件:
图像编码器(Image Encoder) 负责将输入图像转换为高维向量表示。项目涉及的模型使用不同的编码器:PaLIGemma 采用 SigLIP(Google 的图像-语言对比学习模型),Florence-2 可能基于 FLD-VL(Florence 视觉编码器),MedGemma 则继承了 медицински 优化的编码器策略。这些编码器将原始像素数据压缩为捕捉图像语义特征的向量。
投影层(Projection Layer) 是连接视觉空间和语言空间的桥梁。由于图像编码器输出的向量空间与语言模型的词嵌入空间天然不兼容,投影层(一个小型神经网络)负责将图像向量映射到与文本嵌入兼容的空间。这一步的质量直接影响最终模型的多模态理解能力。
文本嵌入合并(Text Embedding Merger) 将投影后的图像向量与用户输入的文本嵌入拼接在一起,形成一个统一的多模态表示。模型据此理解"用户想让我看图片的哪部分、问什么问题"。
语言模型(Language Model) 接收合并后的多模态嵌入,自回归生成文本回答。这决定了模型能否生成连贯、准确、符合上下文的结果。
本项目的三个 Notebook 分别针对这三个模型提供了完整的微调流程,包括数据集准备(支持自定义数据集)、LoRA 高效微调配置(降低显存占用)、以及实际任务案例(如电表 OCR 读数、医疗影像分类)。
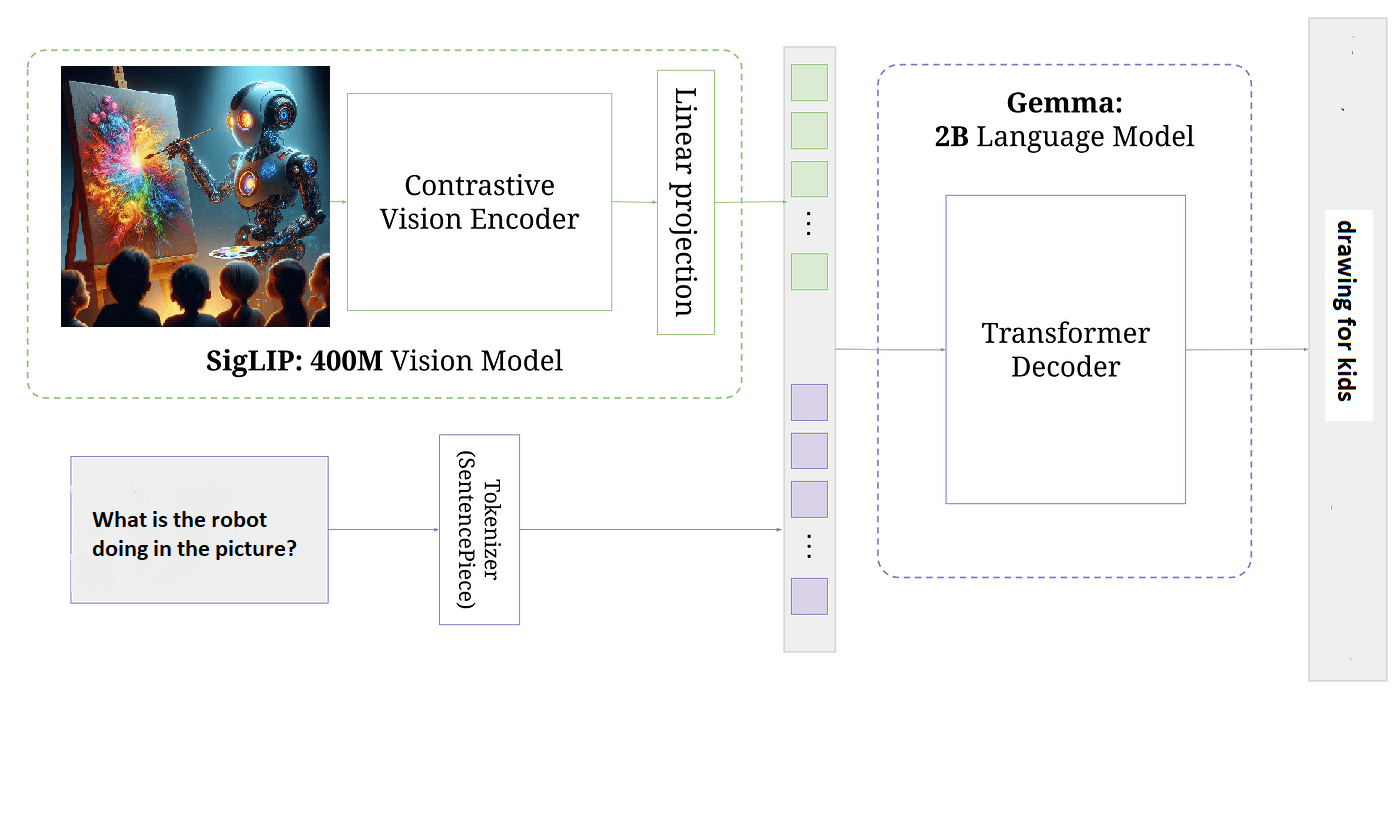 PaLIGemma 模型结构示意:图像编码 + 投影层 + 语言模型
项目提供了三个代表性案例,分别对应不同的应用场景:
PaLIGemma 电表 OCR 演示了如何用自定义数据集微调 PaLIGemma,实现从电表图片中自动读取数值的功能。这实际上是工业自动化的经典场景——传统方案需要专门训练的 OCR 模型,而 VLM 可以直接理解图像上下文,泛化能力更强。
Florence-2 多任务微调 则展示了 Florence-2 的灵活性。Florence-2 被设计为一个统一的视觉基础模型,可以通过微调适配目标检测、图像描述、OCR 等多种任务。项目中的 Notebook 演示了针对特定指标读数识别任务的微调方法。
MedGemma 医学影像 是最具实际价值的案例。MedGemma 是基于 Gemma(Google 的开源 LLM)针对医学领域微调的 VLM。项目中的 Notebook 演示了如何利用胸部 X 光片数据集进行微调,使其具备医学影像分析能力。这个案例直接指向了 AI 辅助医疗诊断的真实需求。
 Florence-2 支持的多任务视觉场景
项目设计为完全在 Google Colab 上运行,对硬件要求相对友好:
| 模型 | 推荐 Colab 类型 | 显存需求 | 典型微调时间 |
|---|---|---|---|
| PaLIGemma 3B | Colab Pro (A100) | ~16GB | 1-2 小时 |
| PaLIGemma 9B | Colab Pro+ (A100 40GB) | ~32GB | 3-4 小时 |
| Florence-2 | Colab T4/A100 | ~12GB | 1-2 小时 |
| MedGemma 4B | Colab Pro (A100) | ~20GB | 2-3 小时 |
运行步骤非常直接:打开对应的 Colab 链接 → 连接 GPU 运行时 → 按照 Notebook 中的说明准备数据集(支持自定义 CSV/JSONL 格式)→ 配置 LoRA 微调参数 → 开始训练。所有 Notebook 都提供了详细的注释,降低了理解门槛。
需要注意的是,自定义数据集的格式转换是实际使用中的主要挑战。每个 Notebook 都有特定的数据格式要求(PaLIGemma 偏好图像-文本对格式,Florence-2 支持更灵活的任务描述格式),初次使用需要仔细阅读数据准备部分的说明。
作为一个非官方教程项目,存在几个值得关注的局限:
无许可证保护:项目没有明确的开源许可证,这意味着代码的法律状态不明确。商用前需自行审查代码来源和依赖许可。
无版本管理:三个 Notebook 分散管理,缺乏统一的版本追踪。如果上游模型 API 发生变化(如 HuggingFace 的 transformers 库更新),Notebook 可能需要手动调整。
数据隐私考量:微调医学影像数据涉及敏感个人信息。使用 MedGemma Notebook 处理真实患者数据时,必须确保符合 HIPAA 等医疗数据合规要求。
显存门槛:虽然使用了 LoRA 高效微调技术,16GB 显存仍是最基本的门槛。对于没有 Colab Pro 或高端 GPU 的开发者,实际使用仍有障碍。
从更宏观的视角看,这个项目反映了 2024 年 AI 发展的一个重要趋势:多模态模型的微调正在从研究机构下沉到独立开发者和小型团队。PaLIGemma、Florence-2 和 MedGemma 都提供了相对易用的 HuggingFace 接口,配合 LoRA 等高效微调技术,使得在消费级 GPU 上微调百亿参数视觉语言模型成为可能。
项目当前 63 颗 GitHub Stars 的规模相对较小,但增长势头值得关注。考虑到 VLM 微调需求的持续增长(医疗影像、工业检测、内容审核等垂直领域都有强烈需求),这类实战型教程项目的重要性将持续提升。
