
kektordb
sanonone/kektordb加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景: 你和 Claude、Cursor 或 OpenCode 聊了一个星期,AI 记住了你叫陈工、做 Go 项目、喜欢简洁回复。但当你关掉对话窗口、第二天重新打开时,一切归零——记忆荡然无存。这不是 AI 的缺陷,而是当前所有 AI Agent 的共同困境:缺乏持久记忆机制。
KektorDB 正是为解决这一问题而生的开源项目——它不仅仅是一个向量数据库,而是一个具备认知能力的 AI 记忆引擎,将 HNSW 高性能向量检索、时间感知知识图谱和自管理的认知层融为一体。
图:KektorDB 项目标识
KektorDB 的作者 sanonone 是一个全职开发者,在构建 AI Agent 应用时,频繁遇到一个痛点:每次对话都是"从零开始",AI 无法积累用户偏好、项目背景或历史决策。他开始寻找现成方案,发现传统向量数据库(Milvus、Qdrant、ChromaDB)只解决"存储"问题,不解决"理解"问题——它们存得下向量,却不知道这些向量代表什么、哪些重要、哪些已经过时。
于是他用 Go 语言从零构建了 KektorDB,定位是"AI 的海马体":不仅要记住,还要理解、归纳、遗忘不需要的、发现冲突的。这个项目在 GitHub 上迅速获得 82 颗星,吸引了来自 AI 开发者、RAG 系统构建者、多 Agent 协作框架等多个社区的关注。
KektorDB 的内部架构分为三个层次,理解它们各自的职责,是掌握这个工具的关键。
第一层:向量检索引擎(HNSW)
这是整个系统的底层基础设施。KektorDB 实现了 HNSW(Hierarchical Navigable Small World)图算法,作为向量相似度检索的核心。HNSW 是一种近似最近邻搜索算法,在保证检索精度的同时,将搜索复杂度从 O(n) 降低到 O(log n),非常适合大规模向量场景。
对比 Qdrant 和 ChromaDB 的官方基准测试(桌面 Intel i5-12500 + 消费级 SSD)显示,KektorDB 在 NLP 查询上达到 1073 QPS,Vision 查询 881 QPS,Recall@10 为 0.97,全面优于对比数据库,且专为嵌入式单节点场景优化。
第二层:时间感知知识图谱
在向量之上,KektorDB 构建了一个加权属性图(Property Graph)作为关系层。这个图不是静态的,而是时间感知的——可以查询任意历史时间点的知识状态。节点之间的边有权重,支持 N 跳遍历和双向 BFS 路径发现。更重要的是,图中的实体可以脱离向量独立存在——用户画像、会话记录、抽象概念等都可以用纯图结构表达。
第三层:认知引擎(Gardener)
这是 KektorDB 最有特色的部分。Gardener 是一个后台进程,持续分析知识图谱,执行 11 种专业检测器的工作:发现重复记忆的合并、检测新旧事实之间的矛盾、识别知识空白、自动构建用户画像等。
Gardener 有三种运行模式:基础模式(无需 LLM,仅图结构和数学检测器)、高级模式(+ LLM 驱动的矛盾分析)、元认知模式(对自身认知过程的分析)。这种分层设计让用户可以根据需求和成本自由选择。
认知评分体系(Epistemic Engine)
KektorDB 为每条记忆分配一个认知评分,基于三个数学支柱:共识(Consensus)40%、稳定性(Stability)30%、摩擦力(Friction)30%。这套评分框架将记忆分为四类状态:结晶态(Crystallized,事实稳固)、稳定态(Stable,置信度高)、不稳定态(Volatile,随时可能变化)、争议态(Contested,存在矛盾)。开发者可以通过 REST API /vector/actions/belief-assessment 查询任意记忆的认知状态。
语义版本控制(Semantic Git)
当一条记忆被更新时,KektorDB 不会直接覆盖旧值,而是创建新版本并通过 superseded_by / evolves_from 两条边与旧版本链接,旧版本标记 _is_historical=true。这意味着你可以查询"2024年12月的项目计划是什么"——这不是一个数据库该有的能力,却是 AI Agent 持续成长的关键。
记忆衰减(Time-Aware Memory)
KektorDB 实现了多种衰减模型:指数衰减、线性衰减、阶梯衰减和艾宾浩斯衰减。用户可以为不同的记忆层配置不同的衰减策略:情景记忆(Episodic,72小时半衰期)、语义记忆(Semantic,720小时半衰期)、程序记忆(Procedural,永不衰减)。核心事实可以"固定"(Pinned)以防止任何衰减。
矛盾检测(Contradiction Detection)
Gardener 在高级模式下使用 LLM 分析,当新输入与已有事实冲突时,自动将矛盾节点标记为 Contested 状态。Agent 可以通过 check_subconscious 工具主动查询待处理矛盾,自主决定是接受新信息还是保留原有判断。这是 AI Agent 具备"自我反思"能力的基础设施。
零配置 RAG(AI Gateway)
KektorDB 内置一个 HTTP 代理模式,只需配置 proxy.yaml 指向 Chat UI 和 LLM 后端(如 Ollama),即可实现零代码 RAG。代理支持 Gemini 嵌入模型,内置 HyDE(假设性文档嵌入)和混合检索(70% 向量 + 30% 关键词),无需一行代码即可将 Chat UI 升级为具备记忆能力的 AI 对话系统。
方式一:MCP Server(推荐给 AI Agent 用户)
MCP(Model Context Protocol)是 Anthropic 提出的 Agent 上下文协议,KektorDB 实现了完整的 MCP 服务器。安装并启动后,Claude Desktop、Cursor、OpenCode、Codex 等支持 MCP 的 AI 工具即可直接调用 49 个 Agent 专用工具(包括 save_memory、recall_memory、start_session、get_user_profile 等),以及 8 个管理工具(total=57)。记忆跨会话持久化,Agent 每次启动都能"记住"之前的上下文。
方式二:REST Server(适合任何语言的开发者)
最通用的接入方式。KektorDB 编译为单文件二进制,启动后提供完整的 REST API,支持向量 CRUD、知识图谱操作、认知查询、会话管理、编译制品等。API 风格清晰,文档详尽(DOCUMENTATION.md 超过 67KB),适合集成到任何技术栈。
方式三:Go 嵌入式库(零网络开销)
对于对性能有极致要求的场景,KektorDB 可以作为 Go 库直接嵌入应用进程内,完全消除网络延迟。所有核心功能(向量引擎、知识图谱、认知引擎)都通过 github.com/sanonone/kektordb/pkg/engine 包暴露,API 设计简洁,符合 Go 惯用风格。
内置嵌入模型(零依赖)
KektorDB 包含一个可选的内置 ONNX 嵌入器(all-MiniLM-L6-v2,384维),由 Rust/Candle 底层驱动。构建时添加 -tags rust 即可启用,无需 Ollama、无需 OpenAI API,第一行代码就能跑通向量检索。
KektorDB 提供多阶段构建的 Dockerfile,基于 Go 1.26 Alpine 编译,最终镜像为精简的 Alpine,暴露 9091(主服务)和 9092(代理)两个端口。Dockerfile 规范,数据目录通过 VOLUME 挂载。
由于缺少 docker-compose.yml,无法一键启动完整服务栈(需要手动编排 Ollama/Gemini 等外部依赖),因此 quick_deploy 判定为 partially_supported。部署难度中等,需要准备 Go 1.26+ 环境(若从源码编译)或 Docker 环境(若使用容器)。硬件需求友好——GPU 非必须,CPU 足够运行内置 ONNX 嵌入器,RAM 建议 4GB 以上。
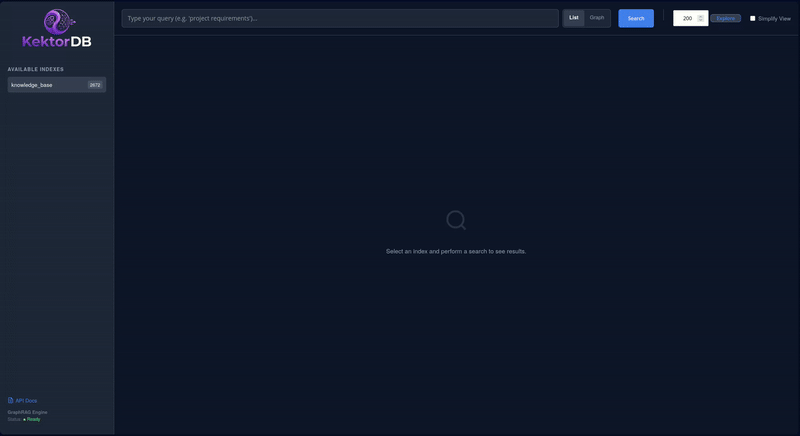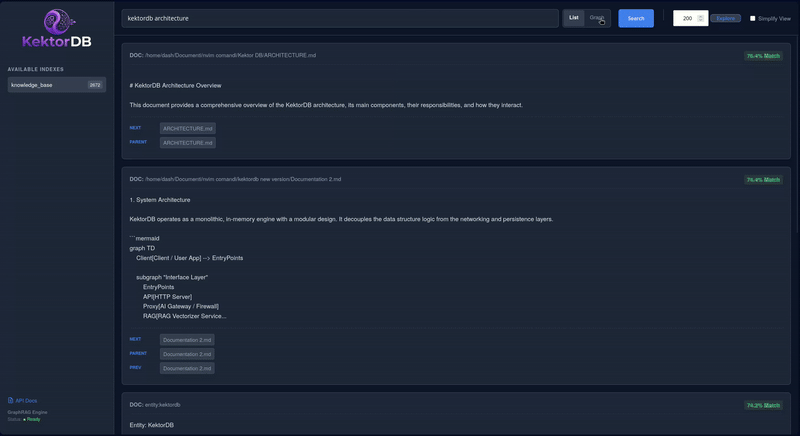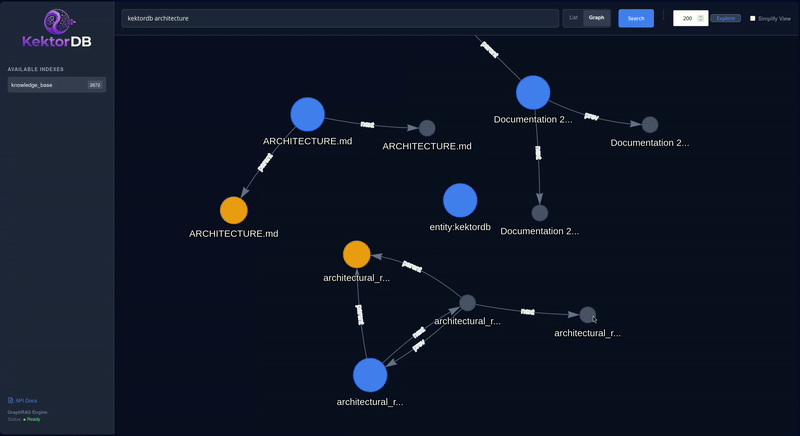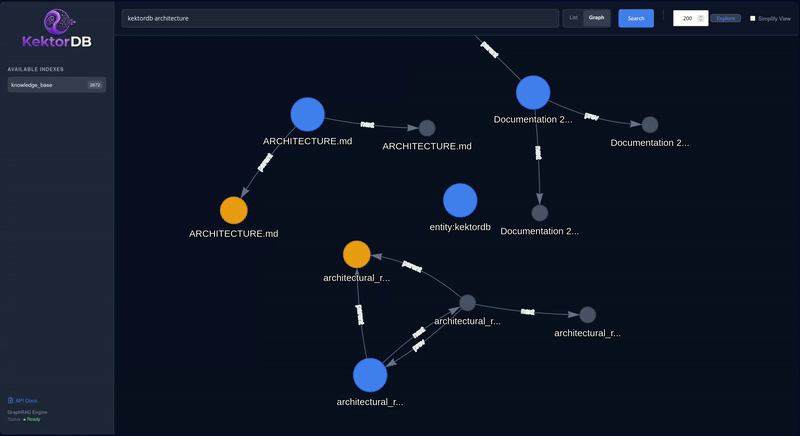
图:KektorDB 操作演示
单节点限制
KektorDB 明确标注"不支持集群",只适合垂直扩展。对于需要分布式部署的亿级向量场景,当前版本无法满足。不过项目 roadmap 中提到了 SIMD/AVX 优化方向,团队也在考虑未来支持。
许可复杂性
虽然项目整体使用 Apache 2.0 许可,但根目录包含 eng.traineddata(5199KB)和 LICENSE(11463B)文件,且根目录的 LICENSE 文件不是标准的 Apache 2.0——仔细检查后发现根目录 LICENSE 包含了额外条款,许可使用前需仔细阅读。
LLM 依赖的双刃剑
Gardener 的高级模式和矛盾检测依赖外部 LLM(Gemini/Ollama),这意味着认知功能的深度与 LLM 的可用性和成本直接挂钩。基础模式虽然不依赖 LLM,但功能相对有限。
KektorDB 的出现代表了一个趋势:AI Agent 需要专门的数据基础设施。传统数据库解决"存什么"的问题,KektorDB 进一步回答"记什么、记多久、怎么关联、如何判断置信度"。随着多 Agent 协作框架(如 AutoGPT、MCP)逐渐成熟,对持久记忆、矛盾检测、用户画像的需求会越来越强烈。
从技术选型看,KektorDB 选择 Go 语言是务实的——高性能、并发友好、编译为单一静态二进制,天然适合需要长期运行的后台服务。内置 ONNX 支持也降低了用户的使用门槛,无需额外维护 embedding 服务。
总体而言,KektorDB 是一个有深度、有特色、边界清晰的开源项目。它不是万能的数据库替代品,但在 AI Agent 记忆增强这个细分赛道上,提供了目前最完整的开源解决方案。如果你正在构建需要"记住用户、记住项目、记住上下文"的 AI 应用,KektorDB 值得深入研究。
