
markup
samueldobbie/markup加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象你手上有 500 份出院小结,每份里散落着药名、剂量、频次、并发症,但它们只是一段段连续的中文段落。要拿这些数据去训一个抽取模型,你得让懂医学的人先把这些信息一条条框出来。经验丰富的标注员处理一份含 41 个数据元素的文档,平均要 15 到 30 分钟——这是整个 AI 项目里最贵的、最容易拖垮进度的一环。
Markup 就是为这件事造的工具:打开浏览器,划一段文字,它就告诉你"这大概是 Prescription,剂量 10,单位 mg,一天两次",你点确认或者改一下就行。
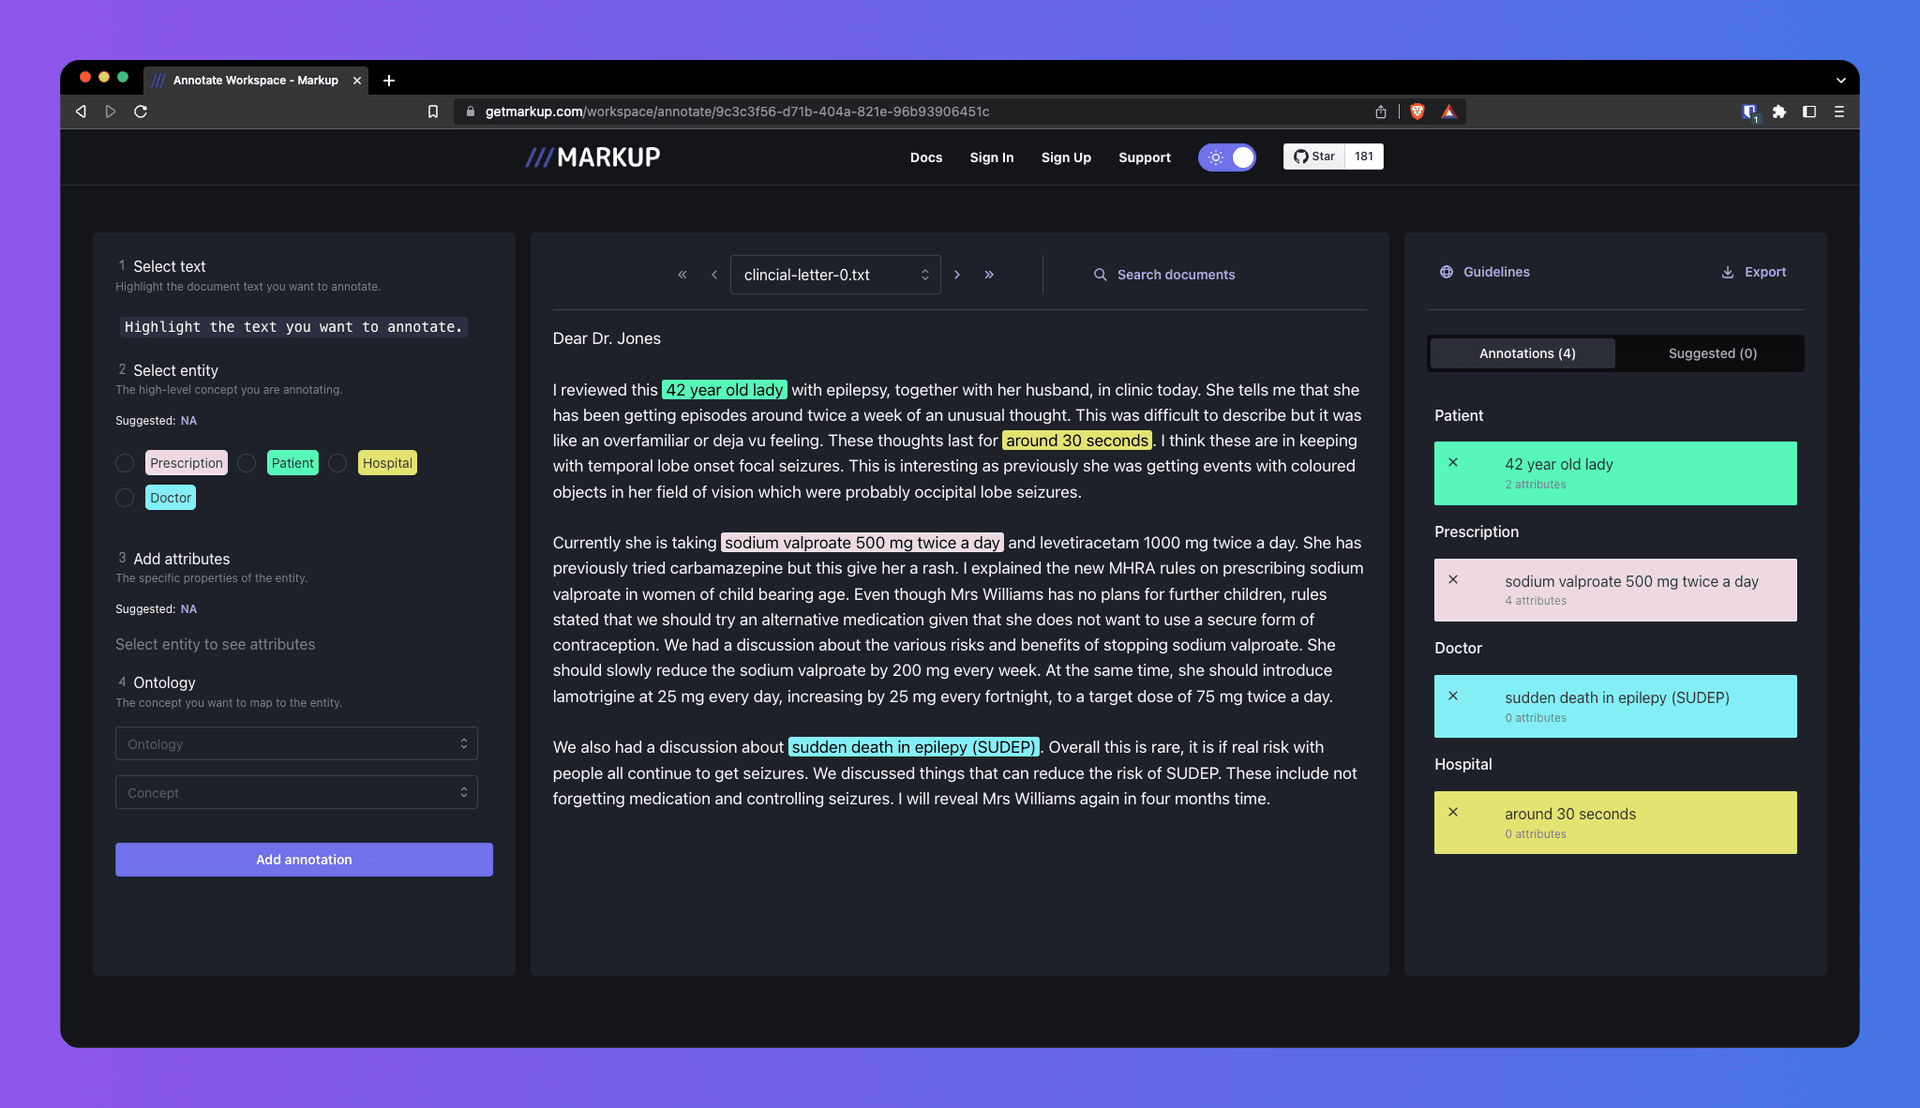
Markup 最早由英国斯旺西大学的 Samuel Dobbie 在 2019 年 2 月开源,2020 年 4 月在 Hacker News 上以 "Show HN: An annotation tool for ML and NLP" 亮相,定位很直白——做一个"比 Prodigy 好用、但不要 400 美元年费"的替代品。它的学术版本《Markup: A Web-Based Annotation Tool Powered by Active Learning》后来发表在 Frontiers in Digital Health 上,被医疗信息学界当成 Web 标注工具的参照实现之一。
有意思的是,这七年间它换过一次"发动机"。论文里的原始架构是纯机器学习方案:Random Forest 分类器先从文档里挑出"含处方信息"的句子,再交给 LSTM + Seq2Seq 网络把句子转成结构化属性,模型靠用户对建议的接受/拒绝反馈持续微调;为了让用户无需准备语料就能训出模型,Markup 还内置了一个合成数据生成器。
而今天仓库里的 v2.0.0 已经把这一切换掉了。server/src/complete.ts 里只剩下一句朴素的实现:拼一个 POST <baseUrl>/chat/completions,让大模型返回 JSON。这是一次典型的"端侧模型 → 大模型 API"的迁移,旧的自训练流水线在当前代码树里已经找不到痕迹。
传统标注工具像一张空白表格,工具本身不聪明,只是给你一个更顺手的输入框。Markup 更像坐在旁边的实习助理:你指着一段话问"这是什么",他给出类型和属性建议;你圈错了他会记住,你确认了他下次更准。区别在于这个助理的"知识"全部来自你配置的实体/属性清单(UMLS、SNOMED-CT、ICD-10 这类医学标准术语,或你自己上传的本体文件),所以他不会乱猜,只会"选边"。
三条建议链路(server/src/prompts.ts 里的提示词写得很干净):划选文本 → 判实体;划选文本 + 实体 → 抽属性;整篇文档 → 一次性给出文档级标注建议(含精确的 text_span 文本片段)。第三种最有意思,服务端会把模型返回的片段拿回原文做严格校验:不在工作区配置里的实体、原文里找不到的子串、和已有标注重叠的区间,全部静默丢弃。
语义检索(server/src/search.ts)。三种模式:conceptual 先让模型把自然语言查询扩写成关键词加一条判定标准,再召回候选文档并逐批交给模型做 yes/no 判定;keyword 退化为 Postgres 全文检索;structured 直接查标注表,支持 all/none 组合过滤。概念检索失败时会自动降级回关键词检索,不会把错误甩给用户。
导出与协作。支持 brat standoff、JSON 等标注格式导出,能在多个标注者之间做 diff 对比;工作区有成员/所有者两级权限,基于 Supabase RLS 实现。
密钥安全。工作区的模型 API key 用 AES-256-GCM 加密后落库(server/src/crypto.ts),MODEL_CREDENTIALS_KEY 支持 64 位 hex,也接受任意口令走 SHA-256 派生。界面上只显示末 4 位。

本地跑起来需要:Node.js 22+、pnpm、Supabase CLI,并且要 supabase start 起一个本地 Postgres 实例(Docker 依赖在此),然后 pnpm dev + pnpm dev:api 分别起前端和 API。生产部署官方给了多阶段 Dockerfile(node:22-alpine 构建 + 运行同镜像),一个容器同时提供静态前端和 Hono API,端口 8080,官方托管在 Render。
AI 端点是"自带"的,这点设计得不错:可以是 https://api.openai.com/v1、https://api.anthropic.com/v1,也可以是本地 Ollama(http://127.0.0.1:11434/v1),甚至是任意 OpenAI 兼容的自建网关;模型名留空表示"只挂一个模型的服务"。代码里有不错的容错:先带 response_format: json_object 请求,遇到 400 再降级重试,Claude 系则自动不发 temperature。
需要 GPU 吗? 不需要,Markup 自己不跑模型,只发 HTTP 请求。这让它比大多数 AI 工具好落地——瓶颈在 Supabase 的安装和 Docker 环境,不在算力。
src/pages/dashboard/OntologyTable.tsx 只剩本体表格 UI,映射逻辑已不在。server/src/index.ts 里 origin 写死 http://localhost:3000,要挂到自己的域名下必须改代码重新构建。MAX_DOCUMENT_PROMPT_LENGTH),超长文档会被静默截断,长病历场景下的召回质量会下降。resolveDocumentSuggestions 做二次校验兜底,但不是完备的对抗手段。node:22-alpine 未固定具体版本,GitHub Actions 只用了浮动 tag(actions/checkout@v4 等),供应链层面没有做 SHA 锁定。Markup 恰好站在一条行业分界线上:标注工具的第一代靠"内置小模型 + 主动学习",第二代靠"调用通用大模型"。第二代工具的核心竞争力从算法工程转向了三件事——提示词设计(Markup 的四个 prompt 模板清晰可审计)、结果校验层(模型输出必须过白名单和原文匹配)、端点可换(用户自己决定用哪家模型、要不要本地化)。这三点恰好对应了企业落地 AI 工具时最关心的三个问题:可控、可信、可私有。
论文数据也说明了为什么值得投入:有经验的标注员标注一份含 41 个数据元素的文档需要 15–30 分钟,人工成本极高;而第一代主动学习方案已经能减少约 14.2% 的标注时间并小幅提升标注者间一致性。LLM 建议大概率能把这一数字再往上推——只要你能忍受上面说的那些工程成本。
对想把行业语料沉淀成数据集的团队来说,Markup 值得放进候选清单:它 MIT 协议、可以完全自托管、数据不出你的机房,代价是你得自己维护一个 Supabase 实例,并接受文档与代码之间的历史包袱。
