
risingwave
risingwavelabs/risingwave加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一个电商客服 Agent,它要在客户发来消息的瞬间判断"这个订单是不是VIP""库存还够不够""最近有没有退款异常"。传统做法是:Debezium 监听 MySQL 写入 Kafka,Flink 消费聚合,结果落到 Redis 或一个 serving 数据库。每次 Agent 要读数据,都得面对一个尴尬的窗口——数据是"最近几分钟前"的。
RisingWave 的做法是把这四层压成一层,并且让查询直接命中"始终新鲜"的结果。这不是又一个 Flink 竞品,而是把流引擎的增量计算能力直接暴露给 Agent 用 SQL 查询。
RisingWave 由risingwavelabs(蚂蚁集团孵化)于 2022 年初开源,Rust 编写,Apache-2.0 协议。它长期的核心卖点是"流批一体 + Postgres 协议兼容 + 高性能",但在 3.0(2026 年 7 月)版本明确换了叙事主线:Event Streaming for Agentic AI。
这个转向并非营销跟风,而是有真实的技术抓手:
.agents/skills/ 目录直接放了 Agent 技能包,Agent 可以不写任何自定义集成就查询和运维集群。3.1(2026 年 9 月)进一步加入 VARIANT 半结构化类型、周期性刷新的物化视图、更灵活的 sink 替换与回放。当前 main 分支版本号为 3.2.0-alpha,最新正式 tag 是 v3.1.1。
如果 Flink 是"工厂流水线",只负责把原料加工成成品;Kafka 是"传送带",只负责搬运;Postgres 是"仓库",只负责静态存放。RisingWave 更像是自动更新的活账本——账本上每一页在数据变化的一瞬间就自己改好了,你随时翻到的那一页都是当下最新的,不需要先冻结、汇总、再解冻。
它内部最核心的机制是增量物化视图:上游数据变了,只重算受影响的那部分结果,而不是每次查询都从头跑一遍全量计算。这是"端到端新鲜度 < 100ms、p99 查询 10-20ms"的来源。
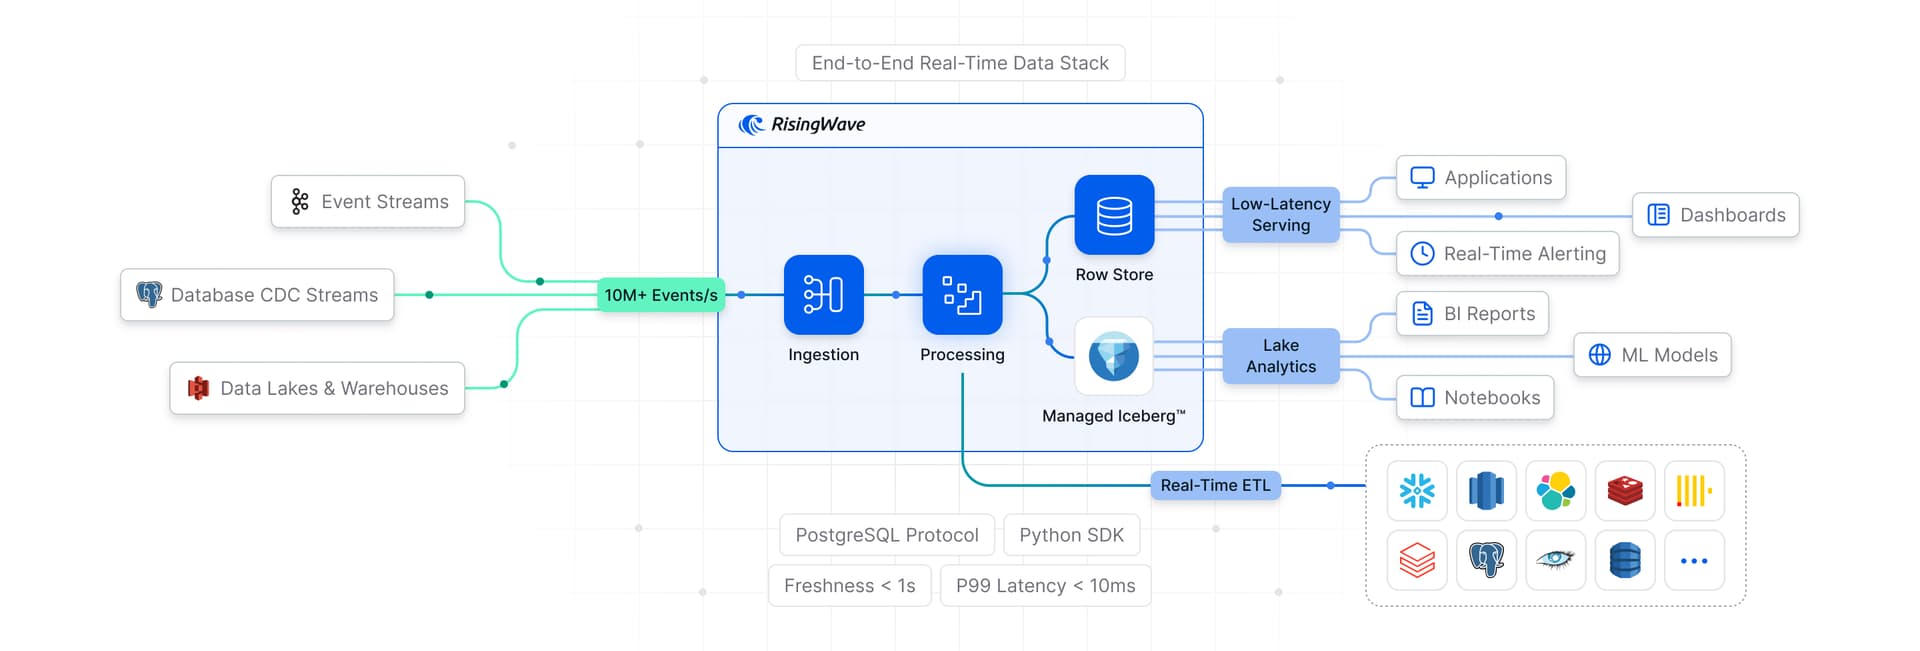
图:RisingWave 统一架构——摄取、增量计算、低延迟服务与 Iceberg 存储在同一系统内完成
在实现层面,它是典型的存算分离设计:内部状态、表和物化视图都放在对象存储(S3 等)上,成本大约是内存的 1/100,因此可以弹性扩容而无需数据重平衡,故障恢复以秒计。对延迟敏感的场景,提供弹性磁盘缓存把热点数据钉在本地 SSD/EBS 上,保证 p99 仍在 10-20ms。
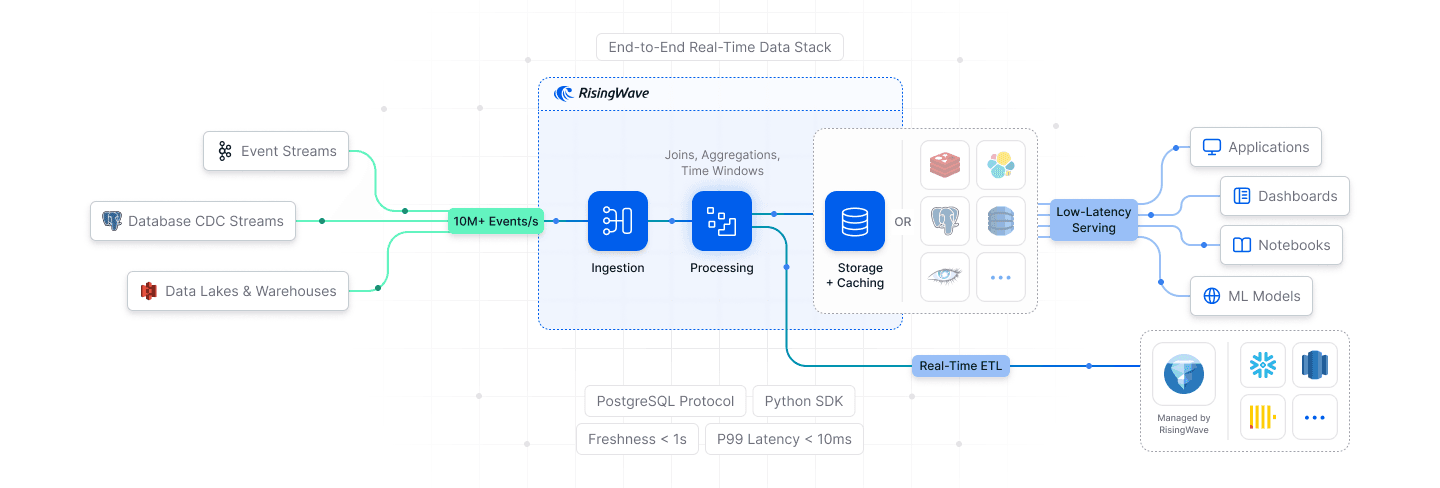
图:架构版本演进,存储与计算职责持续分离
摄取面(Ingest):覆盖 Webhook、Postgres/MySQL/SQL Server 原生 CDC(读事务日志)、Kafka/Pulsar/Kinesis、批量对象存储导入。所有源统一到同一套 SQL 接口,流和表可以自由 JOIN。
计算面(Process):持续增量计算,barrier 驱动的 checkpoint 机制保证 exactly-once。物化视图可以建在物化视图之上(MV on MV),支持时间维度的 temporal join。
服务面(Serve):结果维护在内部 row store,标准 SQL 协议暴露。因为兼容 PostgreSQL wire protocol,psql、JDBC、任何 Postgres 生态工具都能直接连。
存储面(Store):写 Apache Iceberg 表,自带 REST Catalog 与表维护(compaction、小文件优化、快照清理),Iceberg 查询用 Apache DataFusion 引擎执行。
聚合优化是它的看家本领之一:
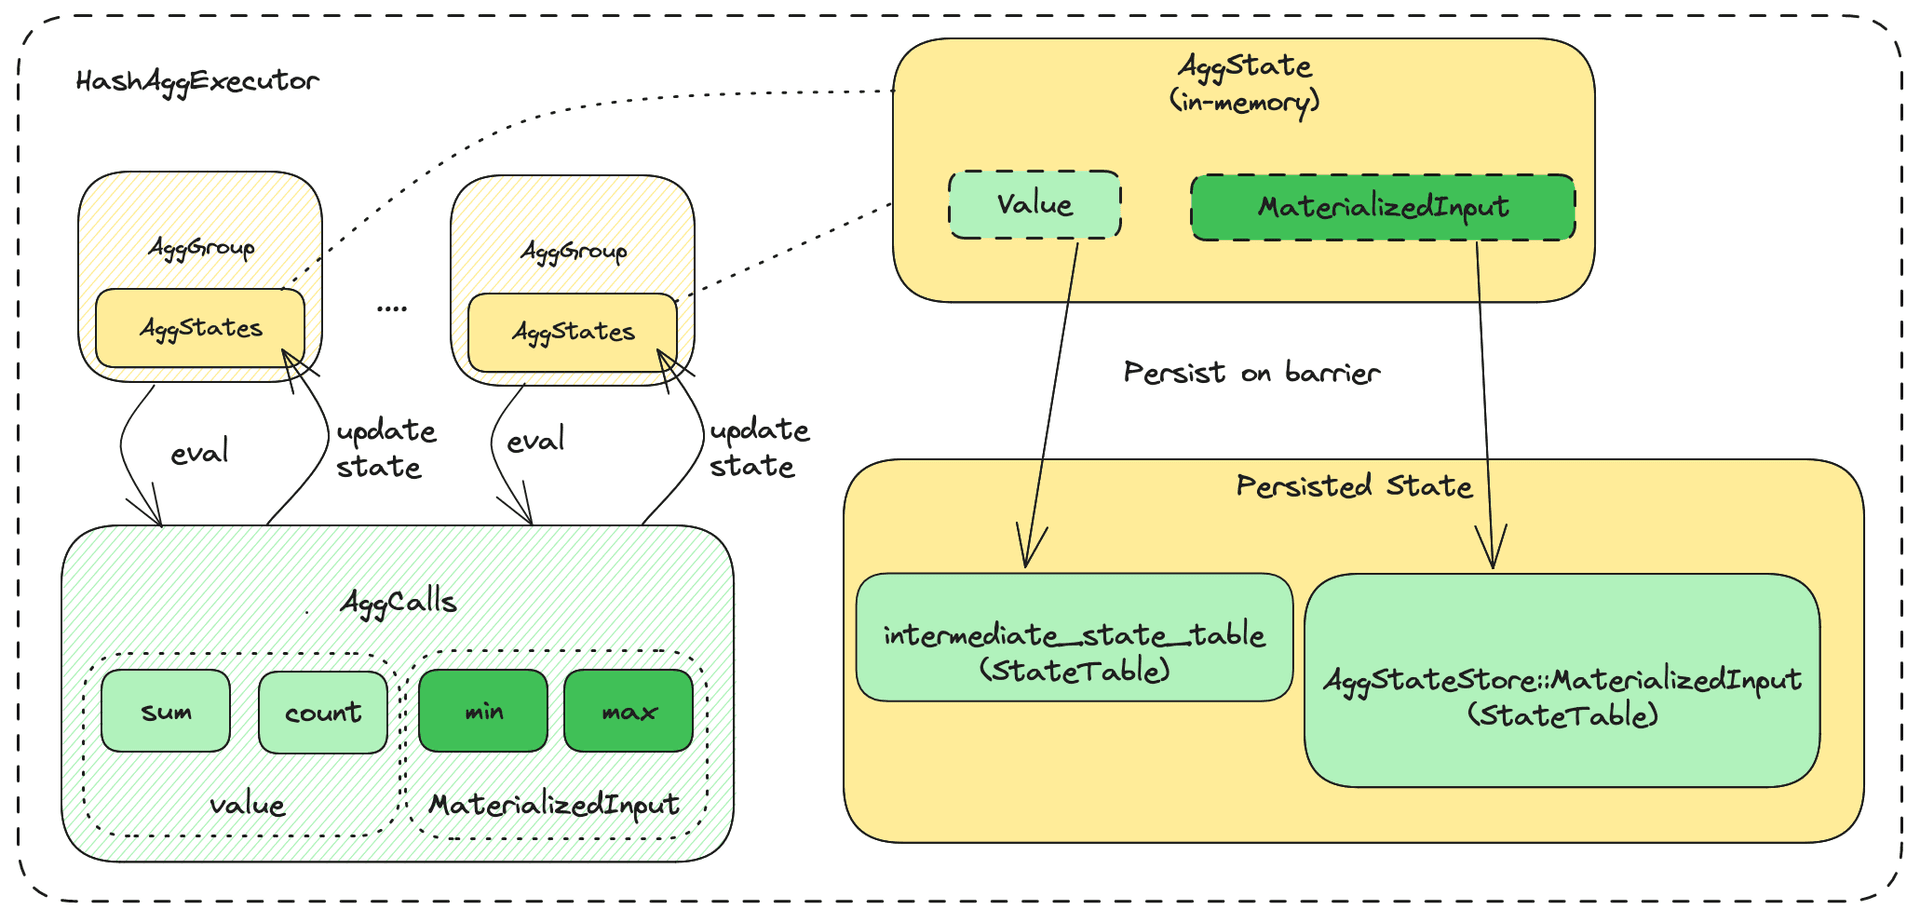
图:聚合计算组件与增量更新路径
最快路径:curl -L https://risingwave.com/sh | sh 一键脚本,60 秒内跑起 standalone 模式,Prometheus 指标端口 1250、Dashboard 5691、SQL 端口 4566。
Docker Compose:docker/docker-compose.yml 是 standalone 单节点配置,依赖 MinIO(存对象存储)+ Postgres(存元数据),同时提供 10 余个变体(with-s3 / with-gcs / with-hdfs / with-azblob / with-obs / with-oss / with-lakekeeper / with-sqlite 等)以适配不同云厂商。
Kubernetes:官方提供 Helm Chart 与 Operator 两条路线,仓库内 CI 有 auto-update-helm-and-operator-version-by-release.yml 做版本同步。
Web UI:dashboard/ 目录是一个 Next.js 前端(pnpm 管理),提供集群状态、SQL 编辑器、可视化监控,配合 src/meta/dashboard 的 Rust 后端。这是给人看的操作面板,不是面向 Agent 的接口——Agent 走 MCP/CLI/Postgres 协议。
门槛判断:本地跑通几乎无门槛(一条命令 + Docker),但源码编译是硬骨头——Cargo workspace 覆盖 70+ crate,Dockerfile 需装 Rust toolchain、Protobuf、Node 20、JDK 21、OpenBLAS/LAPACK,编译耗时长。生产部署则需要理解 meta/compute/frontend/compactor 四类节点的职责划分与状态存储选型。
必须指出几个真实问题:
--total-memory-bytes 21474836480(20GB)与 4GB frontend/compactor 配额,Meta + Compute + MinIO + Postgres 一起起,对低配开发机并不友好,需要自己调小。RisingWave 代表的是一个清晰趋势:流处理引擎正在向"AI 的实时上下文层"迁移。同一时期,Kafka 基金会推出基于 Flink 的推理引擎,Snowflake、Databricks 各自把实时化与 AI 结合,传统 MPP 数据库则普遍把"向量 + 流"作为下一代卖点。
RisingWave 的差异化落点很明确:不做模型,不做编排,只做**"始终新鲜的数据供给"**这一层,并把 PostgreSQL 兼容性作为降低迁移成本的杀手锏——这让大量已经熟悉 Postgres 的团队几乎零学习成本地拿到流式能力。
社区活跃度上,仓库保持了高频的每日提交节奏,2026 年内从 3.0 一路推进到 3.2.0-alpha,PR 模板、CI 检查(license/typo/slt-coverage/protobuf-breaking)、e2e_test 目录覆盖 backfill/iceberg/sink/vector_search/webhook 等近 50 个场景,工程规范度在开源流处理项目里属于第一梯队。
适合:需要秒级新鲜数据喂给 Agent/实时应用的团队;已经使用 Postgres 协议栈不想再引入 Flink+Kafka+Sink 的团队;需要流式数据长期沉淀到 Iceberg 做湖仓一体与训练数据准备的团队。
不适合:只想快速搭一个 RAG 检索(专用向量库更轻);资源受限的小规模单机应用(运维成本偏高);已经深度绑定 Flink SQL 生态的团队(迁移成本高)。
RisingWave 3.x 是目前开源界"流式 + AI 上下文"这条路线上完成度最高的工程实践之一。它没有试图把所有事情都做好,而是把"数据持续新鲜"这一件事做到了极致,并用 Postgres 协议和 Iceberg 格式把迁移与生态成本压到最低。
代价是明确的:资源门槛高、社区相对小众、AI 能力尚属"顺带提供"而非核心专长。如果你的场景确实卡在"Agent 读到的数据总是慢半拍"这个具体问题上,RisingWave 值得认真做一次 POC;如果不是,它的复杂度大概率不值得。
