
projectmem
riponcm/projectmem加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景: 凌晨两点,你给 AI 发了一条消息,让它修一个 BUG。AI 花了 30 分钟分析代码,然后告诉你"这个问题的解决方案是 XXX"。你照做了,结果问题更严重了——因为这个"方案"在三个月前就试过,失败了,还在项目里留了记录,但 AI 完全不记得。
这种情况,对任何一个频繁使用 AI 编程助手的开发者来说,都不陌生。每一次新对话,AI 都是一张白纸。它不记得你项目里有哪些坑,不记得上次哪种解法碰了壁,更不知道你为什么会推翻自己的方案重写。
projectmem 做的事情,就是给 AI 编程助手装上记忆。
当前主流的 AI 编程助手——Claude Code、Cursor、Windsurf、Codex——有一个共同的结构性缺陷:它们没有项目级的长期记忆。每次对话,AI 接收的上下文来自你粘贴的代码、你描述的问题,以及项目里能被 RAG 检索到的文档。但这些信息是不完整的:代码评审的结论没有记、BUG 的根因分析没有记、废弃方案的原因没有记。
GitHub 上有一个专门描述这个问题的 arXiv 论文(arXiv:2606.12329),作者 Ripon Chandra Malo 就是 projectmem 的开发者。他指出了核心问题:AI 编码助手在长周期项目中的表现,会随着对话次数增加而退化——不是因为模型变笨了,而是因为历史上下文无法被高效利用。
Mem0(一个通用记忆框架)试图解决这个问题,但它面向的是通用 AI 场景,对编程项目的具体需求(代码变更、提交历史、失败尝试)没有针对性优化。projectmem 则直接从编程工作流出发,设计了一套专为 AI 编码助手服务的本地记忆系统。
projectmem 的工作方式可以用三个词概括:记录、关联、预警。
记录是指 projectmem 自动捕获项目中的关键事件。它通过 Git Hook(pre-commit、post-commit、post-merge)以及 MCP 工具接口,在三个层面积累信息:
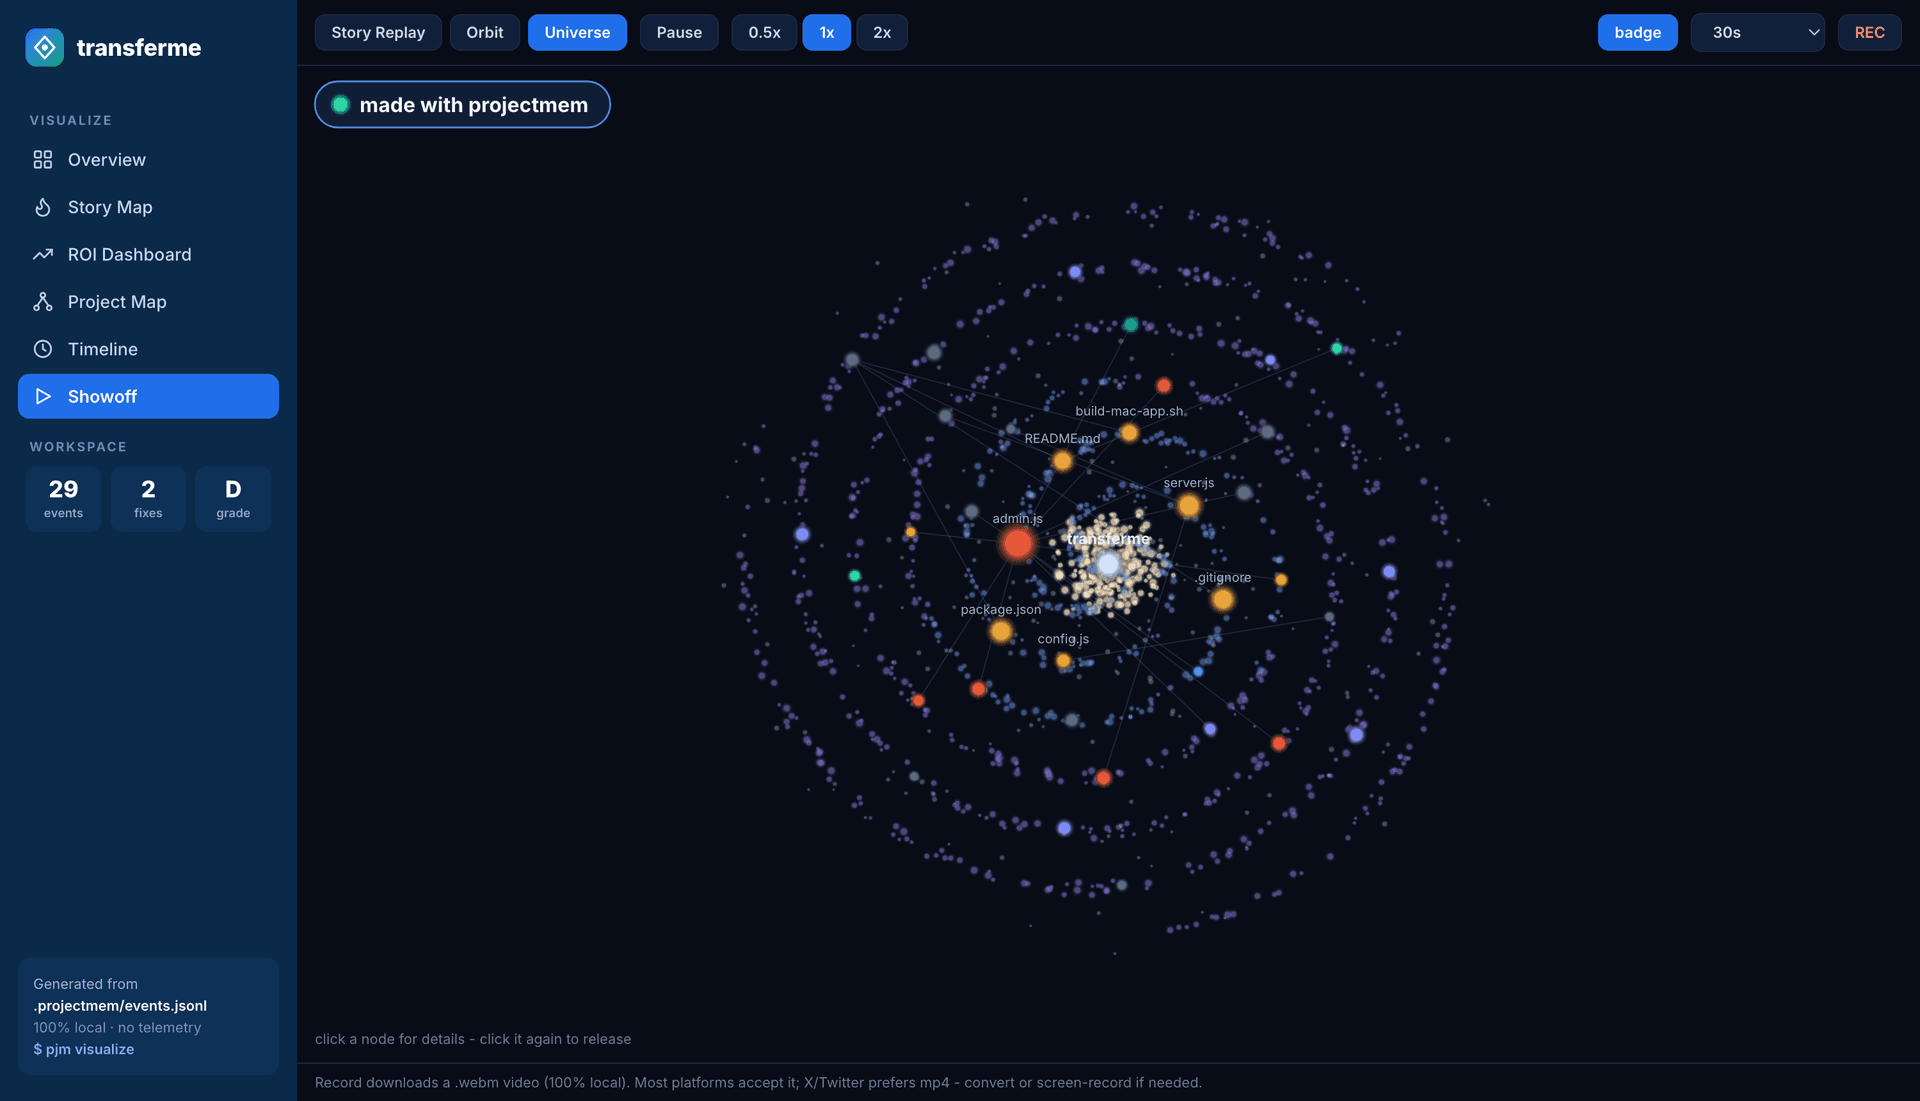
pyproject.toml/package.json/Cargo.toml/go.mod 自动解析项目结构,让 AI 在进入一个新项目时就能快速了解技术栈。关联是指 projectmem 构建了一个项目知识图谱。它不只记录"发生了什么",还记录"谁做的决定、基于什么上下文、后来被谁覆盖"。通过 pjm visualize 命令,可以生成一个可视化的时间线视图,展示每个 case 的解决路径和失败路径。这对于大型项目或多成员团队来说,是非常宝贵的知识沉淀。
预警是 projectmem 最有价值的功能。当你让 AI 去解决一个问题时,projectmem 会在 AI 行动之前,检查历史事件库中是否已有类似尝试——如果同样的方法已经失败过,它会在 pre-commit 阶段就警告你:"这个方案在 XX 年 XX 月 XX 日已经试过,结果是 XXX,建议尝试其他方向。"
从技术角度看,projectmem 是一个标准的 MCP(Model Context Protocol)服务器,通过 MCP 协议与 AI 客户端通信。这意味着它与 Claude Code、Cursor、Codex、Antigravity(Windsurf 的前身)等主流 AI 编码工具天然兼容,无需额外的插件或补丁。
项目的整体结构非常精简,核心模块只有 7 个 Python 文件:
| 模块 | 职责 |
|---|---|
cli.py | 命令行入口,提供 pjm 子命令 |
mcp_server.py | MCP 协议服务端,处理来自 AI 客户端的请求 |
models.py | 数据模型定义 |
project_registry.py | 项目注册表,管理本地已注册项目 |
global_memory.py | 全局记忆管理 |
resolver.py | 事件解析与关联 |
redaction.py | 安全过滤(防止敏感信息被记录) |
依赖也极为克制:只有 typer(CLI 框架)、mcp(MCP 协议库)和 watchdog(文件系统监控)三个,没有引入任何重型 ML 框架或数据库——所有数据都以 JSONL 文件形式存储在 .projectmem/ 目录下,100% 本地化。
projectmem 的安装和配置非常轻量。对于一个已有项目:
# 1. 安装
pip install projectmem

# 2. 在项目中初始化
cd /path/to/your/project
pjm init

# 3. 将输出的 MCP 配置添加到 Claude Code / Cursor 等客户端
# (pjm init 会打印配置块,照着复制即可)

# 4. 重启 AI 客户端,让 MCP 服务器加载
pjm doctor  # 验证配置是否正确
pjm init 会自动创建 .projectmem/ 目录(存放 events.jsonl、summary.md 等),生成 CLAUDE.md 文件(告诉 AI 客户端需要调用 projectmem 的 MCP 工具),并自动从项目依赖文件解析技术栈填入 PROJECT_MAP.md。
一个值得注意的细节是:从 0.3.0 版本开始,一个 MCP 服务器可以服务所有已注册的项目。之前每个项目需要单独配置 MCP,现在只需要在 AI 客户端中配置一次即可。这大大降低了多项目管理的心智负担。
没有任何工具是银弹,projectmem 也不例外。
存储容量依赖本地磁盘:所有记忆都存储在 .projectmem/ 目录下,如果项目规模非常大(比如有数万行代码、几千次 commit),事件文件会逐渐膨胀。summary.md 有自动精简机制,但 events.jsonl 本身没有内置的压缩或归档策略。
跨设备同步需要手动处理:因为数据完全本地化,换一台机器或换一个工作环境,记忆不会自动同步。虽然可以用 Git 本身来管理 .projectmem/ 目录,但需要手动维护。
仅支持 MCP 客户端:不支持没有 MCP 接口的 AI 工具(如普通的 ChatGPT 对话界面),也不支持非编码类任务。它的设计边界非常清晰:就是一个专为 AI 编程助手服务的记忆层。
"记忆"的准确性依赖 AI 自我报告:projectmem 记录的是 AI 自己对尝试过程的描述。如果 AI 的自我描述不准确或遗漏了关键信息,记录的价值会大打折扣。
projectmem 的出现,折射出一个更大的趋势:上下文工程(Context Engineering)正在成为 LLM 应用的核心战场。
在过去一年里,我们看到了从 RAG(检索增强生成)到 Long Context(长上下文窗口)到 MCP(模型上下文协议)的一系列技术演进。projectmem 走的是另一条路——不是给 AI 更多上下文,而是给 AI 一个结构化的、可查询的、主动预警的历史经验库。
这是一个认识论层面的转变:从"让 AI 自己从海量上下文里找答案",到"主动给 AI 提供它应该知道的事实,并告诉它哪些路已经走不通"。
从社区数据看,projectmem 在 GitHub 上已有 850+ stars,PyPI 月下载量持续增长,arxiv 论文被引用次数也在上升。它代表的是一类新兴工具的开始:不是让模型更强,而是让模型更好地利用已有的工作成果。
适合人群: 长时间维护复杂项目的开发者、使用 AI 编码助手频率高的团队、需要跨 session 保持项目上下文的个人开发者。
不适合场景: 纯探索性的一次性项目、对数据安全有云端同步要求的环境、不使用 MCP 客户端的用户。
