
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
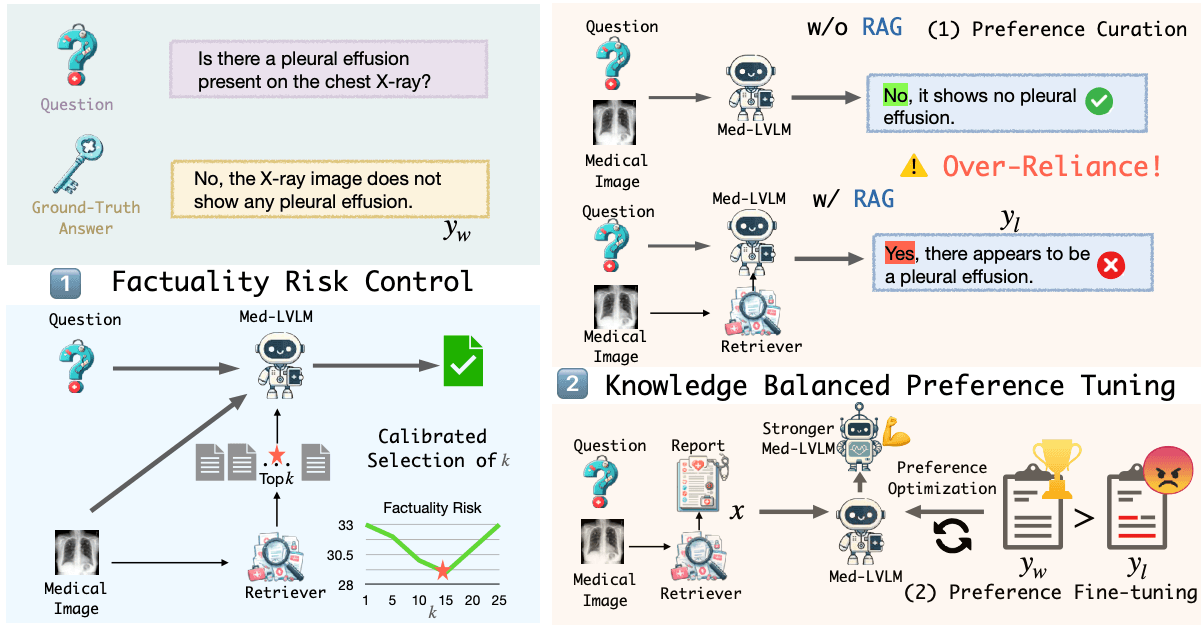 图1:RULE项目Logo — 聚焦医疗视觉语言模型的事实性校准
想象这样一个场景:你因为持续咳嗽去了医院,医生让你拍了胸部X光片,然后把影像上传到一个AI辅助诊断系统。系统给出了报告:"左肺下叶有3cm×2cm的占位性病变,建议进一步检查。"——听起来专业而严谨。
但如果这个AI系统产生「幻觉」(hallucination),把影像中并不存在的结节描述得言之凿凿,甚至引用了根本不存在的参考文献,后果会是什么?
这并非危言耸听。**医疗大型视觉语言模型(Med-LVLMs)**在医学影像理解上展现出惊人潜力,但它们有一个致命缺陷:容易产生事实性错误——生成看似专业但与医学事实不符的描述。这种「一本正经地胡说八道」,在医疗场景下轻则耽误治疗,重则危及生命。
EMNLP 2024收录的 RULE(Reliable Multimodal RAG for Factuality in Medical Vision Language Models) 正是为了解决这个问题。
RULE 由 Peng Xia、Kangyu Zhu、Haoran Li 等研究者开发,在 EMNLP 2024 发表。项目核心目标是通过**可靠的多模态检索增强生成(RAG)**技术,提升医疗视觉语言模型的事实准确性。
项目的独特价值在于它不追求"更大更强"的模型本身,而是关注如何让现有模型在医疗场景下更可信——这是一个更务实也更重要的方向。
技术层面,RULE 提出了两大核心策略:
校准的上下文选择(Calibrated Selection of Retrieved Contexts):通过风险控制机制,选择高质量的医学检索上下文,从源头降低幻觉风险。
偏好数据集微调(Fine-tuning with Preference Dataset):利用 DPO(Direct Preference Optimization)直接偏好优化方法,让模型学会在自身知识与检索上下文之间找到平衡点,既不过度依赖检索,也不盲目相信内部知识。
论文在三个医疗 VQA 数据集上的实验显示,RULE 将事实准确率提升了 20.8%,效果显著。
RULE 构建在微软的 LLaVA-Med 基础上,后者是专为医学领域微调的 LLaVA 变体。项目采用了典型的多模态架构:
医学影像 → CLIP视觉编码器 → 投影层 → LLaVA-Med语言模型
                ↑
         检索到的医学上下文(RAG)
核心技术栈:
llava/train/train_dpo.py检索流程: 用户查询 → CLIP_RET 检索相关医学影像/报告 → 上下文注入 → LLaVA-Med 生成答案 → DPO 校准输出
RULE/
├── llava/                   # 核心模型代码(LLaVA框架扩展)
│   ├── model/
│   │   ├── llava_arch.py    # 多模态架构核心
│   │   ├── multimodal_encoder/  # CLIP视觉编码器集成
│   │   └── multimodal_projector/ # 跨模态投影层
│   ├── train/
│   │   └── train_dpo.py     # DPO训练核心
│   ├── eval/                # 评估脚本(按数据集命名)
│   └── serve/               # 模型服务
├── tool/
│   ├── dpo_trainer.py       # DPO训练器(偏好优化)
│   └── dpo_trainer_inherent.py  # 内在知识偏好训练
├── retrieve/                # 检索模块(独立子项目)
│   └── src/                 # CLIP_RET 实现
├── data/                    # 训练/测试数据
│   ├── training/
│   │   ├── retriever/       # 检索器训练数据
│   │   └── alignment/       # 对齐微调数据
│   └── test/                # 测试集(MIMIC-CXR、IU-Xray等)
├── scripts/
│   ├── run_dpo.sh           # DPO训练脚本
│   └── inference.sh         # 推理脚本
├── povid_infer.py           # POVID推理入口
├── cog.yaml                 # Cog容器化配置(GPU镜像)
└── pyproject.toml           # Python包配置
代码整体质量较高,结构清晰,遵循 LLaVA 官方代码规范。训练脚本完整,支持 DeepSpeed 分布式训练和 WandB 实验追踪。
conda create -n RULE python=3.10 -y
conda activate RULE
pip install --upgrade pip
pip install -e .
pip install trl
坑点提醒:
pip install -e . 会安装整个 llava 包(LLaVA框架),依赖较重,首次安装需要耐心等待trl 包是 DPO 训练的必需依赖,需单独安装RULE 需要两类关键资源,均需手动获取:
数据集权限申请是整个流程中最耗时的环节,平均需要数周审批时间。
python llava/eval/model_vqa_{dataset}.py \
    --model-base 'path/to/llava-med-1.5' \
    --model-path 'path/to/lora_weights' \
    --question-file 'path/to/question_file.json' \
    --image-folder 'path/to/test_images' \
    --answers-file 'path/to/output_file.json'
项目提供了 cog.yaml,支持通过 Replicate 的 Cog 工具进行容器化部署,这是本项目最友好的部署方式:
pip install cog
cog predict -i image=@test_image.jpg
cog.yaml 已定义完整的 GPU Python 3.11 镜像,含 PyTorch 2.0.1、Transformers 4.31 等所有依赖。
数据壁垒高:三个核心医疗数据集均需申请,数据不可直接获取限制了研究的可复现性。
硬件要求极高:7B 参数的 Mistral 模型 + CLIP + 图像处理,推荐配置为 16GB+ 显存 GPU,大多数研究者难以本地运行。
评估数据集有限:仅在三个医疗数据集上验证,泛化到其他医疗影像类型(如超声、CT、MRI)效果未知。
缺乏交互式 Demo:README 未提供 Gradio/Web 演示页面,用户无法快速体验模型效果(cog.yaml 虽定义了 Gradio,但需额外配置)。
LLaVA-Med 基座局限性:LLaVA-Med 本身基于 GPT-4 辅助生成的数据微调,可能继承了 GPT-4 的潜在偏差。
RULE 的核心贡献不在于提出了多么新颖的模型架构,而在于它指明了一条让医疗AI真正可信的技术路径:通过 RAG 引入外部医学知识,通过对齐学习(DPO)平衡内部知识与外部检索。
在医疗AI领域,「准确」比「强大」更重要。RULE 20.8% 的事实准确率提升,意味着在100次诊断中,原本可能有数十次出现幻觉错误的系统,现在可以正确回应80次以上——这个进步在临床场景下意义重大。
从开源生态角度看,RULE 提供了完整的训练代码、检索模块和 Cog 部署方案,是医疗多模态AI领域的重要参考实现。尽管部署门槛高,但其技术思路对任何希望在医疗场景下构建可信AI系统的团队都有借鉴价值。
分析基于 GitHub 源码(v1.0)及 EMNLP 2024 论文 arXiv:2407.05131,数据采集于 2026-08-07。
