
Kokoro-FastAPI
remsky/Kokoro-FastAPI加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
如果你想让自己的 Agent、聊天前端或阅读应用"开口说话",最省事的路径不是去申请商业 TTS API,而是自建一个本地语音服务。Kokoro-FastAPI 就是这条路径上目前最成熟的一个答案:一条 docker run 命令,一个 OpenAI 兼容的 /v1/audio/speech 端点,模型体积只有 82M 参数,CPU 上就能跑出可用速度。
截至 2026 年 10 月,该项目在 GitHub 上已积累 5604 stars / 935 forks / 49 位贡献者,Apache-2.0 许可证,最新发布版本 v0.9.0(2026-09-10),仓库在 2026-10-28 仍有提交,活跃度很高。
生态里几乎所有 AI 应用框架都会说同一种"方言"——OpenAI 的 Speech API。于是你想给 SillyTavern、OpenWebUI、Home Assistant、朗读类 Agent 接语音时,标准做法是去 OpenAI 官网充值买 API。
Kokoro-FastAPI 的做法是把 Kokoro-82M 这个 Apache-2.0 许可的小模型包成 FastAPI 服务,对外严格复刻 OpenAI 的接口签名。客户端代码几乎一行不用改,只把 base_url 从 api.openai.com 换成本机地址:
from openai import OpenAI
client = OpenAI(base_url="http://localhost:8880/v1", api_key="not-needed")
client.audio.speech.create(model="kokoro", voice="af_bella", input="Hello world!")
类比来说:商业 TTS API 像是"每次开口都要打车去医院",这个服务是"在自己院子里装了一台复印机"——按下按钮就有声音,且不按次计费、不上传文本。
单看 README 列表容易低估这个项目的工程密度,它实际覆盖了六层能力:
1. 多语言与多音色。 支持英(US/GB)、西、法、意、葡(巴西)、日、中、印地语,内置 80+ 音色包(api/src/voices/v1_0/ 下 80 个 .pt 文件),覆盖美/英/西/法/德/意/日/中/韩/印等语言前缀体系。
2. 音色混合与别名。 支持 af_bella(2)+af_sky(1) 这种带权重的音色混合,比例自动归一化;还能用 voice_aliases 把长串混合表达式映射成 {"narrator": "af_bella(2)+af_sky"} 这样的短别名,角色剧场景可直接复用。
3. 多说话人对话。 正文内嵌 [voice:am_michael] 标签即可中途换人,配合 [pause:1.5s] 停顿、[rate:1.2] 语速调整、[Worcester](/wˈʊstər/) 强制 IPA 发音四种内联控制令牌。
4. SSML 翻译层。 把 <break time="750ms"/>、<prosody rate="slow">、<phoneme>、<voice> 等标准 SSML 语义翻译成上述内联令牌再合成;非法 SSML 返回 400,DTD 直接拒绝,嵌套深度上限 10。
5. 字幕时间戳。 /dev/captioned_speech 返回逐词时间戳,且开启 voice tags 后每个时间戳还带 voice 字段,可直接驱动卡拉 OK 式"跟读高亮"。
6. 音色调优(Inno Clone-Tuner)。 上传 3–30 秒参考音频即可把音色"调"向参考音轨,官方明确说明这是 tuner 不是 cloner——"期待同一个邻域,而非完全复刻",并默认关闭、需显式开启。
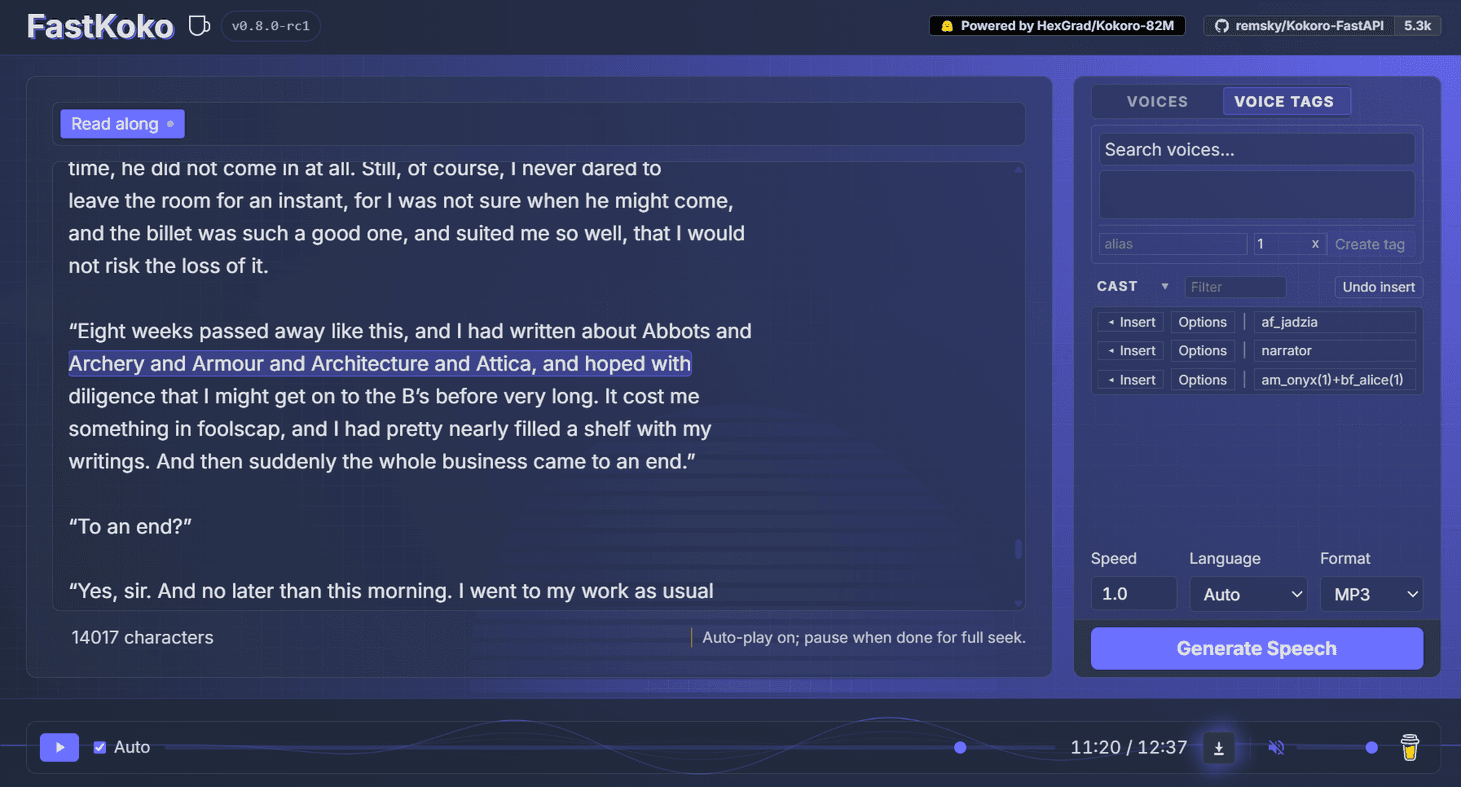
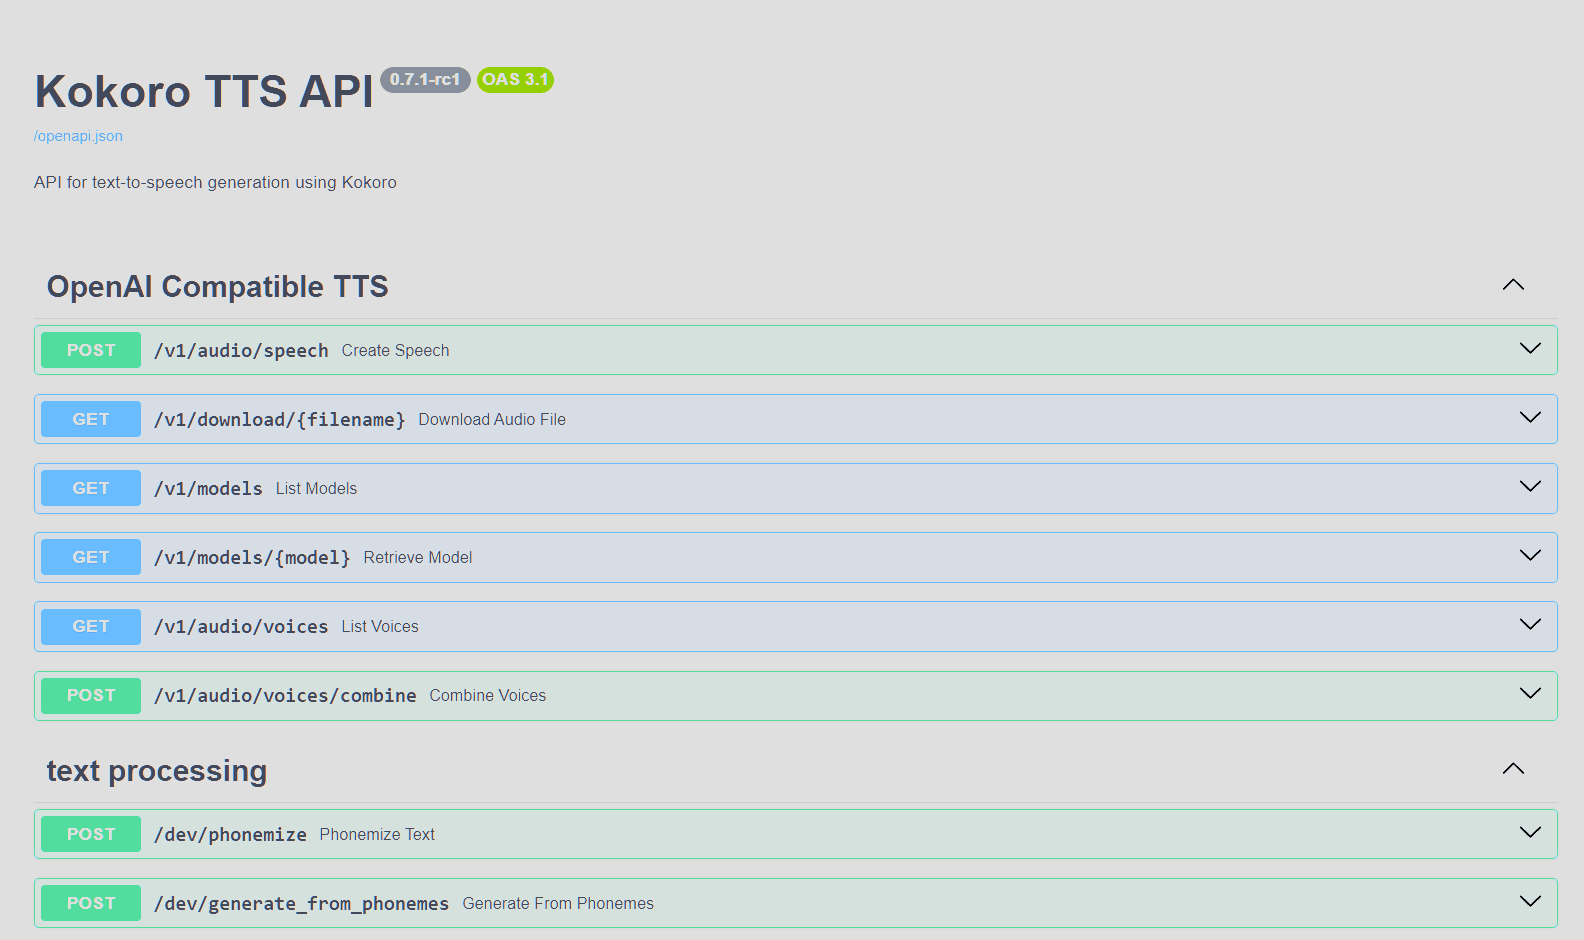
服务自带 read-along Web 播放器(web/ 目录,纯原生 JS + 音频波形绘制),另有 FastAPI 自动生成的 OpenAPI 文档页:
README 给出的基准环境是 4060Ti 16GB + i7-11700 + 64GB 内存,实测:
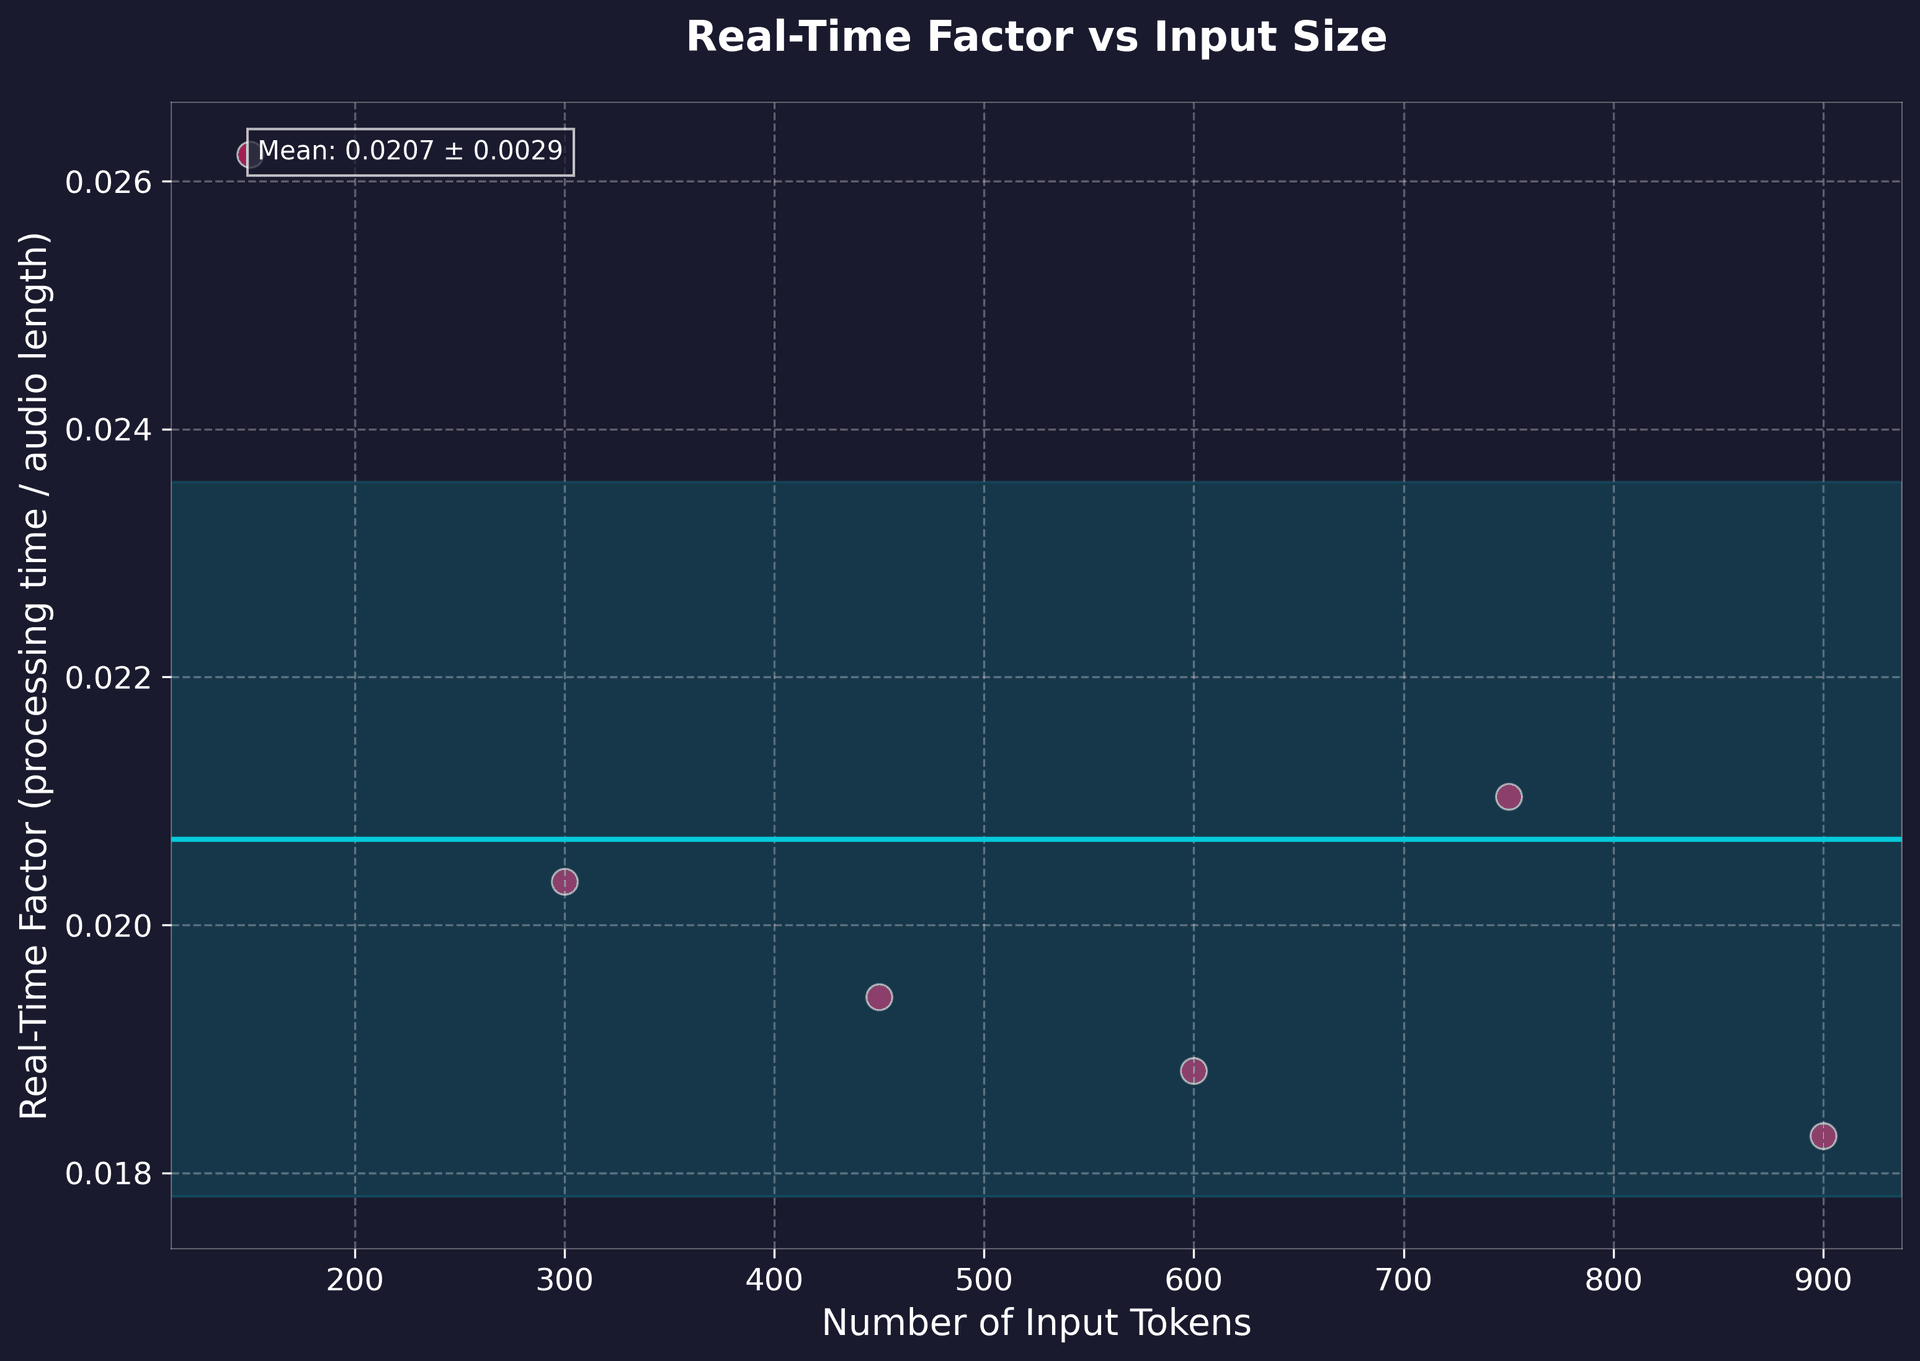
在 4060Ti 上生成整本《The Time Machine》(50 万字符 → 8.5 小时音频)后用 faster-whisper 反向转写校验,WER 仅 0.033。逐语言抽检中英文、西、法、意、葡语 WER 为 0.000,日语 CER 为 0.000,中文 CER 0.143、印地语 0.059——中文与印地语是当前明显的短板。
镜像直接跑(最简)
docker run -p 8880:8880 ghcr.io/remsky/kokoro-fastapi-cpu:latest
Compose 构建(带热重载)
cd docker/cpu   # 或 docker/gpu、docker/rocm
docker compose up --build
K8s Helm 部署:charts/kokoro-fastapi/ 提供完整 Helm Chart(values.yaml 已预设 nvidia.com/gpu: 1 资源预留、Ingress、CAS、autoscaling),可对接 GPUStack、Unraid、Umbrel 等应用商店。
镜像矩阵覆盖 linux/amd64 + linux/arm64,提供 CPU / NVIDIA CUDA(cu126 默认,另有 cu128 供 RTX 50 系 Blackwell)/ AMD ROCm(实验性,仅 x86_64)/ Apple Silicon MPS 原生(需用 uv 直接运行)。CPU 镜像默认内置模型权重,无需下载,拉取即用。
Dockerfile 为标准多阶段构建:builder 阶段用 uv 同步依赖(含 pyopenjtalk 的 sdist 编译),runtime 阶段用 python:3.12-slim + 非 root 用户(uid 1000)运行,模型烘焙进镜像,日语所需的 UniDic 字典约 526MB 也已预置(可用 build-arg 关闭但会静默破坏日语生成)。
api/src/ 下分为 routers(7 个路由模块)/ services(TTS 服务、音频、文本归一化、SSML、phonemizer)/ inference(模型管理、音色管理、Kokoro v1 推理、Inno 调优器)/ core(配置、模型配置、路径)/ structures(Pydantic 模型)api/tests/ 下 30+ 测试文件,覆盖单元测试、集成测试(对活体 HTTP API 打流)、属性测试(hypothesis)、ReDoS 回归测试、SSML 多方言语料(Google/Azure/Amazon/Polly/W3C).github/workflows/ci.yml + CodeQL + ruff + pytest + codecov + playwright(前端 E2E)+ docker-bake 多架构构建docs/ 按主题拆分(配置、部署、集成、internals、故障排查),另提供 AGENTS.md 供 AI 编码代理理解仓库约定zf_xiaobei/xiaoni/xiaoxiao/xiaoyi)。/dev/*、/debug/* 端点默认关闭(需 ENABLE_DEBUG_ENDPOINTS / ALLOW_DEV_UNLOAD 显式开启),但一旦开启即暴露主机信息与进程栈;服务本身无内置鉴权,直接暴露公网需自行加反向代理。master 是开发分支(不发布镜像),生产应使用 release 分支或带版本号的镜像 tag,别直接用 :latest。normalization_options.normalize=false 关闭。该项目已成为自托管 TTS 的事实基座之一:官方 README 列出的社区集成已覆盖 Home Assistant、Umbrel、Unraid、GPUStack、Jetson 容器、电子书朗读工具(openreader、epub_to_audiobook)、ESP32 语音助手(xiaozhi-esp32-server)、浏览器扩展等数十个项目,月均镜像拉取量标注为 250K+。
它代表的趋势很清楚:开源小模型 + 标准化 API 封装 + 一键容器化,正在把"语音能力"从按量计费的云服务变成可以塞进 NAS、树莓派和家庭服务器的本地基础设施。Kokoro-FastAPI 没有在模型层面创新,但它把一个学术玩具级的 TTS 模型打磨成了工程可用、可观测、可水平扩展的生产服务——这类"包装层"项目的价值,往往恰在于此。
