
panoptikon
reasv/panoptikon加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你有没有遇到过这种情况——硬盘里堆了几万张照片,想找"去年夏天去海边的那张",却怎么也想不起文件名,只能一张张翻?这就是 Panoptikon 要解决的问题。它不是简单的文件搜索工具,而是一个本地部署的 AI 多模态语义搜索引擎,能让你像跟 ChatGPT 对话一样,用自然语言描述来找本地文件——无论是图片、视频、音频还是 PDF 文档。
Panoptikon 的名字来源于希腊语"panoptes"(全视者),正如其名,这个工具的目标是"无所不见"——把你的本地文件变成一个可以被语义搜索的数据库。
它诞生于对现有本地搜索工具的失望。Windows 搜索、macOS Spotlight 这些系统级搜索都只能按文件名或 metadata 查找,无法理解图片的内容、视频里的音频对话或 PDF 中的文字语义。而云端的 Google Photos 虽然功能强大,但将个人文件上传到第三方服务器存在隐私风险。
作者 reasv 在开发过程中逐渐意识到,大多数同类工具(如 Hydrus)会复制或移动用户文件,而 Panoptikon 的核心理念是绝不触碰你的数据——它只读取文件路径和哈希值,在自己的 SQLite 数据库中建立索引,原始文件保持原样不动。这种设计哲学让它成为注重隐私的用户和需要处理大量媒体文件的专业人士的理想选择。
可以把 Panoptikon 想象成一个给多媒体文件用的反向 CLIP。CLIP(Contrastive Language-Image Pre-training)是 OpenAI 开源的多模态模型,能将图片和文本映射到同一个向量空间。Panoptikon 则利用这一点:当你添加一个图片目录时,它会调用 CLIP 模型提取图片的视觉特征向量;当你搜索"一只在雪地里奔跑的狗"时,同样用 CLIP 将文字转为向量,然后在向量数据库中做余弦相似度检索,找到视觉上最接近的图片。
这意味着你不需要记住文件名——只需描述内容,AI 就能帮你找到。这种能力在处理收藏的图片素材、回忆照片、整理视频素材时极其有用。
Panoptikon 的强大之处在于它集成了多种 AI 模型,形成了一套完整的多模态处理流水线:
1. CLIP 图像向量化(OpenCLIP / JINA CLIP) 支持 OpenCLIP 和 JINA CLIP 作为图像 embedding 模型。图像经过模型编码后生成高维向量,存入 sqlite-vec 向量数据库。搜索时将文字 query 编码后在向量空间中做相似度匹配。
2. Whisper 语音转文字(Faster Whisper) 对视频和音频文件,自动调用 Faster Whisper(CTranslate2 优化版,速度提升 2-4 倍)提取语音内容,生成全文索引。这意味着你可以搜索"视频里谁提到了某个关键词",而不是只能按文件名搜索。
3. OCR 文字识别(EasyOCR / DocTr / pypdfium2) 对于扫描件 PDF 或图片中的文字,Panoptikon 调用 EasyOCR 或 DocTr 进行 OCR 识别,提取可搜索的文本内容。PDF 页面还会用 pypdfium2 渲染为图像,供 CLIP 做视觉特征提取。
4. 语义标注与标签系统(Florence-2 / WD-Tagger / 定制模型) 每张图片会自动打上标签(如"狗"、"户外"、"阳光"等)。Panoptikon 支持在搜索时选择多个标注模型,设置为"任一匹配"或"全部匹配",实现多模型结果的联合查询。这一特性让它成为评估不同标注模型实际效果的绝佳工具。
5. Sentence Transformers 文本向量化 对提取的文字内容(OCR 文本、视频字幕、音频转录稿)做语义向量化,支持全文语义搜索,而非简单的关键词匹配。
6. 分布式推理架构(Inferio + Ray Serve) Inferio 是 Panoptikon 配套的推理服务,基于 Ray Serve 构建,支持多模型并发推理和 GPU 资源池化管理。它通过 FastAPI 暴露推理 API,Panoptikon 主服务通过 HTTP 调用 Inferio 做批量推理,实现主服务和推理服务解耦。
7. 多索引并行搜索 Panoptikon 的一大亮点是支持将不同模型产生的多个索引并存展示。你可以同时启用 CLIP 索引、Florence-2 标注索引、OCR 文本索引,搜索结果可以按模型来源分组呈现,也可以合并展示。
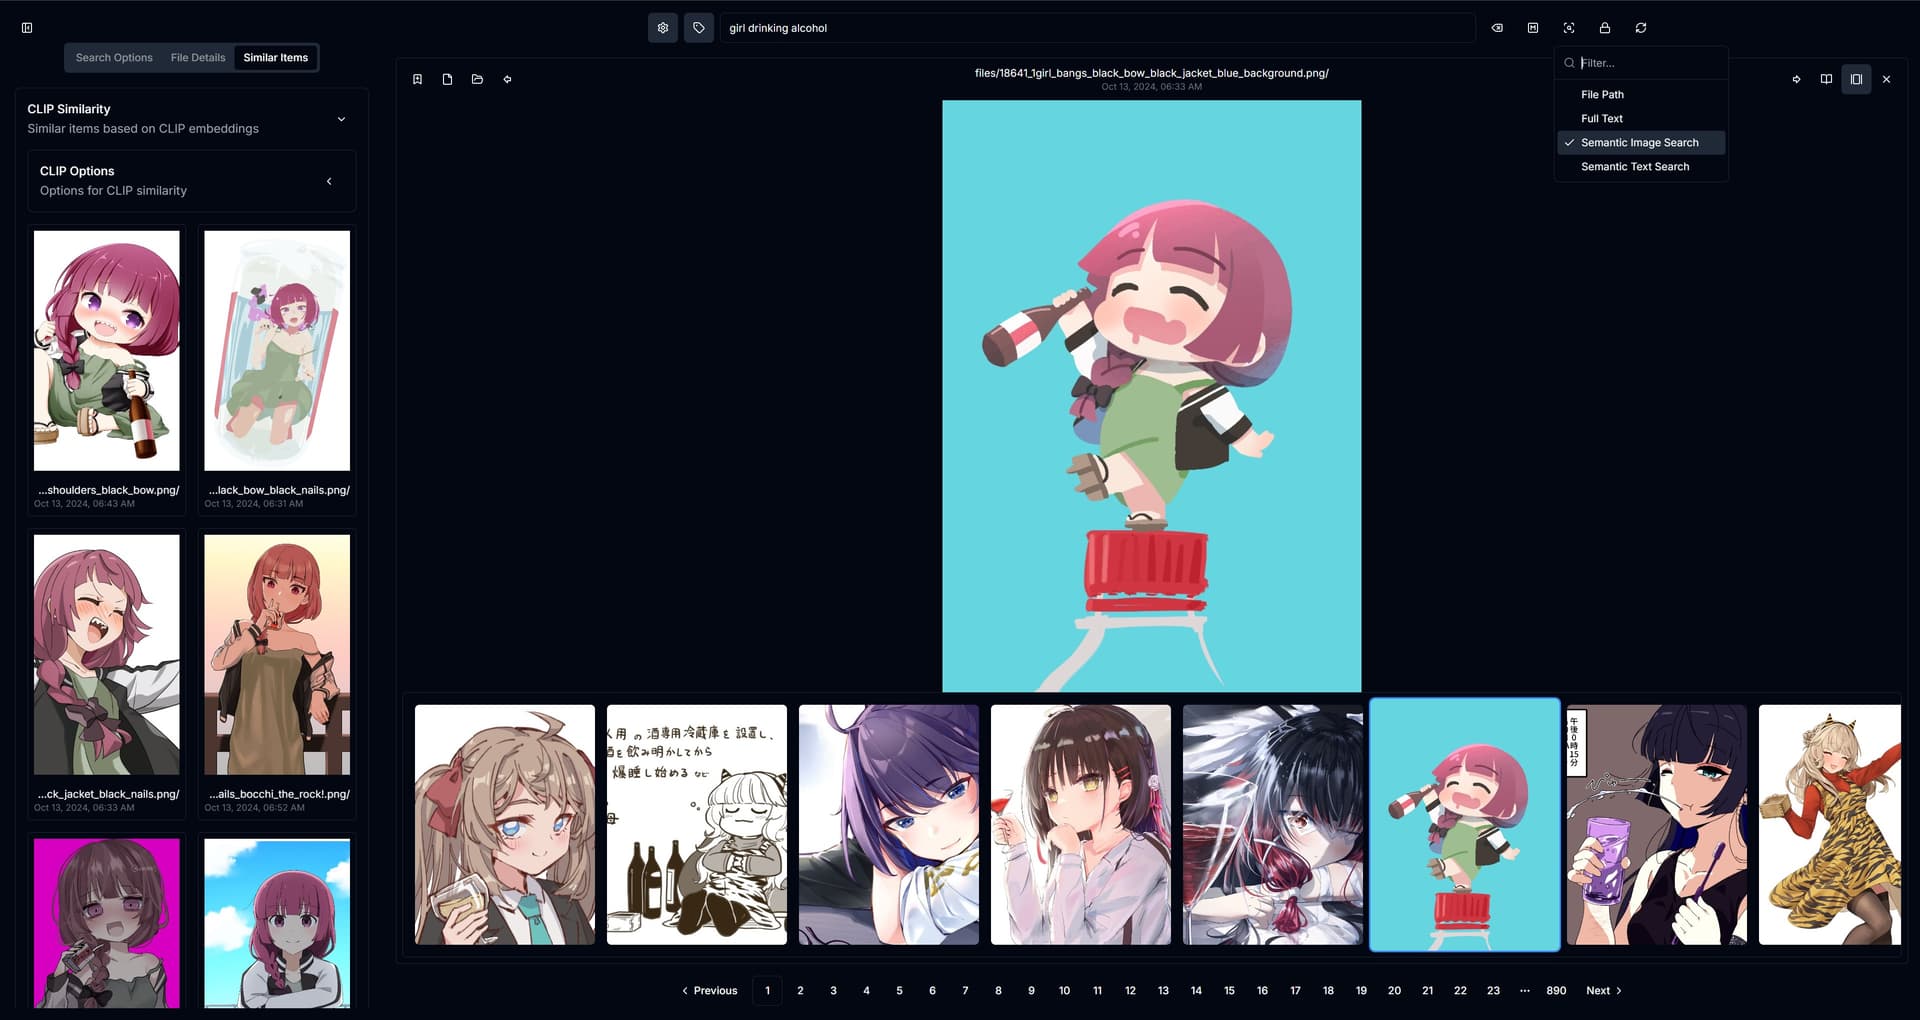
图1:Panoptikon 搜索界面,支持自然语言查询本地多媒体文件
Panoptikon 提供了完整的 docker-compose 一键部署方案,包含 5 个容器服务:
| 容器 | 角色 | 说明 |
|---|---|---|
inferio | GPU 推理服务 | 运行 CLIP、Whisper 等 AI 模型,支持 NVIDIA GPU |
panoptikon | 主 API 服务 | FastAPI 后端,处理文件扫描、索引管理、搜索查询 |
panoptikon-ui-private | 私有 Web UI | 完整功能版管理界面 |
panoptikon-ui-public | 公开 Web UI | 受限模式,禁用危险 API |
nginx | 反向代理 | 端口 6339(公开)、6340(私有) |
硬件要求:强烈建议使用 NVIDIA GPU(至少 8GB VRAM),因为 CLIP 和 Whisper 推理是内存和计算密集型任务。无 GPU 的 CPU-only 模式也能运行,但索引速度会显著下降。Docker 镜像基于 nvidia/cuda:12.8.1-cudnn-runtime-ubuntu24.04。
安装流程:安装 Docker Desktop + nvidia-container-toolkit,克隆仓库后设置环境变量 FILE_FOLDER_PATH 指向要索引的目录,docker-compose up -d 一键启动,访问 http://localhost:6339 即可使用(默认 localhost 绑定,无认证)。
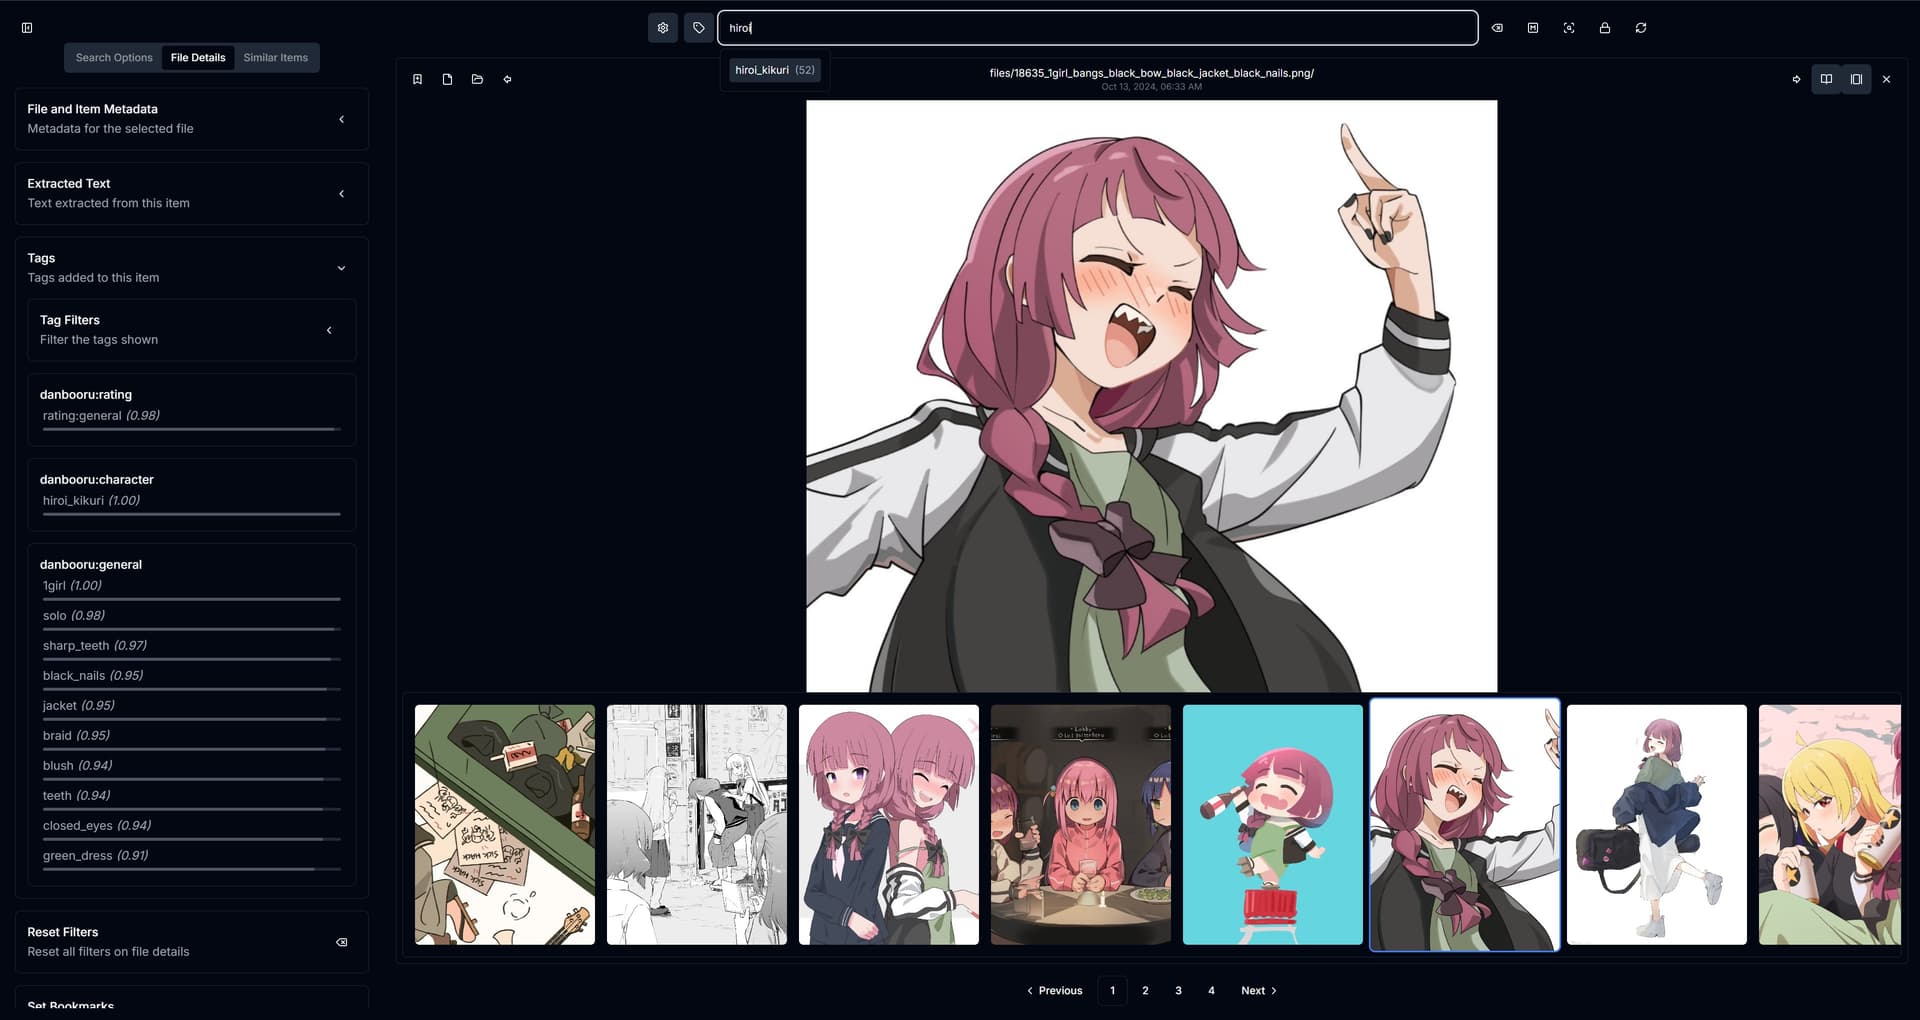
图2:索引管理界面,支持多目录扫描和任务队列监控
Panoptikon 的代码库是一个混写架构(Python + Rust + TypeScript),体现了作者对不同语言优势的精准把握:
后端(Python):FastAPI 驱动的 REST API + Ray Serve 推理服务。核心模块包括:
panoptikon/ — 主服务,负责文件扫描、索引写入、搜索 API、数据库管理inferio/ — 推理服务封装,封装了 CLIP、Whisper、Florence-2 等模型的批量推理逻辑panoptikon/data_extractors/ — 数据提取器,处理图像缩略图生成、blurhash 计算、音频视频解析panoptikon/db/ — SQLAlchemy 数据库层,管理 SQLite + sqlite-vec 向量数据库网关层(Rust):gateway/ 是 Rust 编写的反向代理,负责路由策略强制和本地 API 扩展。这是作者在生产环境中逐步演进出来的架构,反映了真实工程中的演进路径。
前端(Next.js / searchui):src/searchui/panoptikon-ui 是基于 Next.js 的响应式 Web UI。
关键依赖生态:
代码质量方面:项目使用 Black(line-length=80)强制格式化,完整 pytest 测试套件,且模型推理代码有专门的集成测试。项目文档质量极高,每个子模块都有 README 和 AGENTS.md 开发指南,docker-compose 配置详尽,.env.example 注释完善。
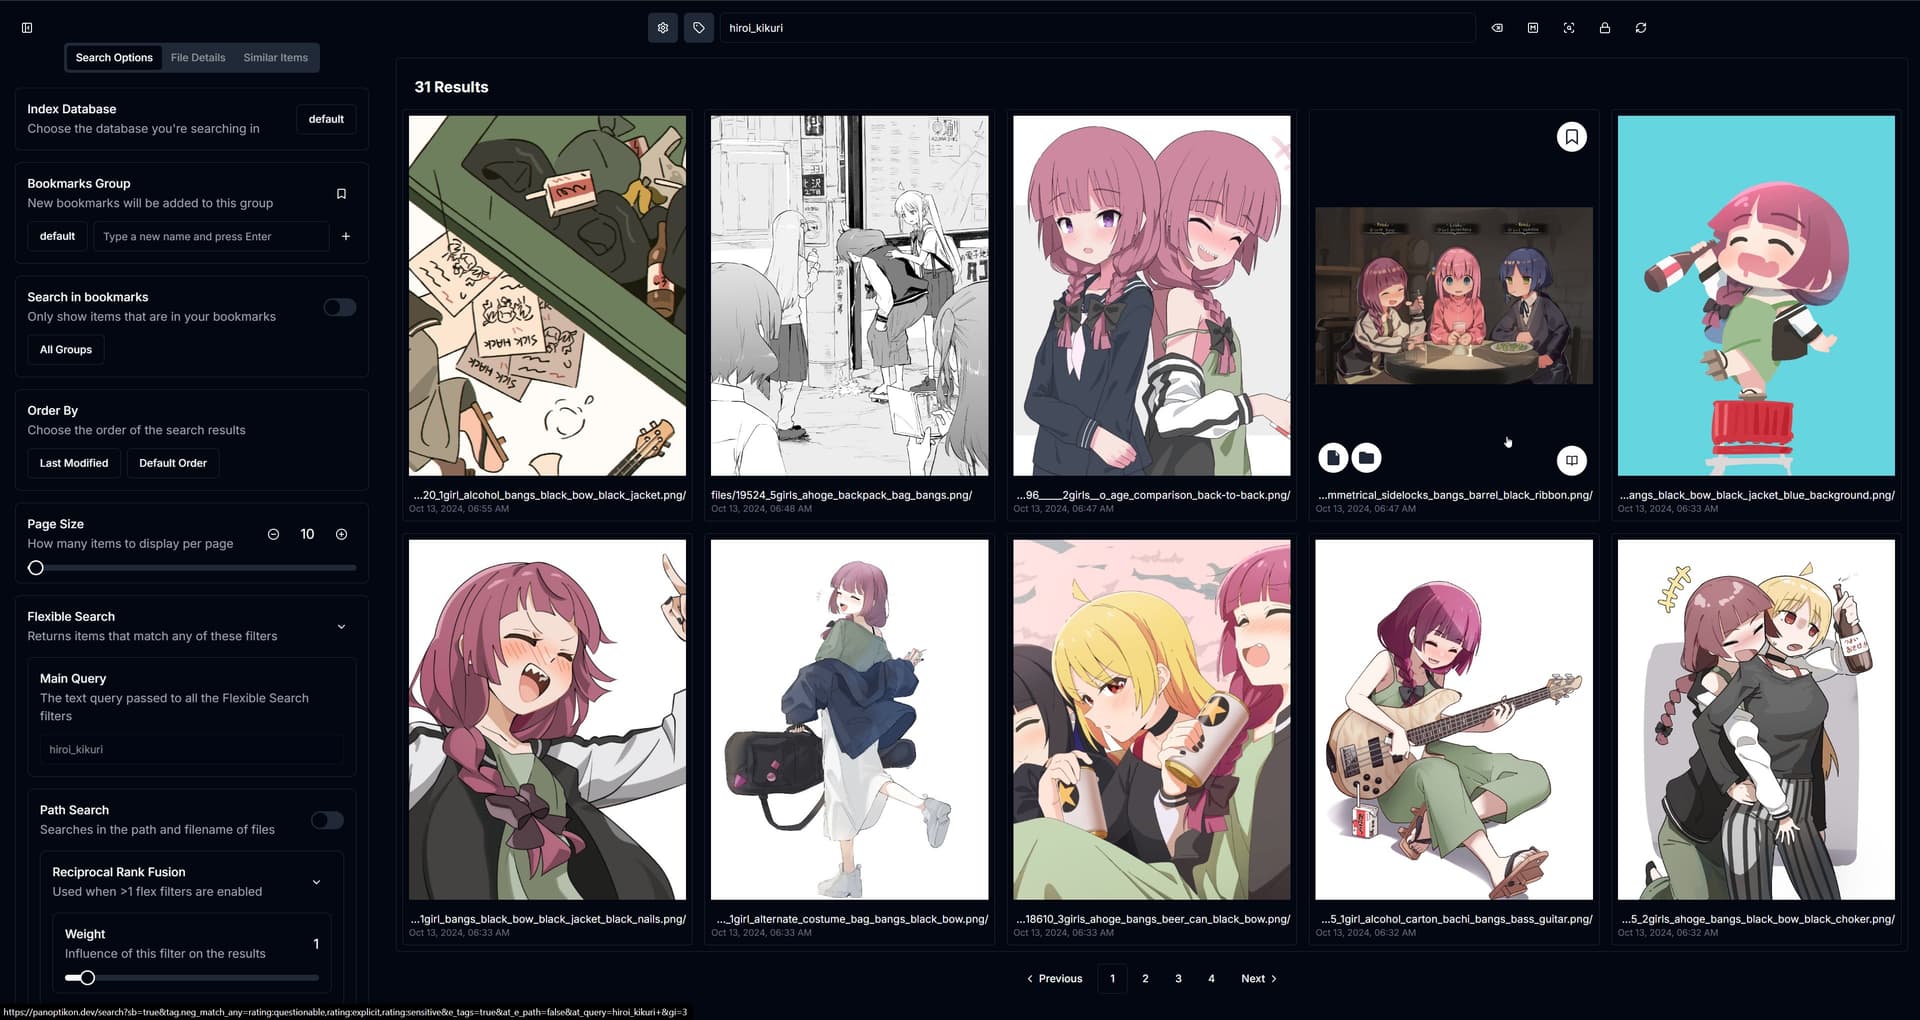
图3:多模态搜索结果,支持图像、OCR 文本、语音转录的联合语义检索
安全警告:Panoptikon 默认绑定 localhost,无内置认证机制。它暴露的 API 可执行任意命令(如打开文件管理器、运行自定义脚本),作者在 README 中明确警告不要直接暴露到公网。docker-compose 中的 panoptikon-ui-public 是专门设计的受限模式,禁用了危险 API,但仍需配合 nginx 的 HTTP Basic Auth 才适合公网暴露。
性能限制:推理服务目前没有请求去重(debounce),搜索框每次按键都会触发 API 请求,多人同时访问公开实例时响应会变慢。作者坦承这是公开演示用的设计取舍。
社区活跃度:Stars 69,Forks 7,Open Issues 3,仓库更新频率中等,文档相对完善但缺乏官方博客或视频教程。AGPL-3.0 开源许可要求衍生作品也必须开源。
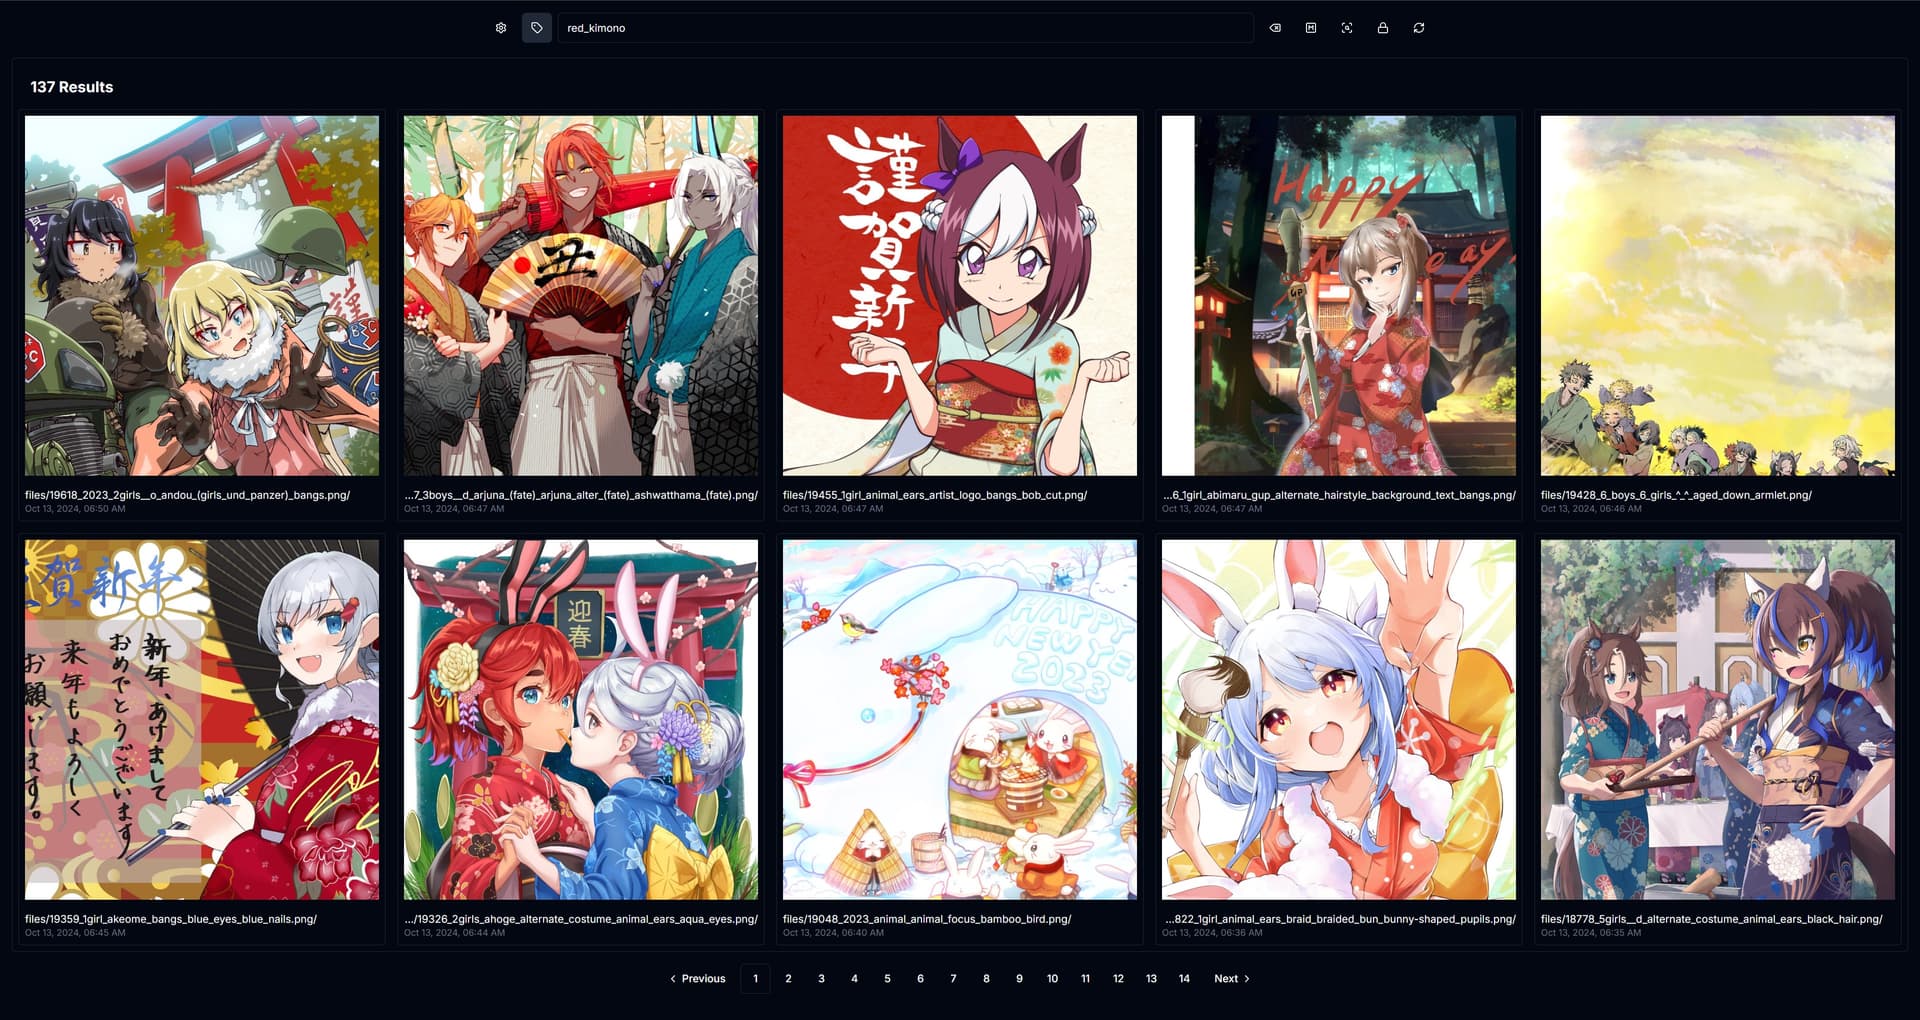
图4:模型配置界面,支持 OpenCLIP、Florence-2、Sentence Transformers 等多种模型的切换与对比
Panoptikon 代表了本地 AI 推理能力普及的一个方向。随着开源模型(CLIP、Whisper、Florence-2)的能力持续提升,曾经只有云端服务才能实现的多模态语义搜索,如今完全可以在个人设备上运行。Panoptikon 的设计哲学——不触碰原始文件 + 多索引并行对比——对 AI 研究者和发烧友尤其有价值,它不只是一个工具,更是一个多模型横向评测平台。
其"像 stable-diffusion-webui 一样易用"的目标定位,意味着未来普通用户也能享受本地 AI 带来的搜索革命。随着模型体积优化和硬件成本下降,本地多模态搜索将成为继本地 AI 绘图之后,又一个从云端回迁到本地的 AI 应用场景。
