
openreality
reality-opened/openreality加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:你举起手机,在客厅里绕着走一圈,把这段视频随手丢给电脑里的 AI 助手,然后直接问它:"沙发到茶几有多远?" "从门口到书桌怎么走?" "把这个房间导出成机器人训练数据。" 过去的 AI 只能看见二维图片,答不上来这类问题;Open Reality 想做的,就是给 AI 装上一双能理解空间的眼睛,再给它一张能走动的地图。
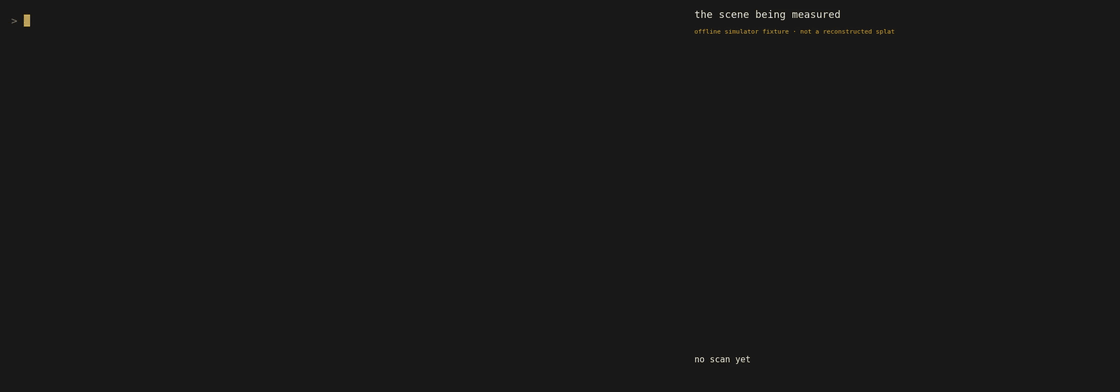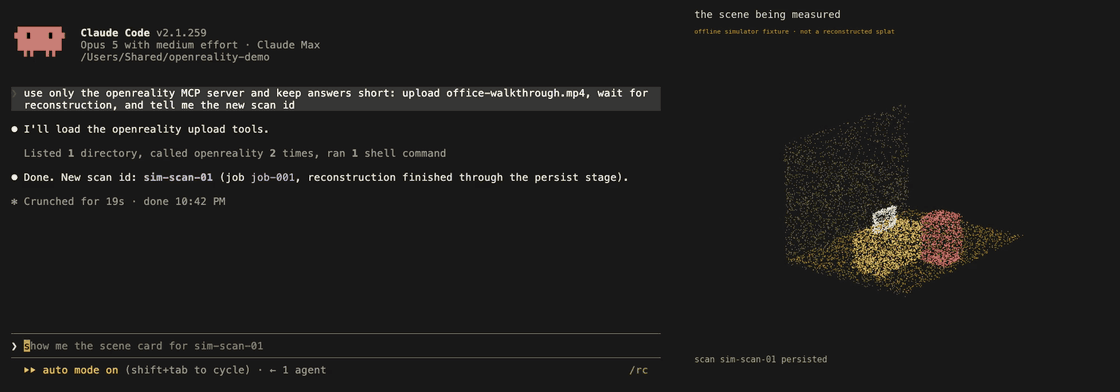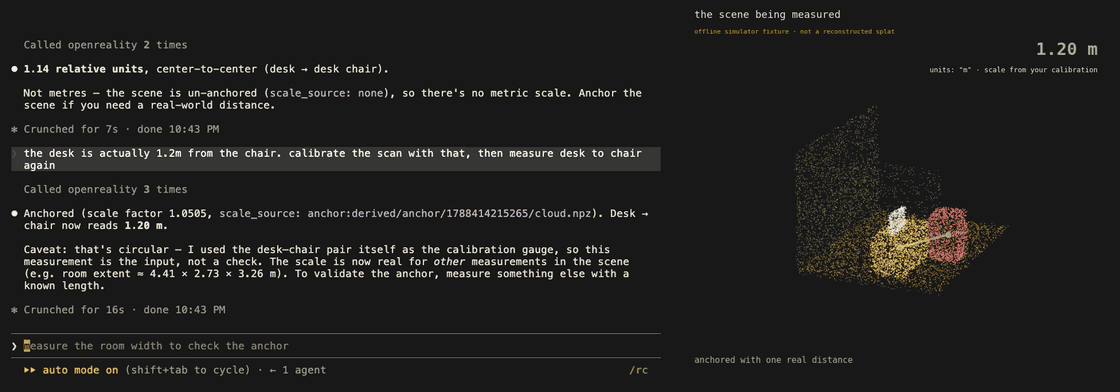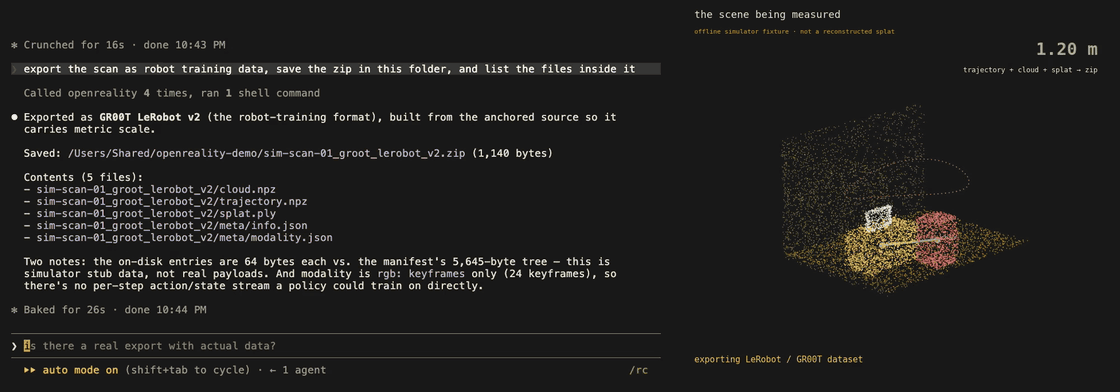
图 1:真实的 Claude Code(Opus)会话驱动内置离线模拟器,右侧为同步的三维场景面板
大模型能处理文字和图片,但"空间"一直是它们的短板。房间有多大、门在哪个方向、这张桌子和那张椅子的相对位置如何——这些问题需要三维几何、相机位姿和场景语义,光靠一次截图回答不了。
Open Reality 的定位很明确:用普通手机视频重建出持久化的三维场景,并通过 MCP(Model Context Protocol)把这套空间能力开放给 Claude Code、Codex、Cursor 等 AI 助手。项目自我描述为"任何硬件的 Agentic OS",愿景是把 AI Agent 从纯数字空间推进到物理世界。
它的价值链有三段:
Open Reality 站在多位"巨人"肩上,这一点在 README 的致谢里写得很坦白:
core/ 里的重建核心就是这条 VGGT-SLAM 2.0 线路;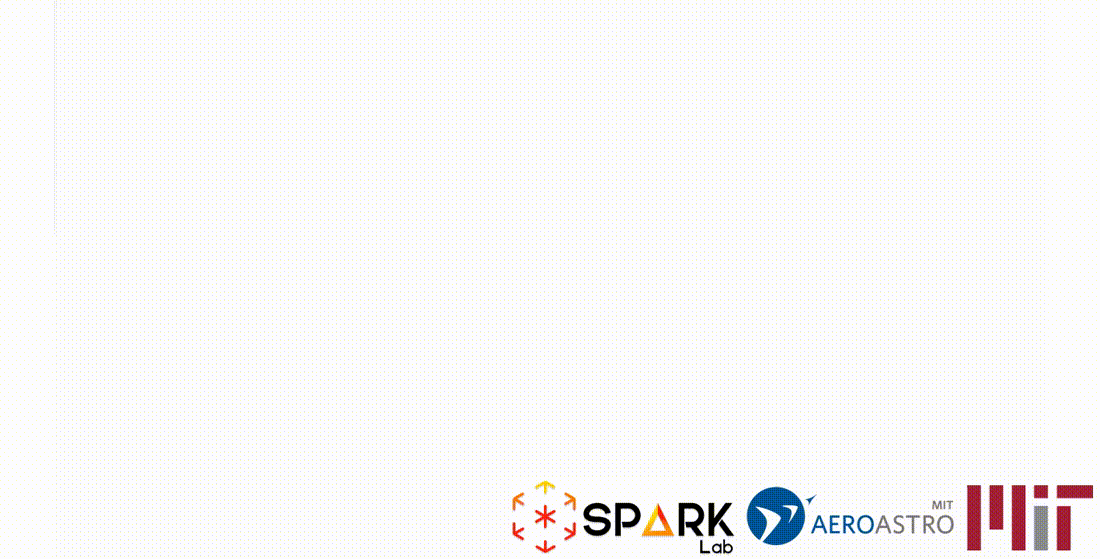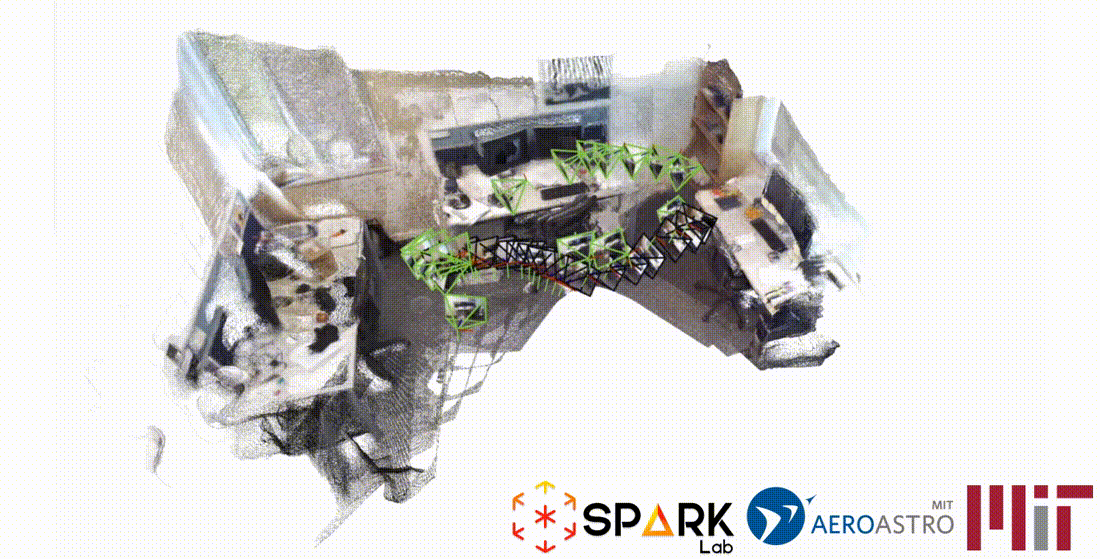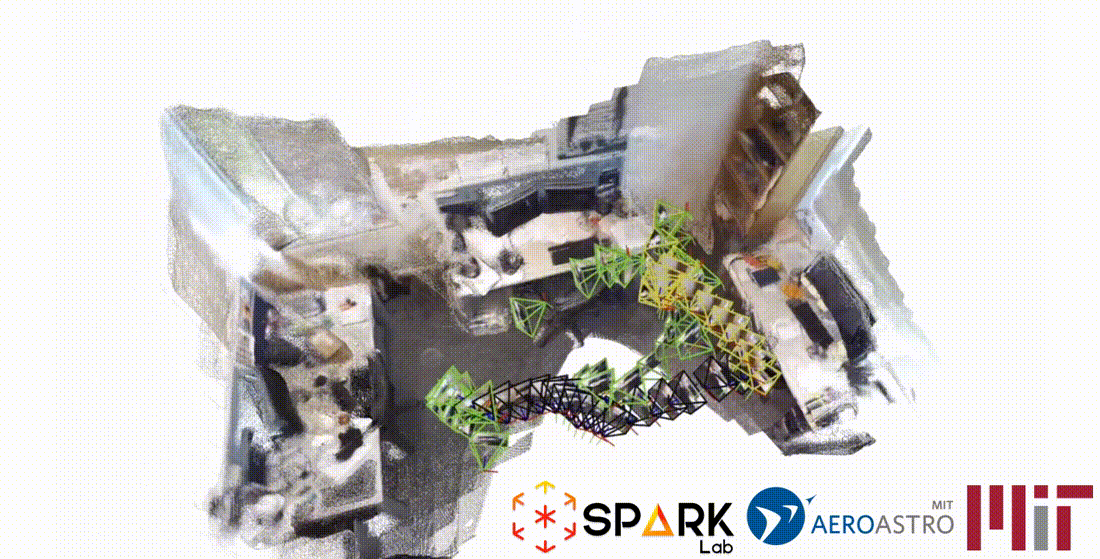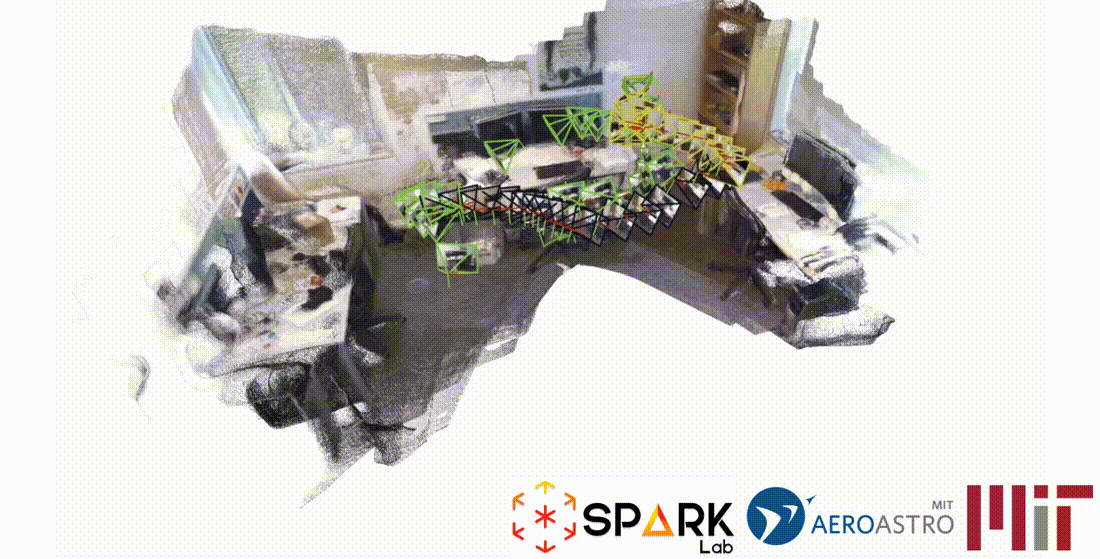
图 2:手持视频的实时重建过程,相机路径与三维场景一同构建(素材来自 MIT SPARK 的 VGGT-SLAM)
有意思的是"开放集检测"这个设计:你不从固定类别列表里挑目标,而是用自然语言说"我要找沙发和茶几",系统直接把这些物体分割出来并锚定到三维地图里,且随着扫描推进保持位置不漂。
Open Reality 最被强调、也最值得单独拿出来讲的一点,是它的**"诚实性教条"(honesty doctrine)**。
在三维重建里,单目 SLAM 天然缺乏绝对尺度——你重建出的"2.4 米"可能只是 2.4 个任意单位。很多项目会直接把这个数字当作米报给用户,这在机器人场景下是危险的。Open Reality 的做法是:未经真实距离标定,所有数值一律标注为 relative(相对单位),只有当你用一段已知的真实距离做过标定(anchor)之后,才允许说"米"。
更狠的是,服务器端的拒答和不确定性标签会原封不动地传给模型,不做美化、不做软化。配套文档甚至专门写了一篇《为什么我们的三维工具在你证明之前拒绝说"米"》来解释这件事。AI 助手拿到的不是一个被粉饰过的数字,而是带着来源标签和降级标记的原始结论。
这背后是同一个架构原则:MCP 进程永远跑在用户自己机器上。它只做薄薄一层类型化 REST 客户端,凭证和大文件留在本地磁盘,绝不塞进 AI 的上下文里。
这是一个把"能自己长大"的三件套装进同一个仓库的公开镜像:
| 目录 | 角色 | 交付形态 |
|---|---|---|
mcp/ | MCP 服务器:42 个工具、场景资源、离线模拟器、完整测试套件 | npm 包 openreality-mcp(v0.4.0) |
server/ | 后端 broker:视频转持久场景,提供测量、规划、Agent、导出等 REST API | 源码(私有仓库的公开镜像) |
core/ | 三维重建库:相机跟踪、稠密几何、度量标定、开放集检测、高斯泼溅导出 | 源码(openreality-core v2.2.2) |
技术上是一个双语言栈:Python 承担重建与后端(PyTorch / Open3D / GTSAM / Flask,代码量约 359 万字节),TypeScript 承担 MCP 层(cordis 插件化架构 + MCP TypeScript SDK + zod,约 22.9 万字节)。
代码工程化上有几个明显亮点:
server/tests/ 下 95 个测试文件(导出、摄取、导航、测量、分享、计费、LOD、QC、SAM3D 等几乎全覆盖),core/tests/ 9 个,MCP 侧 7 个(cordis 生命周期、端到端、模拟器契约、stdio 传输等);mcp/ 采用全插件式 cordis 架构,工具注册走 ctx.effect() 可注销;vendor/protocol 是私有协议包的固定副本,"拥有但不修改";server/ 和 core/ 的 MIRROR.md 明确记录上游私有仓库、同步 commit、手工同步流程与本地改动,是相当诚实的开源做法;docs/ 下有 8 篇后端专题文档、演示渲染脚本,CLAUDE.md 规约细致到"文档不用破折号"。
图 3:npm 包 openreality-mcp 的图标
路径一:只当 MCP 客户端用(最简单)
claude mcp add --scope user openreality -- npx -y openreality-mcp serve
openreality-mcp login   # 浏览器登录一次,存下可吊销的 ork_ API Key
代码量一行,Node 20+ 即可。真实使用需要 open-reality.io 账号;想完全离线开发,用 openreality-mcp simulator 起一个假后端,用 fixture 数据模拟全流程,无账号无 GPU 也能开发和演示。
路径二:自托管(中等)
cd openreality/server
python -m server.selfhost --data-dir ~/openreality-data --port 8000
或用 modal deploy modal_selfhost.py 部署到自己的 Modal 账号(CPU broker + A10G GPU worker)。自托管模式用一个静态 bearer 令牌取代 Clerk 登录,单用户设计。
路径三:完整自建三维管线(最难)
需要 CUDA GPU(推荐 24GB+ 显存)、48GB+ 内存、Python 3.11,还要手动克隆 MIT-SPARK 的 VGGT_SPARK 分支并 checkout 到指定 commit 装成第三方包,另外可选装 salad 做回环检测。工作量真实存在。
1. 许可问题是最硬的坎。 仓库本体是 BSD-2-Clause,但自托管时下载的重建骨干模型(VGGT-1B 权重 + VGGT 代码)以及度量锚定用的 Depth-Anything-V2 Large 都是 CC BY-NC 4.0,仅限非商业使用。项目对此毫不含糊地反复声明:"自托管栈因上游模型许可而非商业可用,商业使用请用托管服务或自行取得授权。"想拿它做商业产品的团队,这一条必须先过法务。
2. v1 明确缺失的功能。 官方文档自己列出"能跑什么、不跑什么":机器人录制摄取(DimOS 管线)、isaac_usd 导出通道、手机实时流式会话这三项在 v1 里明确拒答而不是假装能跑。本地实时扫描需要直接跑 python -m server.app。这种"诚实失败"是加分项,但也意味着能力边界比宣传页窄。
3. 关键子系统不在公开仓库里。 商用的 VGGT-Omega 骨干 shim 被明确排除在镜像之外,托管服务用的是"商业授权的模型"。也就是说开源部分与线上产品并不完全等价,评估能力时要看清自己拿到的到底是哪一块。
4. 成熟度偏早期。 仓库 2026 年 9 月 1 日创建,10 月 25 日仍有提交;npm 包周下载量仅 12,star 464 但 fork 只有 3(典型的"围观型"社区);贡献者只有 1 人(bdavidzhang)。维护者自己在 README 里说"自托管路径还很年轻,附带日志提 issue 是最好的支持方式"。开放 issue 里还挂着"Windows 登录流程验证""为单 GPU 机器提供 docker-compose"这类基础问题——仓库里目前确实没有 Dockerfile 和 docker-compose.yaml。
5. 门槛与收益的匹配度取决于场景。 24GB 显存的重建作业、几分钟级的重建时延、模型下载体积,对只想"问一下房间布局"的轻度用户来说是重型方案;这类需求用云端托管服务更划算。
Open Reality 把三件事叠在了一起:前馈式大模型驱动的三维重建、MCP 工具生态、以及具身智能的数据闭环。
它的独特切入点不是"再造一个 SLAM 库",而是"造一个 Agent 能直接调用的空间操作系统"。42 个 MCP 工具按 workspace / scene / agent / export / artifact 五个命名空间组织,配合 openreality://scenes 和 openreality://scene/{scan_id} 两个可被 @ 提及的资源,AI 助手可以像读文件一样把场景当上下文拉进来。
更值得关注的是出口:把任意 RGB 演示视频转成尺度一致的 LeRobot episode,直接喂给机器人策略训练。这条链路(demo 视频 → 度量三维 → 物体锚定与轨迹质检 → LeRobot 数据集 → Isaac 预览)目前正处在"sim-to-real 尚未验证"的阶段,但它完整打通了从人类演示到机器人训练数据的最后一公里设想。
在一个"AI Agent 正被塞进摄像头和麦克风"的年份,Open Reality 反其道而行:给 Agent 装上空间。哪怕它现在还年轻、还只有一位主要贡献者、还有一堆只读镜像和拒答式边界,它试图回答的问题——Agent 如何在没有 LiDAR、没有深度传感器的普通手机上,获得关于物理世界可信的三维认知——是接下来几年绕不开的。
数据来源:GitHub API(reality-opened/openreality,464★,BSD-2-Clause,Python/TypeScript,21 次提交,1 位贡献者)、npm openreality-mcp v0.4.0、open-reality.io 官方文档与研究页。分析时间:2026-10-25。
