
ratel
ratel-ai/ratel加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:你让一个 AI 编程助手帮你审查代码,它调用了 50 个工具,但实际上这个任务只需要其中 3 个。更糟糕的是,这 50 个工具的完整 Schema——每个包含名称、描述、参数说明——都被塞进了每一次 API 调用,无论用得上用不上。Token 费用就这样悄悄流失了。
Ratel 解决的就是这个问题。它是一个上下文工程(Context Engineering)框架,专门为 AI Agent 设计,核心能力是:让 Agent 只看到它真正需要的工具和技能,减少 80% 的 Token 消耗,同时将工具选择错误降低 10 倍。
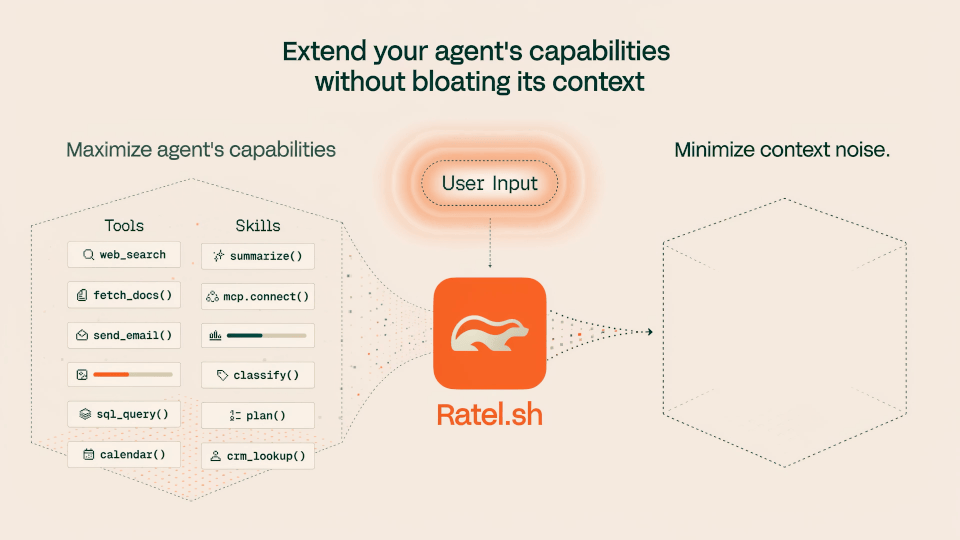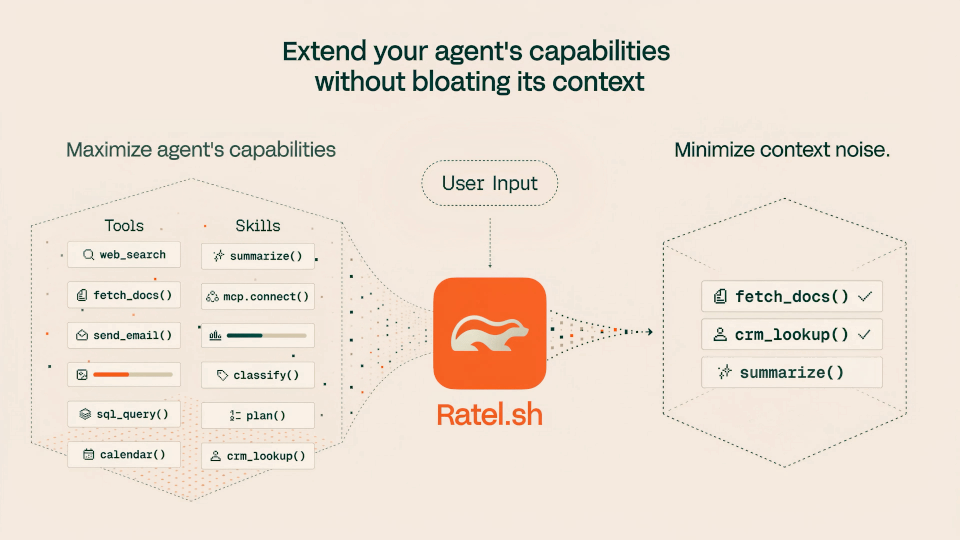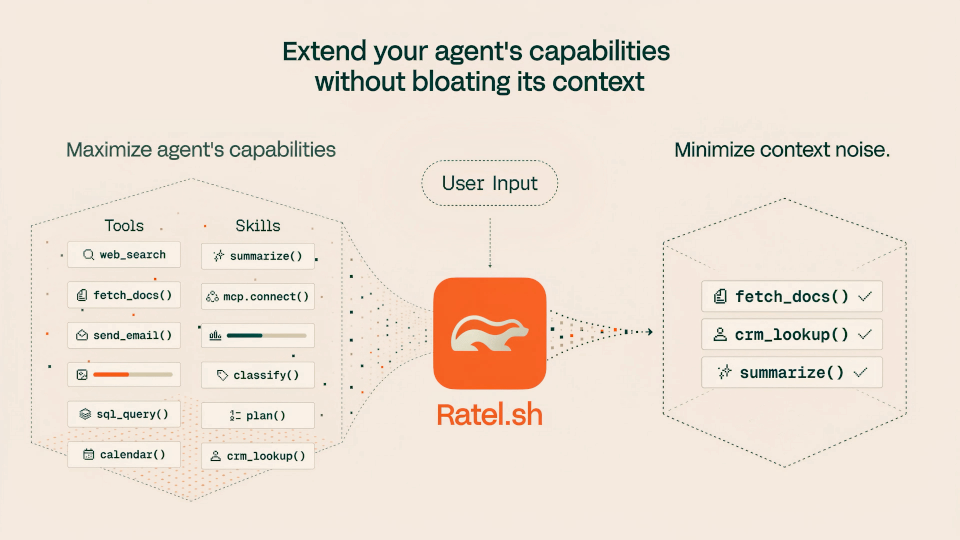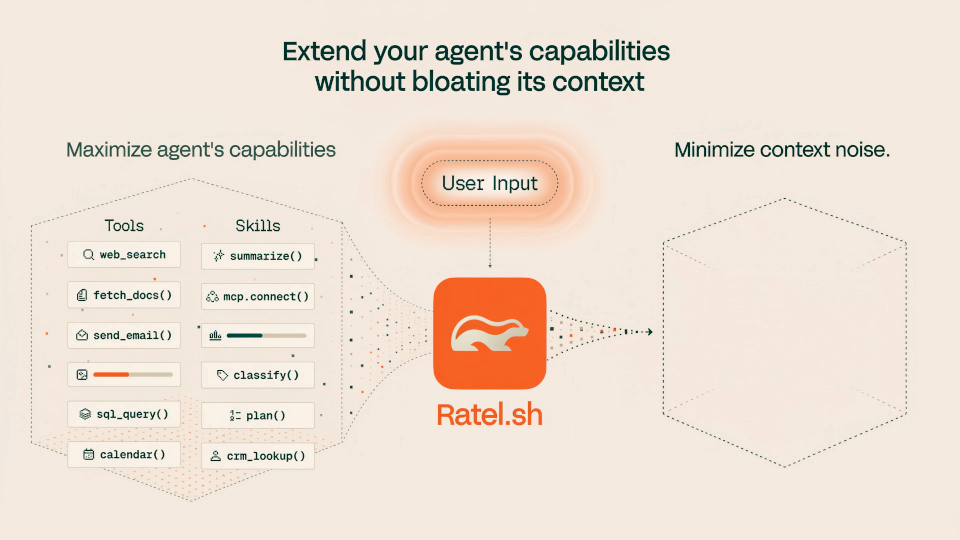 图 1:Ratel 上下文工程框架工作原理
Ratel 由 Agentified 团队开发,最初源于解决 AI 编程工具(如 Claude Code)的痛点。随着 Agent 接入的工具越来越多(几十甚至上百个 MCP 工具、用户自定义技能、Agent 指令等),Token 成本飙升,同时模型在庞大的上下文中更容易选错工具、产生幻觉。
团队选择了一条不依赖向量数据库的技术路线:使用 BM25(大多数搜索引擎背后的经典算法)对工具和技能进行索引,而非昂贵的 Embedding + 向量检索。这使得检索速度快、结果可预期、部署零额外依赖。
Ratel 的设计哲学是**"不要一次性告诉 Agent 所有事情"**。
传统 Agent 框架的通病是:启动时就把所有工具 Schema、全部技能指令塞进系统提示词。Ratel 的做法是建立两个目录(Catalog):
当 Agent 需要行动时,它调用 search_capabilities 接口,Ratel 在目录中搜索,只返回当前任务最相关的工具和技能——而不是把所有东西都扔给 Agent。
搜索策略默认使用 BM25,这是算法的核心优势所在:速度快(无需 GPU)、结果可复现(相同查询总返回相同结果)、内存占用极低。对于需要语义匹配的场景,Ratel 也支持稠密向量检索(Semantic Ranking),作为可选的扩展能力。
Ratel 是一个多语言 monorepo 项目,核心检索引擎用 Rust 编写(src/core),外层通过 NAPI(Node.js)和 PyO3(Python)提供原生绑定,确保高性能和广泛兼容性。
| 模块 | 技术栈 | 说明 |
|---|---|---|
src/core | Rust | 核心检索引擎,提供 BM25 + 可选语义检索 |
src/sdk/ts | TypeScript + NAPI | Node.js SDK,通过原生 addon 调用 Rust 引擎 |
src/sdk/python | Python + PyO3 | Python SDK,同理绑定 Rust 核心 |
adapters/ts-vercel-ai-sdk | TypeScript | Vercel AI SDK 适配器 |
adapters/ts-mastra | TypeScript | Mastra Agent 框架适配器 |
protocol/v1 | JSON Schema | 目录数据格式的标准化协议定义 |
整个项目采用 Rust 2024 edition 构建,发布策略也很特别:每个发布单元(core、sdk-ts、sdk-python)独立打版本 tag,互不耦合——这对于 SDK 生态来说非常重要。
Ratel 对开发者非常友好,提供 npm、PyPI、crates.io 三个主流包管理器安装。
TypeScript 示例(Vercel AI SDK 环境):
安装 SDK 后注册工具和技能目录,获得 Agent 可调用的检索工具。搜索结果返回匹配的工具 id 和技能内容,Agent 可以精确调用需要的那一个,而不是遍历整个工具列表。
根据项目披露的基准测试(benchmark.ratel.sh),Ratel 在多种模型配置(本地、开源、边界模型)下均实现了显著改善:
这种性能提升对于生产环境中的高频 Agent 调用场景意义重大,尤其在 token 成本敏感的应用中(如长对话、多轮交互、大规模并发)。
Ratel 不重复造轮子,而是选择与现有 Agent 框架深度集成。当前官方支持:
ratel-mcp 独立分发包,专为本地 Coding Agent 设计对于 MCP 用户,ratel-mcp 允许在已有的 MCP 工具集前面加一层 Ratel 检索层,实现工具的动态筛选,而无需修改现有 MCP 配置。
Ratel 并非万能药,有几个值得关注的局限:
1. 无 Web UI,纯 SDK 方案 Ratel 只提供编程接口,没有图形界面或托管服务。对于不写代码的用户(如产品经理、非技术创始人),上手门槛较高。
2. 密集向量化检索是附加能力 BM25 擅长关键词匹配,但面对语义相似但表述不同的问题(如"帮我看看这个文件"和"检查代码内容"),向量检索效果更好。Ratel 的语义检索需要额外配置(注册 OpenAI 兼容的 Embedding 端点或本地模型),默认配置下不可用。
3. 社区生态尚处早期 截至目前 stars 370,fork 15,open issues 15——项目体量属于早期阶段。虽然文档和代码质量不错,但生态丰富度(第三方集成、插件市场、社区案例)相比同类竞品还有差距。
Ratel 代表了一个重要趋势:从"给 Agent 更多工具"到"给 Agent 更精准的工具"。
随着 Agent 接入了数十上百的工具和技能,上下文窗口不再是无限的(即使 Claude 3.7 给了 200K tokens,费用和注意力资源依然是约束)。Ratel 的渐进式披露思路——只给 Agent 需要知道的东西——是一种朴素但有效的解法。
不使用向量数据库的设计决策也值得注意:在企业场景中,引入新的基础设施(Pinecone、Chroma 等)意味着额外的运维成本和学习曲线。Ratel 选择 BM25 作为默认检索算法,降低了部署门槛,也更符合"嵌入式 AI"(Edge AI)的趋势。
| 维度 | 评估 |
|---|---|
| 核心价值 | Token 降本 + 准确率提升 |
| 技术特色 | BM25 索引 / 无向量 DB / 多语言 SDK |
| 部署难度 | 极简(pip/npm 安装即可) |
| 适用场景 | 工具丰富的 AI Agent 开发 |
| 当前阶段 | 早期开源,社区待成长 |
| 长期潜力 | 高(Token 优化是刚需) |
如果你正在构建 AI Agent,尤其接入了大量工具和技能,Ratel 值得一试——它可能是目前最低成本的上下文优化方案。
