
billion-context
ranxianglei/billion-context加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你有没有过这种经历:用 Claude Code 或 Codex 写一个大型项目,前半小时一切顺利,模型改文件、跑测试、解释报错,条理清楚;可到了第三十分钟,它开始「犯迷糊」——刚改完的文件记不清了,之前的决策要重新解释一遍,甚至把你明确否决过的方案又提一遍。
多数人以为这是模型变笨了。不完全是。真正的原因是上下文窗口被工具输出撑爆了:一次 Playwright 页面快照能吃掉 56KB 上下文,抓 20 个 GitHub Issue 消耗 59KB,一份 500 条的访问日志又是 45KB。这些还都只是「看」,没开始写代码。跑满 30 分钟,光工具调用的原始输出就能吃掉 40% 的上下文。
等模型被逼到必须压缩对话时,更糟的事情发生了:Claude Code 那种「一次全量摘要」的做法,会把整段历史碾成一个不透明的摘要块并丢弃原文。被丢掉的东西,模型再也想不起来了。
billion-context(下文简称 BC)就是冲着这个痛点来的。它不扩大窗口、不加检索基建、不做训练,而是换了一个思路:让模型自己决定压什么、什么时候压、压多少,并且压完的东西不丢,只是折叠起来,随时可以展开。
项目 Logo:一个会话折叠成「折纸」的意象
BC 的核心结构叫 the fold(折叠)。可以把会话想象成一份不断变长的文档,BC 把它分成两部分:
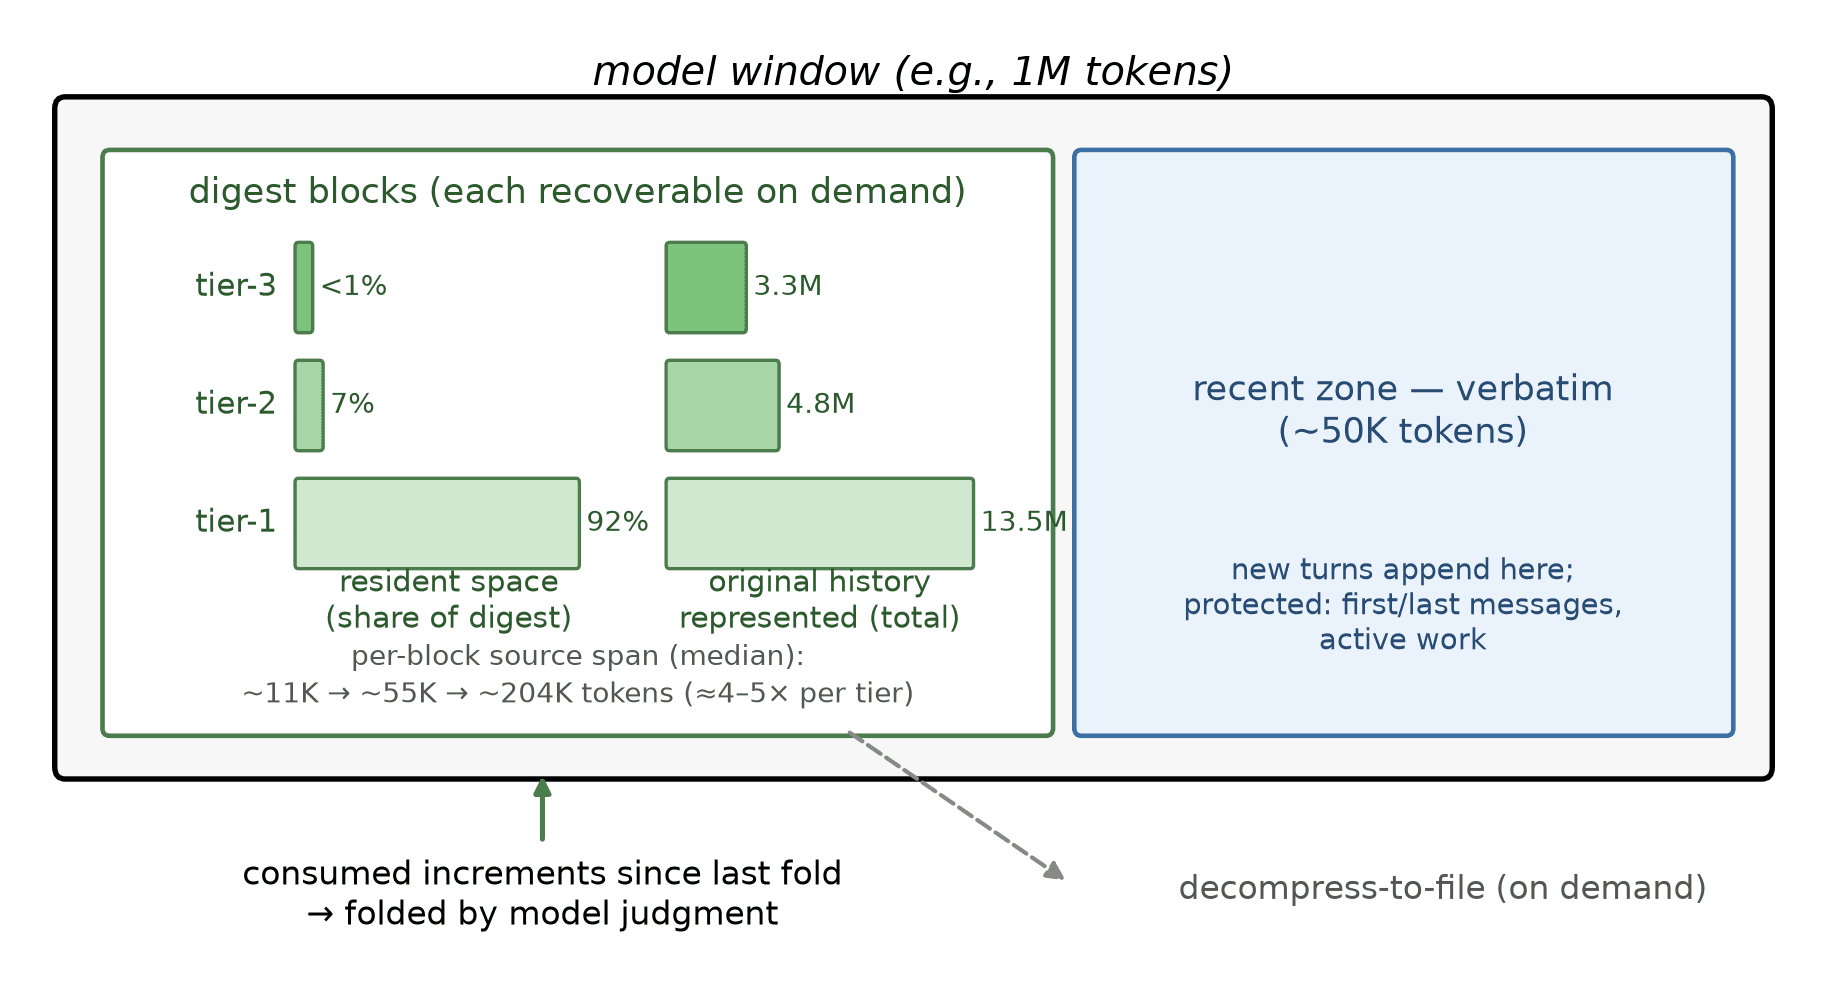
图 1:折叠布局——摘要块堆在头部,活跃工作区保留在尾部
它的压缩有四个非常关键的性质,这也是它和主流做法的区别:
decompress 把某一段还原回原文。在真实生产环境里(作者自述四个半月、三台主机的日常使用),会话历史均值约 90 万 token、中位约 53 万 token,最后只剩下约 1.3 万 token 的摘要——常驻宏观折叠比大约 70 倍。单次压缩的输出中位数只有 185 token,97.5% 的情况不超过 2K token。
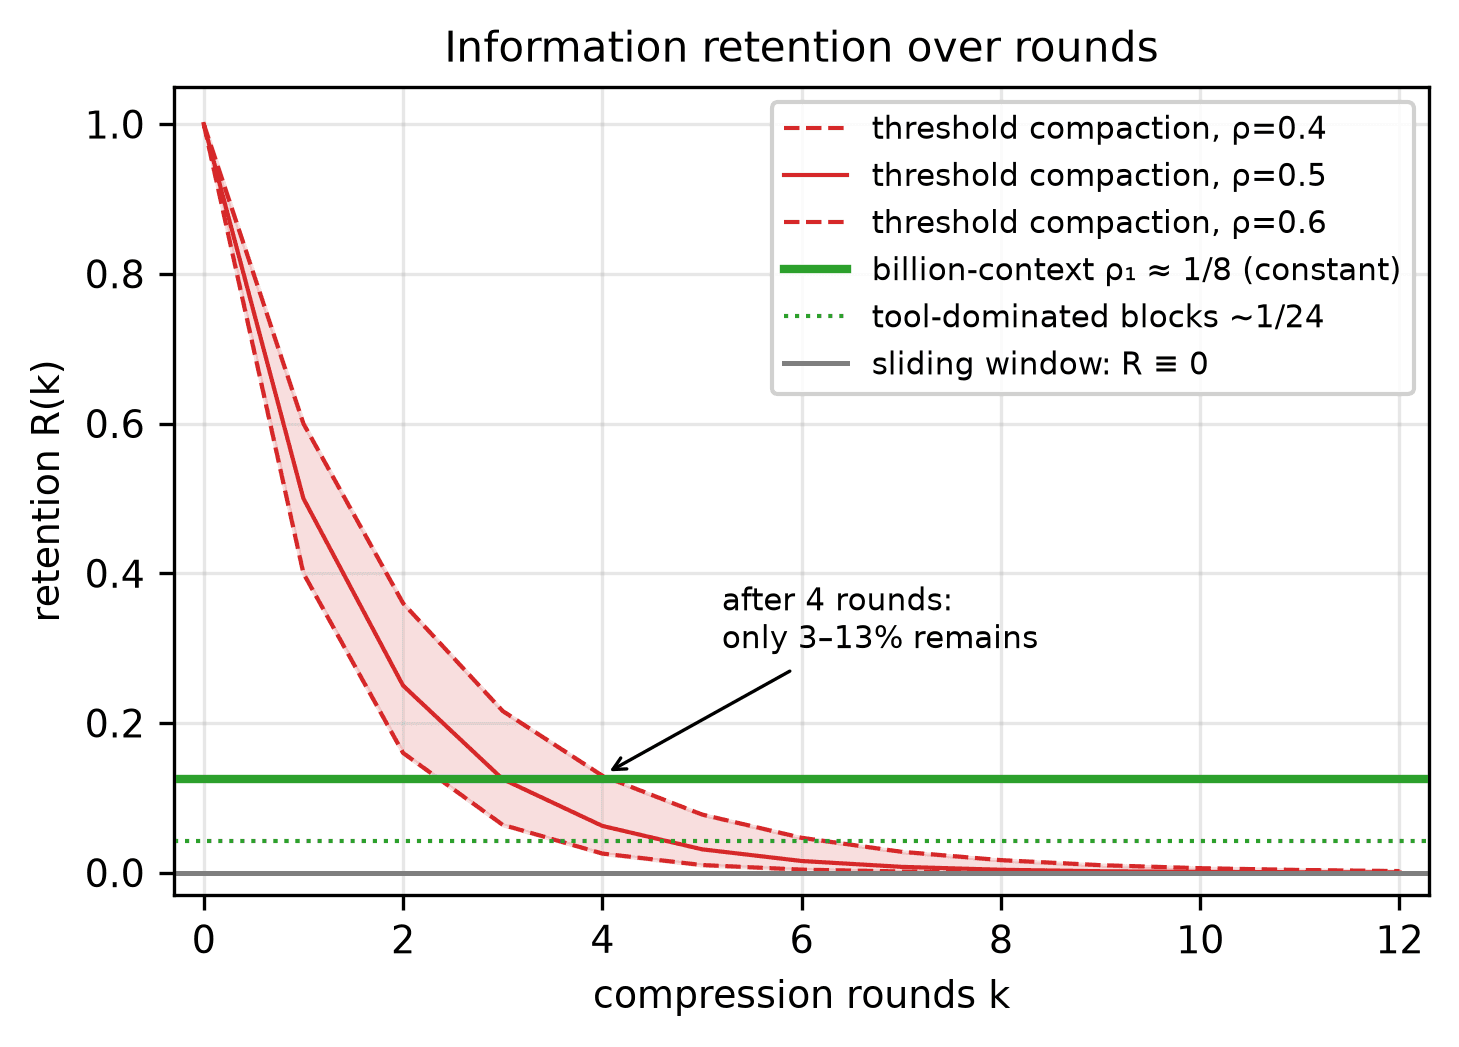
图 2:信息留存曲线——被压缩的内容并非丢弃,而是转成可检索、可恢复的摘要
这是理解 BC 最容易走偏的地方。它不是一个给你 import 的 npm 库,而是一个坐在你的编程助手和模型 API 之间的本地反向代理。
编程助手 (Claude Code / Codex / Cursor / Aider ...)
        │  你把助手的 base URL 指向 proxy
        ▼
┌─────────────────┐
│  billion-context│   1. 解析请求(Anthropic 或 OpenAI 格式)
│     proxy       │   2. 对对话运行 acp-kernel 压缩
│                 │   3. 注入 compress 工具 + 压缩哲学
│                 │   4. 转发到真实模型 API
│                 │   5. 重写流式响应
└─────────────────┘
        ▼
   真实模型 API (Anthropic / OpenAI / 兼容厂商)
代理会向对话注入四个上下文管理工具,由模型在上下文增长时自主调用:
| 工具 | 作用 |
|---|---|
compress | 把一段消息范围折叠成详细摘要 |
decompress | 需要精确细节时恢复某个已压缩范围 |
search_context | 在压缩摘要与可见消息中做关键词检索 |
acp_status | 上下文用量概览 + 哪些区间仍可压缩 |
注入这四个工具,意味着宿主自带的摘要器要关掉(BC 会给 Claude Code 写 DISABLE_AUTO_COMPACT=1),否则两套压缩同时生效会互相打架。项目对此有专门的「原生插件 vs 独立扩展互斥」安装逻辑,装错会退回 .bili-bak 备份。
项目提供三条路径:
bili plugin install <client>,bili 成为客户端内插件,照常启动客户端即可。bili <client> 一条命令拉起代理 + 客户端,不改任何真实配置文件。/bili/ 前缀,最通用但功能最弱(无工具注入接缝)。覆盖面是其一大亮点:README 里列了 20 多个客户端——pi、opencode、omp、dsh、kimi、hermes、zcode、claude、codex、gemini、qwen、aider、copilot、amp、crush、zed、goose、antigravity、mcode、iflow、jcode 等。对闭源二进制(Copilot CLI、Amp、Antigravity)用证书 MITM 拦截;对开源可插拔的(pi、opencode、dsh、kimi、hermes、zcode)走原生插件接缝,能力更完整。
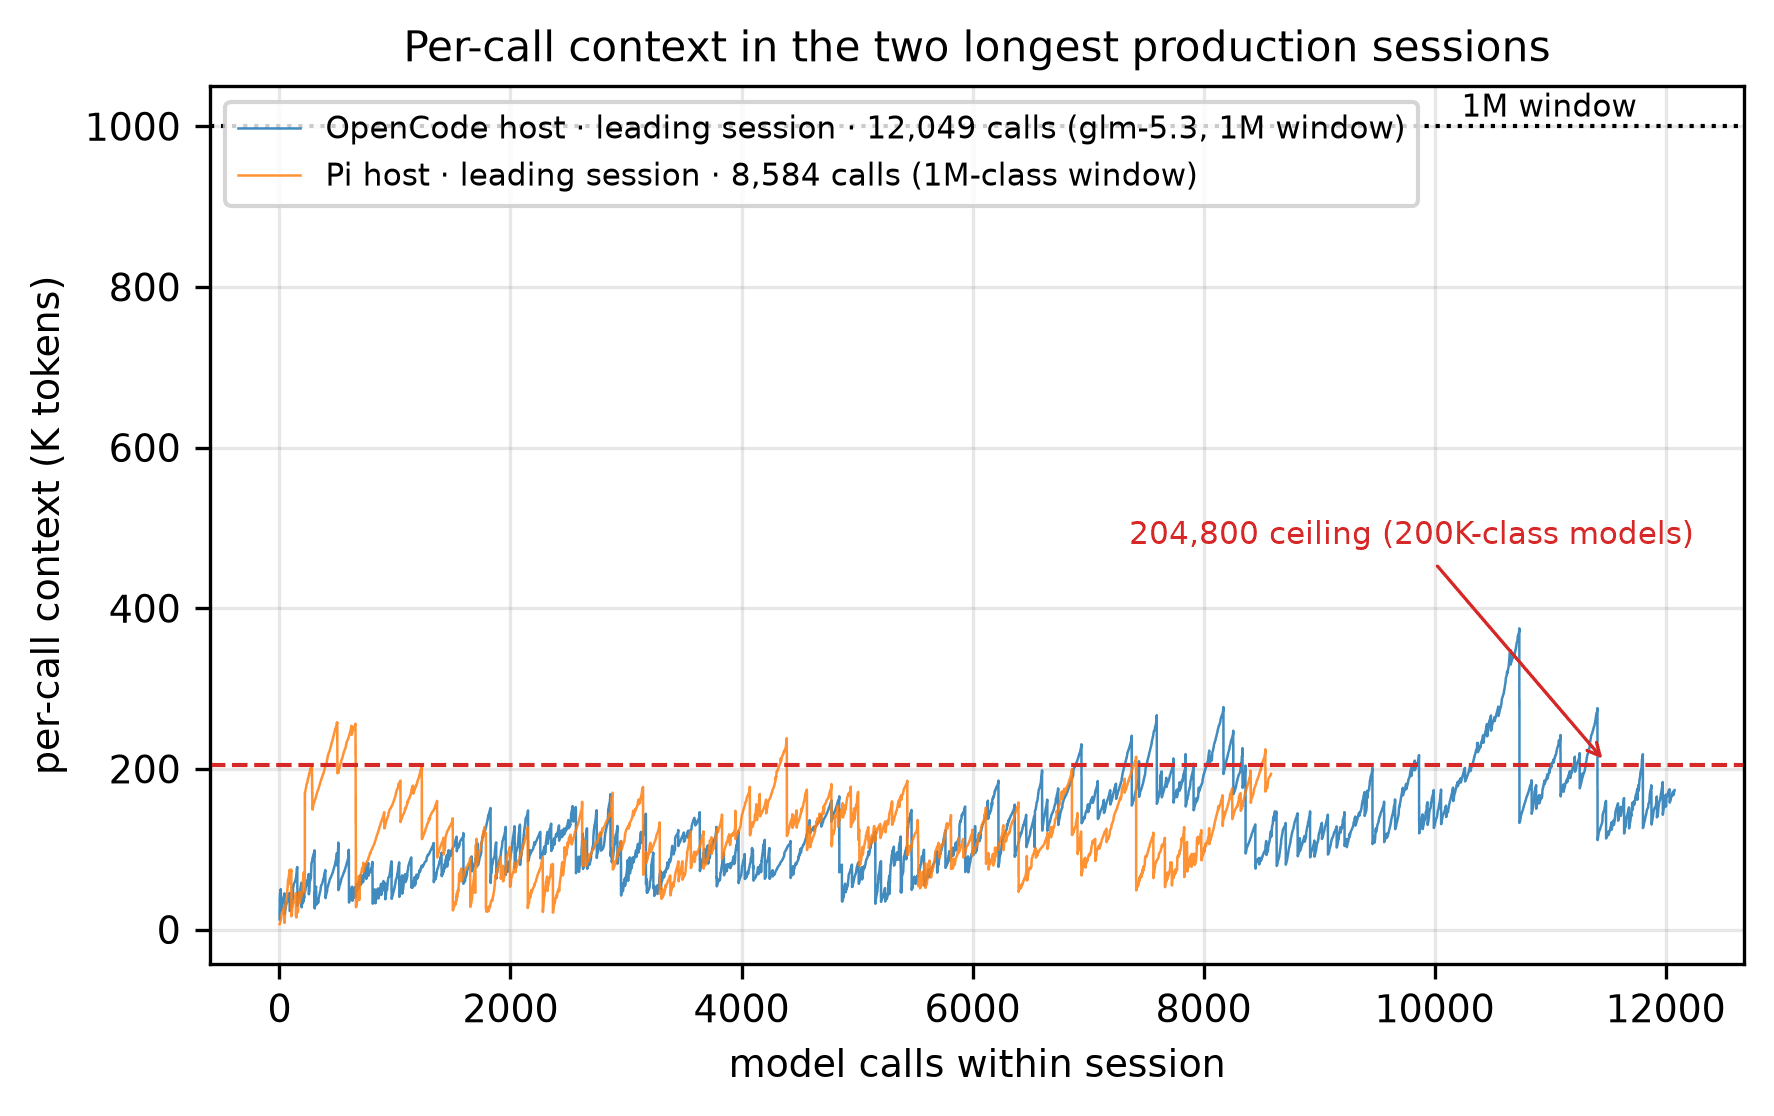
图 3:长跑会话轨迹——总上下文在有界区间内震荡,而非单调膨胀
这是一个 TypeScript / Node.js monorepo,仓库共 1951 个文件:
src/(275 文件):代理主体。src/server/ 处理 Anthropic / OpenAI / Google / Responses 四种协议形态的请求准备与转发,src/loop/ 是协议适配核心(cache-control、tag-echo-filter),src/agent/ 是各客户端的原生接入实现(dsh-native、opencode-native、pi-native、omp-native 等),src/web/ 是诊断面板,另有 src/storage/、src/marker/、src/kimi/、src/zcode/ 等细分模块。kernel/(245 文件):名为 acp-kernel 的独立压缩内核,含 compress.ts、decompress.ts、compress-tools.ts、content-store.ts、persist/、panel/、filter/ 等。pi-subagents/(43 文件):pi 客户端的内置子代理。tests/(1061 个文件):包含 1212 个测试文件,单元测试与 e2e 齐全,还带测试套件锁(test-suite-lock)机制。paper/:预印本论文《Model-Driven Incremental Hierarchical Compression: Training-Free Multi-Generational Context Management for Long-Lived Coding Agents》,中英双语,MIT 协议,标注了 [V] 已验证 / [A] 解析模拟 / [P] 计划实验三类证据等级。website/:文档站与配置参考(compress/diagnostics/env-only/process/providers/rollout/server/updates)。运行时依赖极轻:zod + mysql2(可选存储)+ ws + undici,开发侧用 tsup 构建、z3-solver 做形式化约束、node-forge 做证书 MITM。
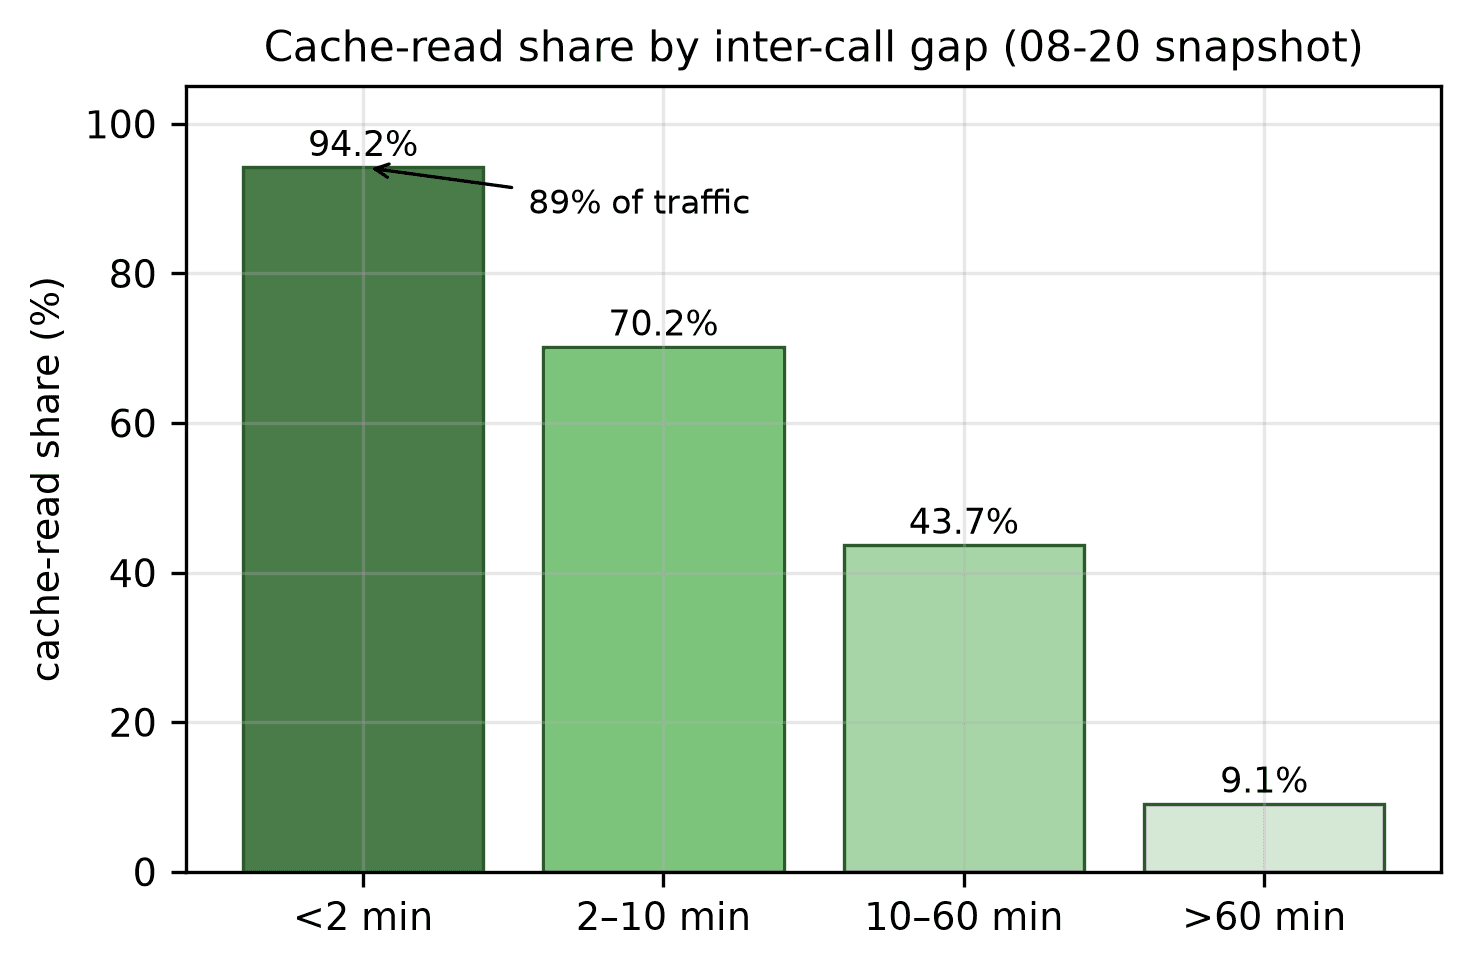
图 4:缓存分层——压缩在小范围内写入,前缀缓存保持完整
最低门槛路径(推荐):
npm install -g billion-context --prefix=~/.local
export PATH="$HOME/.local/bin:$PATH"
bili claude     # 或 bili pi / bili codex / bili opencode ...
只需要 Node.js 20+ 和一个 API Key,不需要 sudo、不改 npm 配置。
容器路径:仓库自带 Dockerfile(node:24-slim,暴露 8787,带 HEALTHCHECK),四个卷分别挂 config / data / cache / state:
docker build -t billion-context .
docker run -d --name bili -p 8787:8787 \
  -v bili-config:/root/.config/billion-context \
  -v bili-data:/root/.local/share/billion-context \
  -v bili-cache:/root/.cache/billion-context \
  -v bili-state:/root/.local/state/billion-context \
  billion-context
镜像内默认关闭自更新(ACP_AUTO_UPDATE=0),避免运行副本与镜像版本悄悄漂移。
Web 面板:代理自带诊断面板,可看缓存命中率、上下文用量、各区间可压缩状态,也提供 /acp、/acp-cache 斜杠命令做归因。
ANTHROPIC_BASE_URL,覆盖受管值,导致桌面会话完全绕过代理——既没有 BC 压缩,也没有原生自动压缩(因为 DISABLE_AUTO_COMPACT=1 仍然生效)。项目在 issue #2290 中跟踪,hook 会在会话开始时大声警告。bili doctor、斜杠命令和配置参考逐步上手。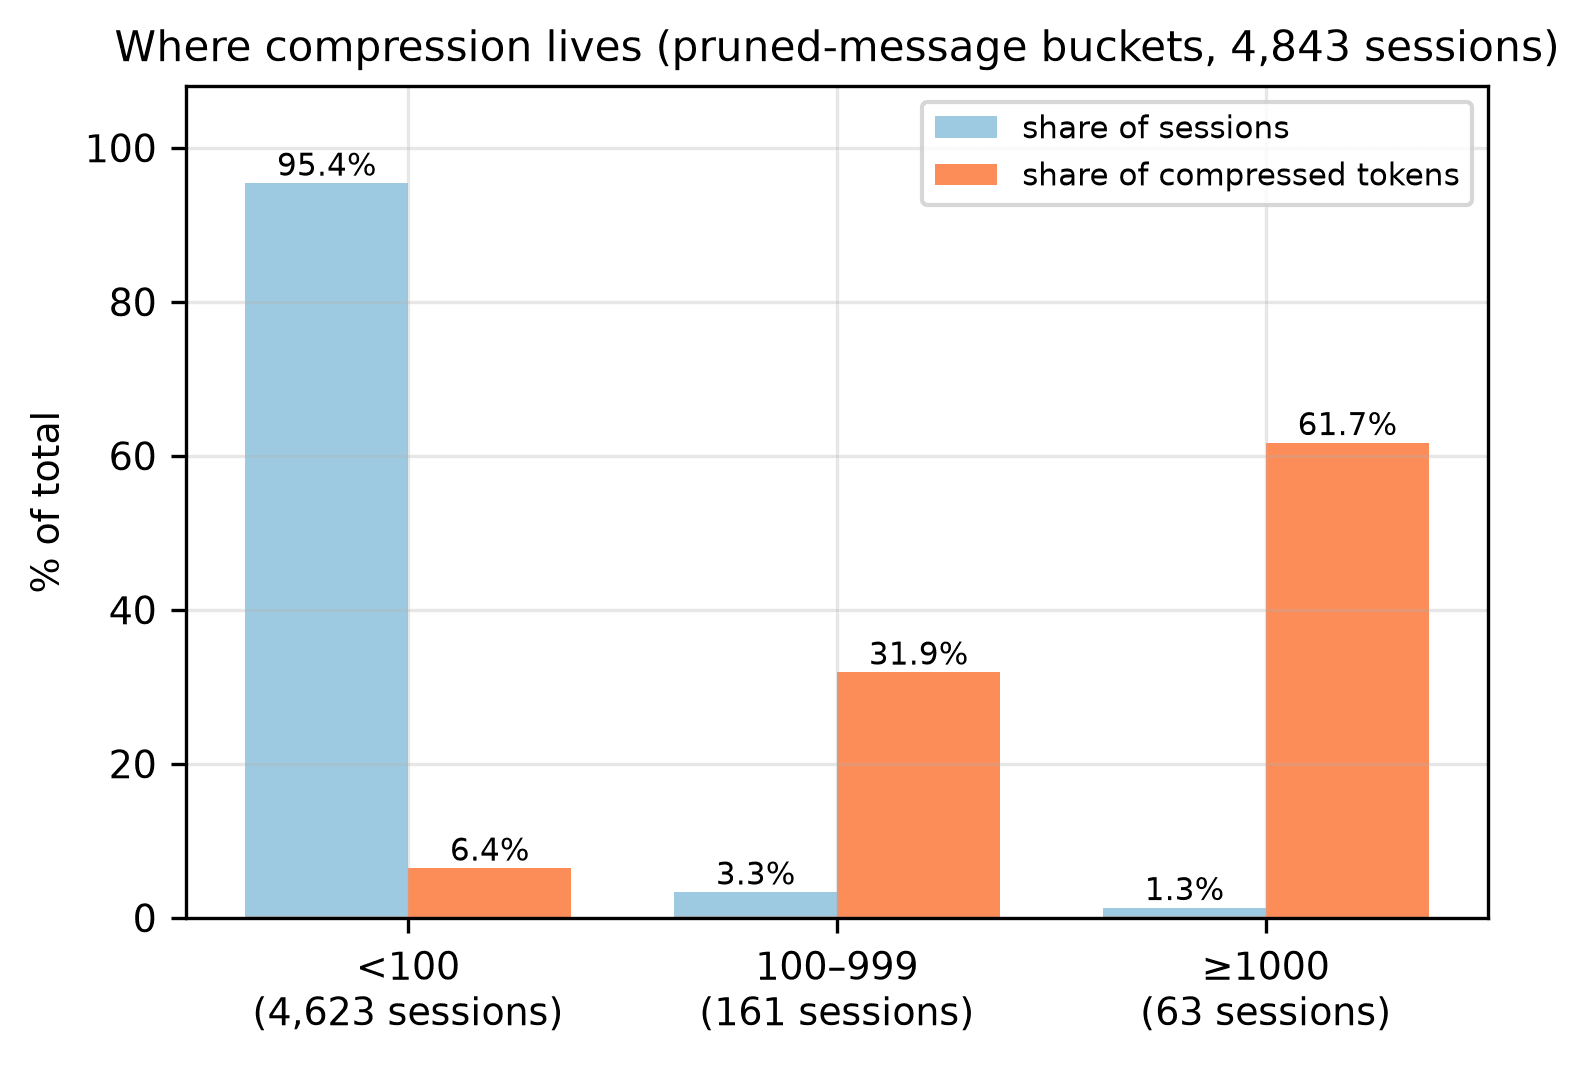
图 5:不同语料分桶下的压缩表现
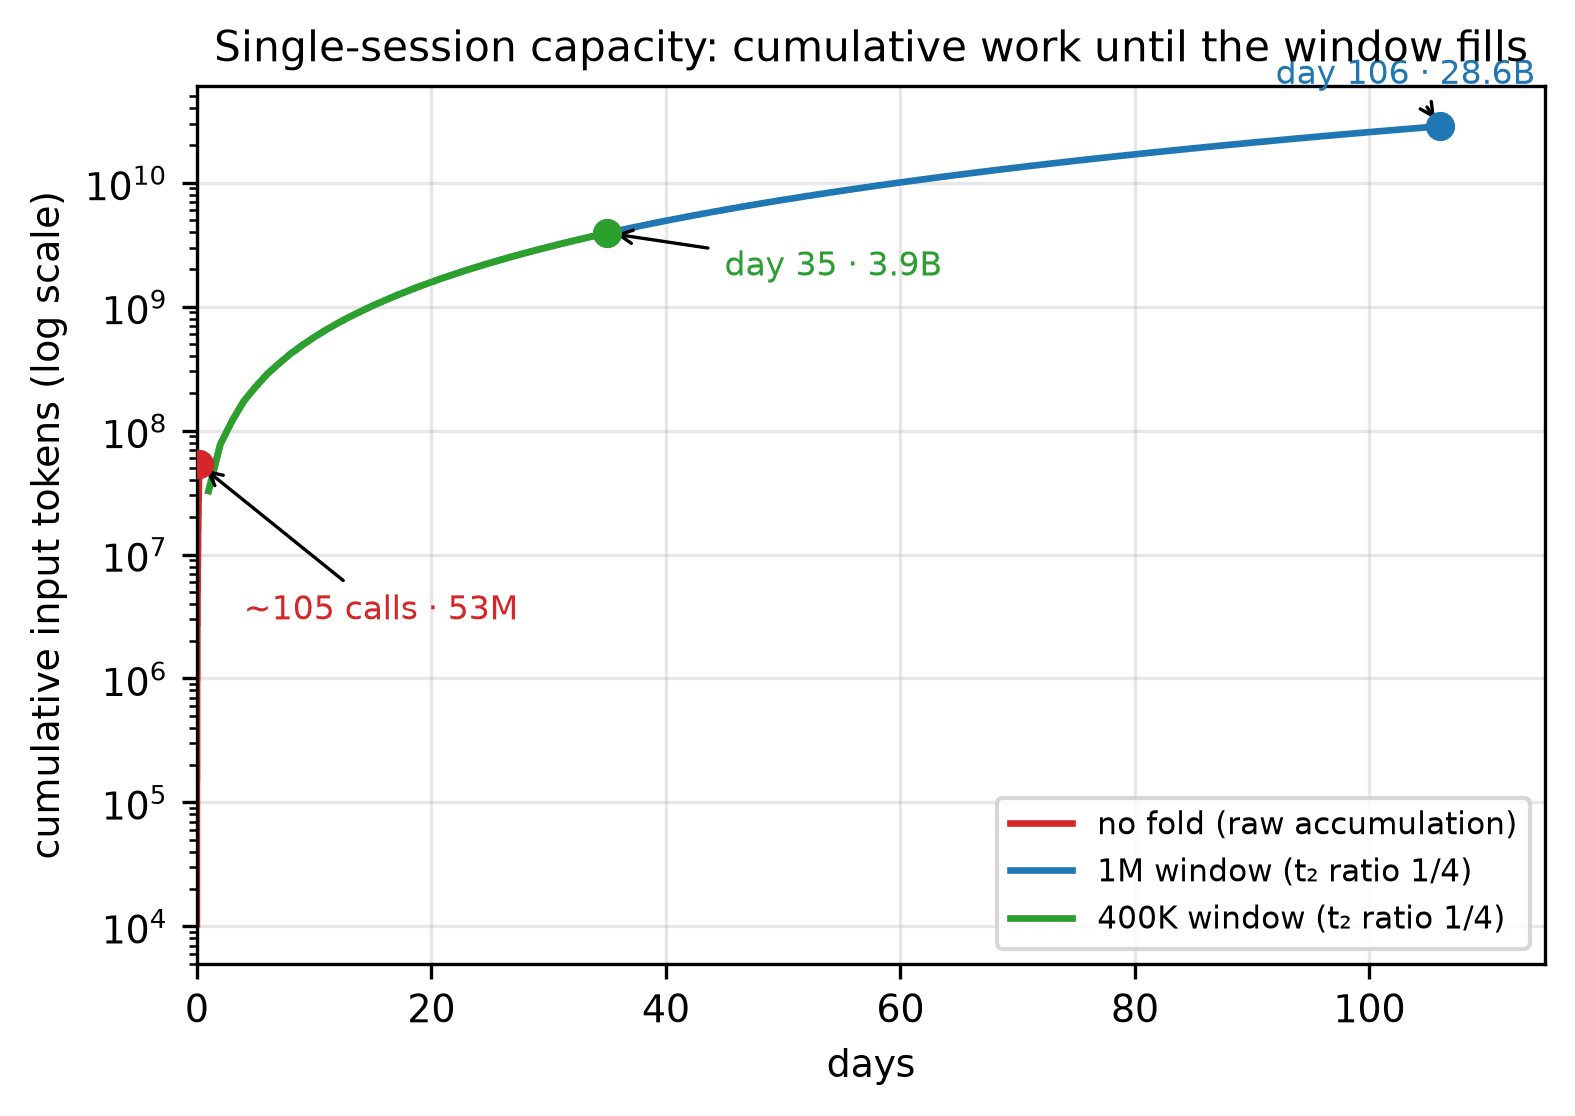
图 6:上下文容量模拟——固定窗口下的可用性推演
过去两年,「上下文工程」从边缘话题变成了 AI 编程工具的核心战场,行业大致分成三条路线:
BC 站在第三条路的最激进位置:不扩窗、不加检索基建、不训练模型,纯靠「模型自主折叠 + 可逆摘要」把上下文压进一个固定窗口,并用一条预印本论文和 6 张实验图把方法论讲清楚。项目同时给出 Claude Code、Codex、Gemini CLI、Kimi、Qwen Code、DeepSeek harness 等几乎所有主流编码 CLI 的接入方式。
更值得注意的是它附带的 acp-kernel 内核被单独抽出为独立仓库(Active Context Pruning),并给出了 DESIGN.md、SECURITY.md、PROVENANCE.md——这是一个「把核心能力开放出去,让社区围绕它长出生态」的做法。如果这个内核被更多客户端采用,BC 的价值就不只是省 token,而是给整个 Agent 生态提供了一套通用的上下文压缩协议。
它代表了一个明确的行业信号:在模型上下文窗口竞赛之外,另一条以「精细的上下文治理」取胜的路线正在成形。谁能把压缩做得可逆、可解释、缓存友好,谁就能在长会话场景里真正留住用户。
项目速览
| 项目 | 值 |
|---|---|
| 仓库 | github.com/ranxianglei/billion-context |
| Stars / Forks | 2669 / 222 |
| 主语言 | TypeScript(1497 个 .ts 文件) |
| 协议 | MIT + 产品出处标注附加条款 |
| 版本 | npm billion-context v0.1.206 |
| Node 要求 | >= 20 |
| 依赖 | zod、ws、undici、mysql2(可选) |
| 部署 | npm 全局安装 / 官方 Dockerfile(8787 端口) |
| 支持客户端 | 20+(pi、opencode、claude、codex、gemini、qwen、kimi、dsh、hermes、zed、goose 等) |
| 测试规模 | tests/ 1061 文件 / 1212 个测试文件 |
| 创建时间 | 2026-08-06 |
