
edge-veda
ramanujammv1988/edge-veda加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一个场景:你在地铁里没有信号,想让手机里的 AI 帮你分析一份刚拍下的体检报告——红细胞偏低、血糖略高、甲状腺指标需要注意。传统方案是调 API,但地铁没网。Edge-Veda 的作者 Ramanujan 也遇到了同样的困境:他在印度海得拉巴出差,手机信号时有时无,而他想让自己的 Flutter 应用在大模型时代真正"离线可用"。
于是他花了 8 个月,把 llama.cpp、whisper.cpp、stable-diffusion.cpp 三套推理引擎用 C 语言封装在一起,再用 Dart FFI 绑定到 Flutter,最终做出了一套能在真实 iPhone 上持续运行 28 分钟不崩溃的端侧 AI 运行时。
这就是 Edge-Veda——一款专为 Flutter 开发者设计的 on-device AI SDK,支持文本生成、视觉问答、语音识别、语音合成、图像生成、RAG 和函数调用,零云依赖,全部在苹果设备的 Metal GPU 上跑。
现代端侧 AI 演示有一个通病:Demo 看着惊艳,实机一跑就露馅。
Edge-Veda 的核心哲学是:Behavior over time——不只是跑得动,而是要跑得稳、跑得可观测、跑得可持续。
它通过三层机制来解决物理限制:
第一层:持久化 Worker 模型加载。 模型只加载一次,之后一直在内存里待命。对比每次推理都重新加载模型,内存峰值从 1200MB 降到 400-550MB,KV cache 从 64MB 压缩到 32MB。
第二层:运行时热管理策略。 iPhone 温度升高时,系统自动降级服务质量(降低帧率、缩小分辨率、减少 token 数量),而不是直接崩溃。温度恢复后,每 60 秒升一级,逐步回到满血状态,避免反复横跳。
第三层:计算预算合约。 开发者声明 p95 延迟、电池消耗、内存上限等约束,调度器自动执行。当设备无法满足约束时,优先丢弃新帧(drop-newest),而不是无限排队。
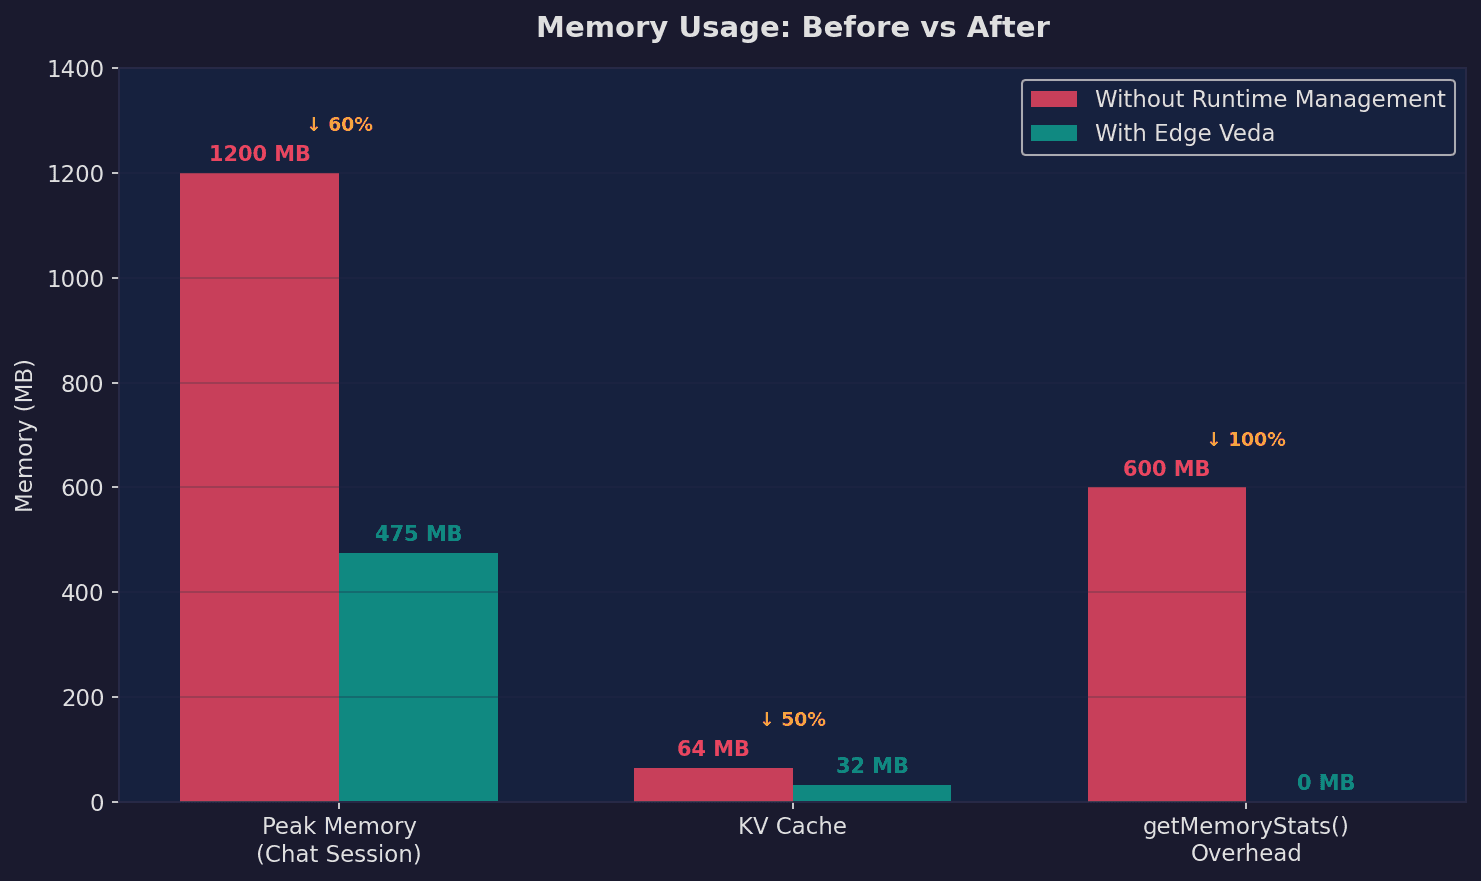 通过 Q8_0 量化,KV cache 从 64MB 降至 32MB,峰值内存从 1200MB 降至 400-550MB
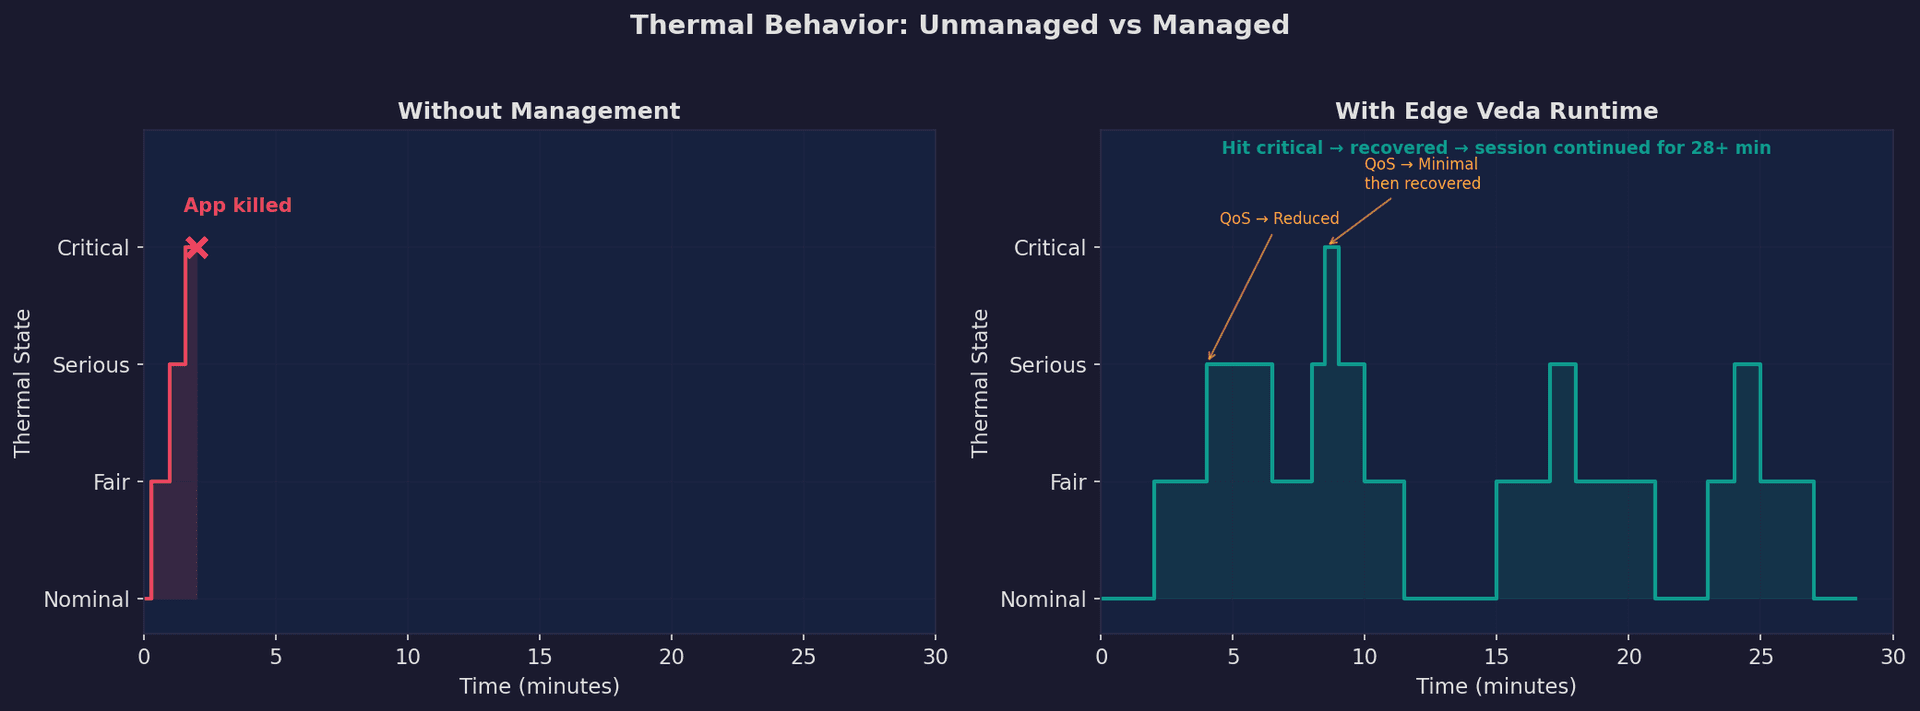 Edge-Veda 监控设备热状态,自动分 5 档调整服务质量
Edge-Veda 的架构有点像一个"三明治":
Flutter App (Dart)
    │
    ├── ChatSession ──── 多轮对话 + 工具调用
    ├── WhisperSession ── 流式语音识别
    ├── RagPipeline ───── 检索增强生成
    ├── VectorIndex ──── HNSW 向量检索
    │
    └── EdgeVeda ─────── generate() / embed() / describeImage()
           │
           ├── StreamingWorker ─── 持久化文本推理(Isolate)
           ├── VisionWorker ─────── 持久化视觉推理(Isolate)
           ├── WhisperWorker ────── 持久化语音推理(Isolate)
           ├── ImageWorker ──────── 持久化图像生成(Isolate)
           │
           └── FFI Bindings ─────── 50 个 C 函数
                  │
                  XCFramework (EdgeVedaCore.framework)
                  ├── engine.cpp ──── llama.cpp 封装(文本+Embeddings)
                  ├── vision_engine.cpp ─── libmtmd 封装(视觉)
                  ├── whisper_engine.cpp ── whisper.cpp 封装(STT)
                  └── image_engine.cpp ─── stable-diffusion.cpp 封装
底层用的是三个大名鼎鼎的开源项目:llama.cpp(GGML/GGUF 量化推理)、whisper.cpp(轻量级语音识别)、stable-diffusion.cpp(端侧图像生成),全部在 Metal GPU 上加速。Git submodule 直接引入,不改一行源码。
关键设计约束:Dart FFI 是同步调用,如果直接调 llama.cpp 会把 UI 线程卡死。所以所有推理都跑在独立的 Flutter Isolate 里,原生指针绝不跨越 Isolate 边界。这套模式解决了"模型常驻内存"和"UI 不卡顿"两个问题。
Edge-Veda 的 README 里塞了一份详细到令人发指的基准测试报告,全部在**物理 iPhone(A16 Bionic,6GB RAM,iOS 26.2.1)**上测的。
Llama 3.2 1B 模型,连续 10+ 轮对话无任何降级,吞吐量稳定在 42-43 tokens/s,内存占用 400-550MB。
whisper-tiny.en 模型(77MB),Metal GPU 加速,每段 3 秒音频块转写延迟约 670ms,实时流式输出。
SD v2.1 Turbo 模型(2.3GB),512×512、4 步(Euler A 采样器),约 14 秒生成一张图。闲置 60 秒后自动释放内存,释放后回收约 2.3GB。
向量检索(HNSW)单次查询 <1ms,端到端 RAG 延迟 305-865ms,生成速度 42-43 tok/s。文档问答全程离线。
SmolVLM2 模型,持续 28.6 分钟、572 帧,p95 延迟 2283ms,0 次崩溃、0 次模型重载。这在端侧 AI 领域是相当罕见的长稳记录。
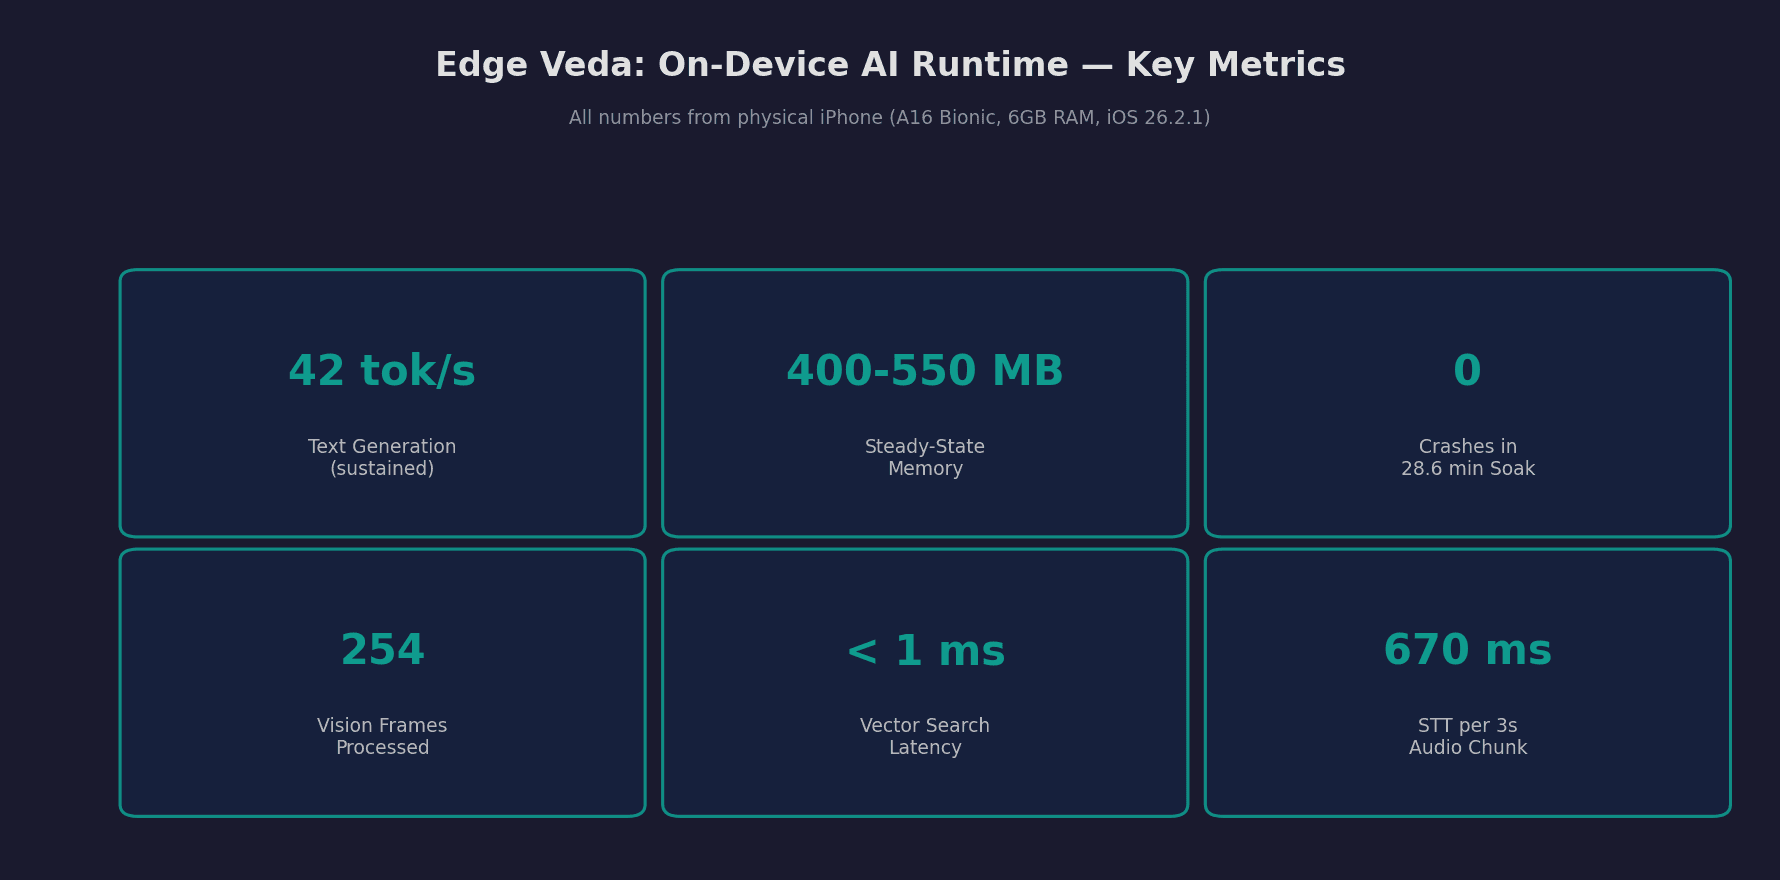 iPhone A16 真机实测:文本生成、语音识别、图像生成、RAG、视觉问答全覆盖
Edge-Veda 官方标榜"3 行代码上手":
final edgeVeda = EdgeVeda();
await edgeVeda.init(EdgeVedaConfig(modelPath: modelPath));
final response = await edgeVeda.generate('Explain quantum computing');
但实际工程路径要复杂得多。官方给出了一张"从零到跑起来"的时间表:
| 开发者类型 | 借助 MCP 插件 | 手动配置 |
|---|---|---|
| Flutter 开发者(已有 Xcode) | ~2 分钟 | ~15 分钟 |
| 其他栈开发者(无 Flutter) | ~30 分钟 | ~1 小时 |
| 纯新手(无任何开发工具) | ~1-3 小时 | ~1 天 |
新手的主要瓶颈不是 Edge-Veda 本身,而是 Apple 工具链:Xcode 是 10GB 下载,Developer Mode 需要重启设备,代码签名需要 Apple ID。好消息是,官方提供了 Claude Code MCP 插件,用自然语言就能自动完成环境检查、项目脚手架、模型选择和设备部署。
Edge-Veda 仓库里内置了 4 个完整可运行的 Flutter App:
意图引擎(Intent Engine):用 Qwen3 0.6B 做自然语言解析,"我要睡觉了" 自动关灯、锁门、关电视。10 个虚拟设备、3 个房间,支持 Home Assistant 对接。核心用到 ChatSession.sendWithTools() 函数调用能力。
文档问答(Document QA):加载任意 PDF 或文本文件,问问题——RAG 检索 + LLM 生成,100% 离线。双模型架构(Embedder + Generator),流式输出带来源标注。
健康顾问(Health Advisor):在文档问答基础上加了置信度感知——每个 token 输出时计算 softmax 熵作为置信度,颜色标签(绿/黄/红)实时显示,置信度低于阈值时弹出"建议咨询专业医生"提示。这是真正把 AI"知道自己不知道"产品化的案例。
语音日记(Voice Journal):录想法 → 自动转写 → 自动摘要 → 语义搜索,全流程本地。三个独立模型实例(STT + 摘要 + Embeddings),SQLite 持久化,跨 session 语义检索。
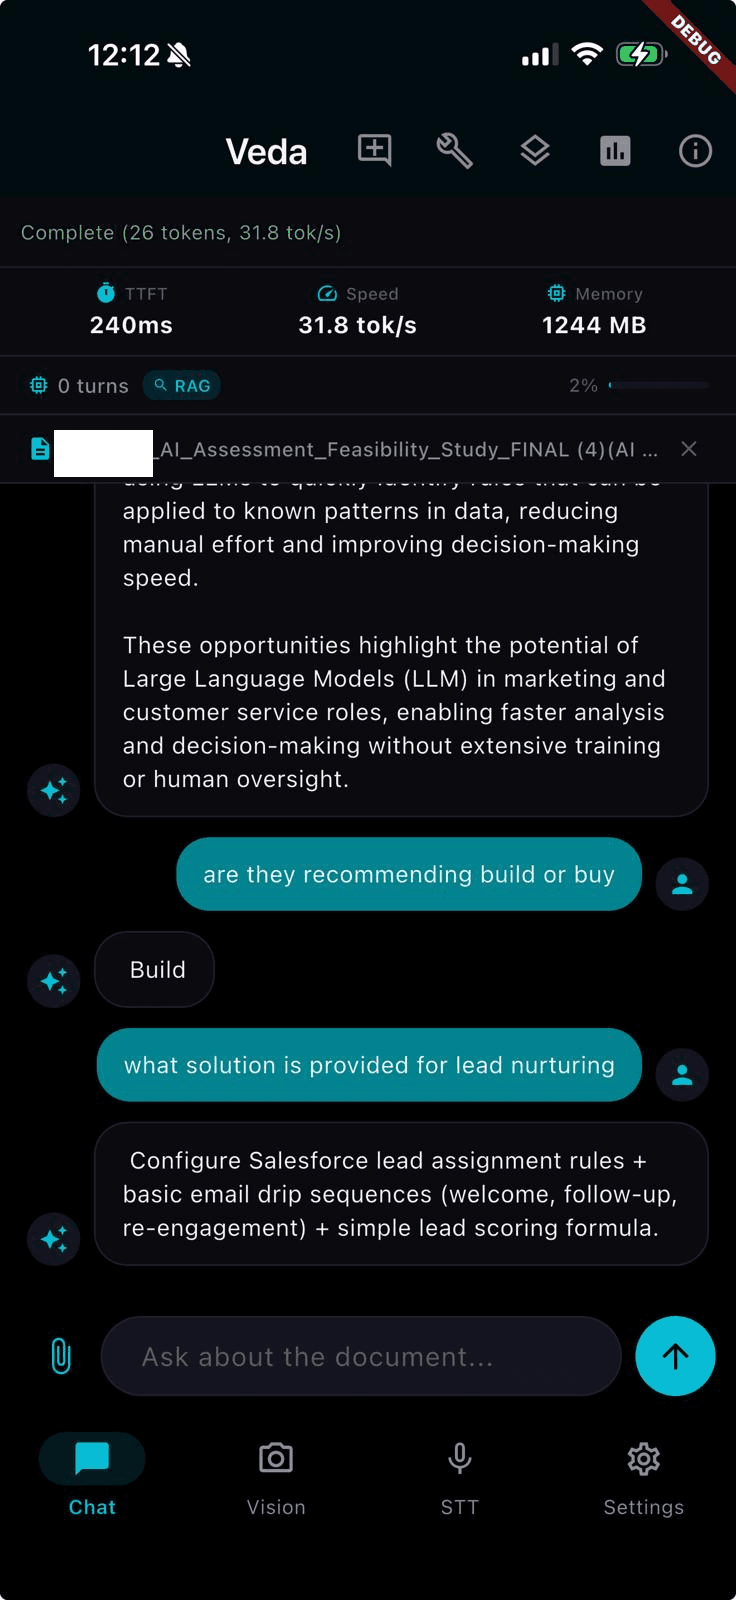 PDF文档问答:RAG检索 + LLM生成,305-865ms端到端延迟
平台限制是最大的现实障碍。 目前仅 iOS/macOS 验证充分,Android 支持在路线图上,Vulkan GPU 加速还在规划中。如果你的目标用户是 Android 群体,这个项目暂时帮不了你。
模型适配需要经验。 llama.cpp 支持所有 GGUF 模型,但用错 ChatTemplateFormat 会导致输出乱码。文档给出了详细的模型-模板对照表,新手容易在这里踩坑。
Metal GPU 是苹果专属护城河。 这是优势也是限制——如果你想服务跨平台用户,需要维护多套后端。代码里 Android plugin 已经搭了脚手架(flutter/android/),但验证还不充分。
构建门槛不低。 虽然 Flutter 集成只需 3 行代码,但编译 XCFramework 需要 macOS + Xcode 15+ + CMake 3.21+,CI/CD 流水线需要搞定 Apple 开发者证书。对于习惯了 docker build 一键部署的工程师来说,这套流程需要适应。
Edge-Veda 最有意思的地方不是"能跑模型",而是它对稳态运行的思考。
大多数端侧 AI 项目关注的是"能不能跑起来"(Benchmark 冲刺),Edge-Veda 关注的是"能不能一直跑"(Soak Test 验证)。28 分钟不崩溃、0 次模型重载、KV cache 量化压缩——这些数字背后是对实际用户场景的深刻理解:用户不会只用 30 秒,他们需要的是"放在口袋里随时能用"的 AI 助手。
从技术选型看,Flutter + C + Metal 的组合也值得关注。它绕过了 CoreML 的封闭生态,直接用 FFI 调用 llama.cpp,在苹果生态里实现了真正的跨模型通用推理。这种"不绑定平台 AI 能力、自己掌控推理层"的思路,可能会是未来端侧 AI 的主流路径之一。
一句话总结:Edge-Veda 把 llama.cpp/whipser.cpp/stable-diffusion.cpp 三套引擎用 C FFI 封装成 Flutter 插件,让 iOS 开发者能在手机上跑起 42 tok/s 的 LLM 推理、语音识别、图像生成和 RAG,核心差异化在于运行时热管理 + 计算预算合约 + 持久化 Worker 架构,解决了"Demo 能跑但真机活不久"的端侧 AI 老大难问题。
