
knowledge_graph
rahulnyk/knowledge_graph加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:你刚读完一篇 30 页的学术论文,脑海里充满了零散的概念——"强化学习""策略梯度""奖励函数"——但它们之间的关系模糊不清,你无法在脑中勾勒出完整的知识网络。传统做法是再读一遍画思维导图,但有没有更聪明的方式?
开发者 rahulnyk 就遇到了同样的困扰。他的解决方案是:让 LLM 替我读书,自己建图谱。
这个名为 knowledge_graph 的项目,核心思想非常朴素——给定任意文本语料(PDF、网页、Notion 文档皆可),用本地运行的 LLM(默认 Mistral 7B OpenOrca)自动从中提取概念节点与关系边,最终生成一个可直接可视化的知识网络图。
这个思路在 RAG(检索增强生成)浪潮中显得格外有预见性。当业界普遍使用向量数据库作为检索器时,rahulnyk 选择了一条更"图"的路:Graph Retrieval Augmented Generation(GRAG)——用知识图谱代替向量数据库作为检索层。
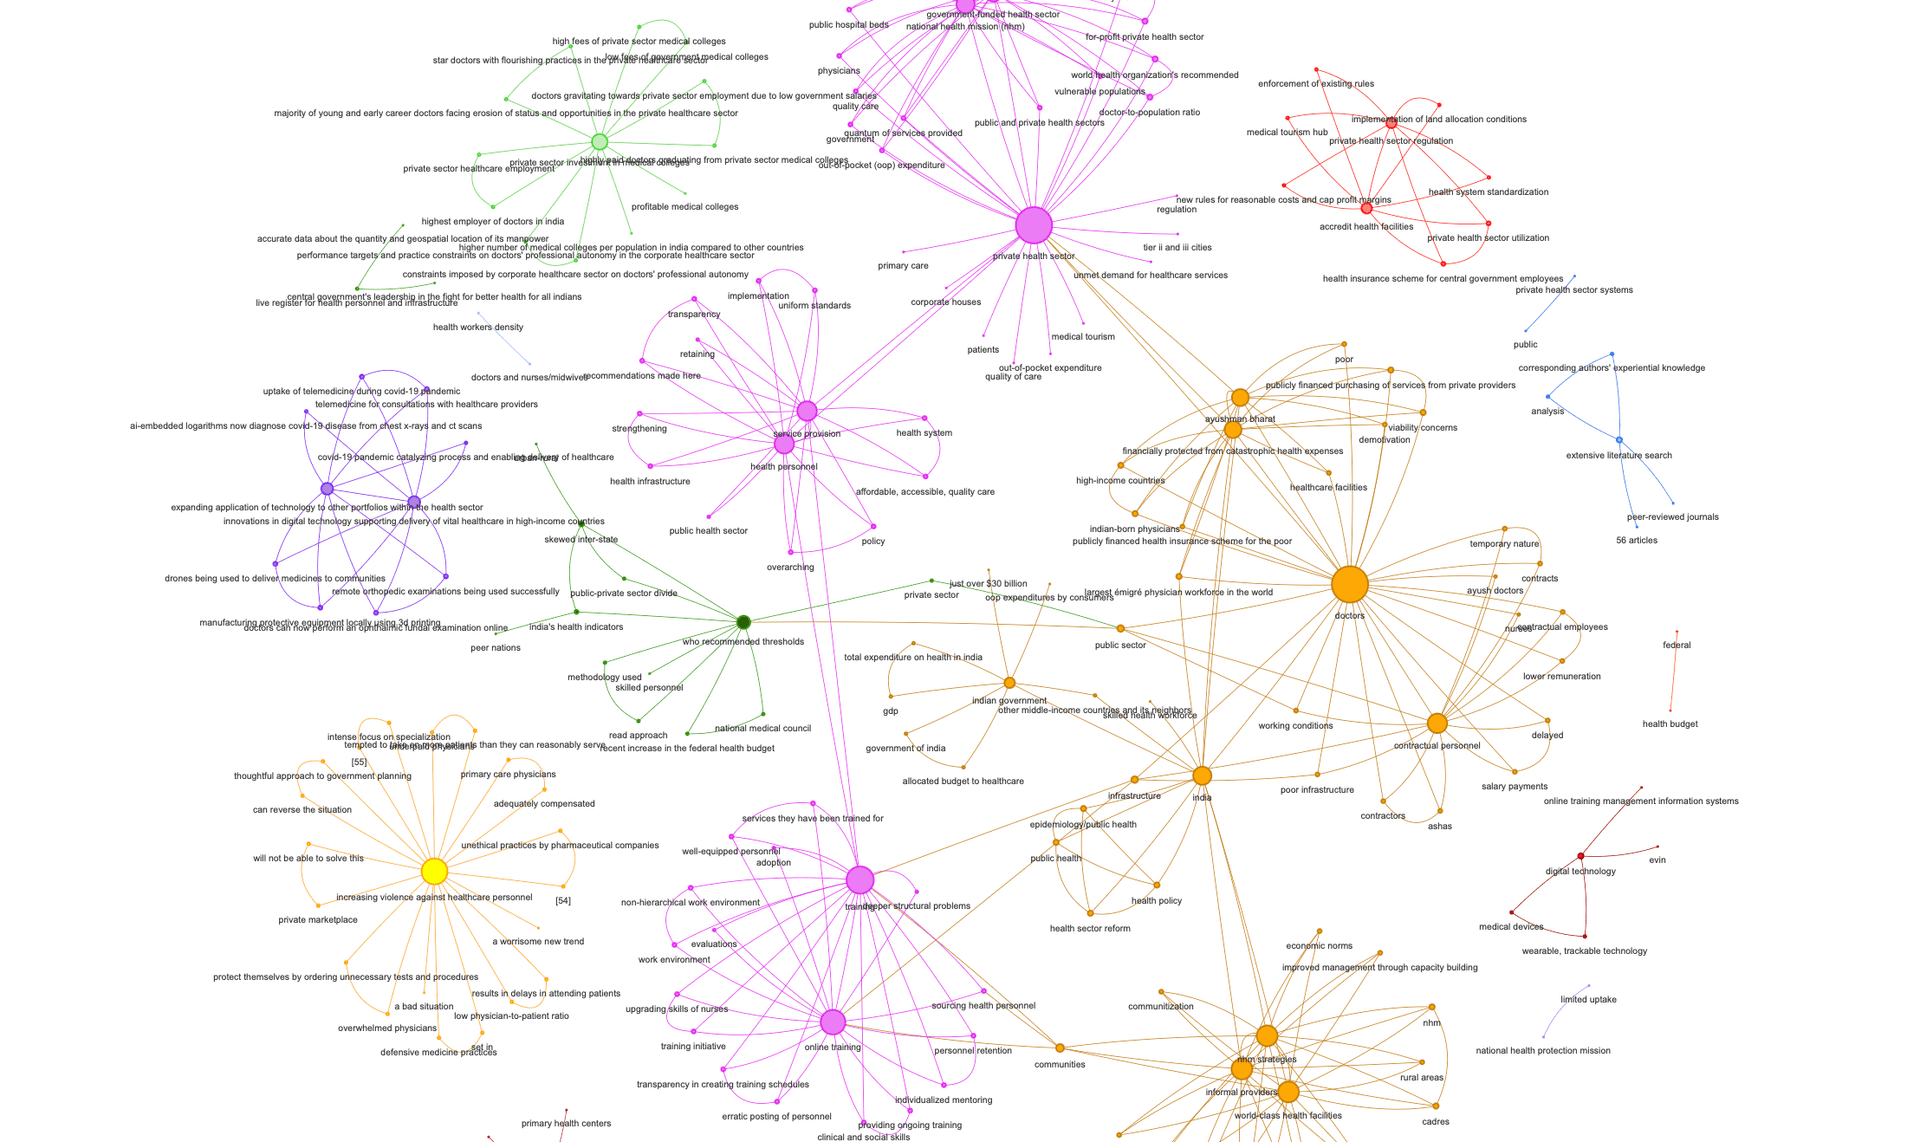 项目生成的知识图谱可视化效果,节点代表概念,边代表共现关系
项目的处理流程分为五个清晰阶段:
阶段 1:文档解析与分块(Text → Chunks)
使用 langchain + unstructured 库读取 PDF、文本文件,将长文档切分为小段落(chunks),每个 chunk 带元数据(来源文件、页码等)。这一步直接影响后续抽取质量——chunk 太大则实体模糊,太小则关系断裂。
阶段 2:概念抽取(Chunks → Concepts) 每个 chunk 送入本地 Ollama LLM(Mistral 7B),通过精心设计的系统提示词(System Prompt)要求模型以 JSON 格式输出"原子级概念"列表。每个概念节点包含:实体名称、重要性评分(1-5)、分类标签(event/concept/place/object/document/organisation/condition/misc)。
这是整个流程中最关键的一步——LLM 的 prompt 工程质量直接决定了概念抽取的完整性与准确性。
阶段 3:关系抽取(Chunks → Relations)
同一套 prompt 体系,还有一个专门的 graphPrompt 函数,专门提取概念之间的语义关系。例如输入一段关于"Transformer 注意力机制"文本,模型会输出 (attention, relates_to, self-attention)、(transformer, uses, attention) 这样的三元组。
阶段 4:图谱构建(Concepts + Relations → Graph) 将所有节点和边汇聚为 NetworkX 图对象。NetworkX 是 Python 图论标准库,支持计算节点中心性(PageRank、Degree、Betweenness)、社区检测(Louvain 算法)等高级图分析操作。
阶段 5:可视化与查询(Graph → pyvis HTML)
用 pyvis 将 NetworkX 图导出为交互式 HTML 文件,支持缩放、拖拽、点击查看节点详情。项目还提供了 GitHub Pages 托管的在线可视化示例。
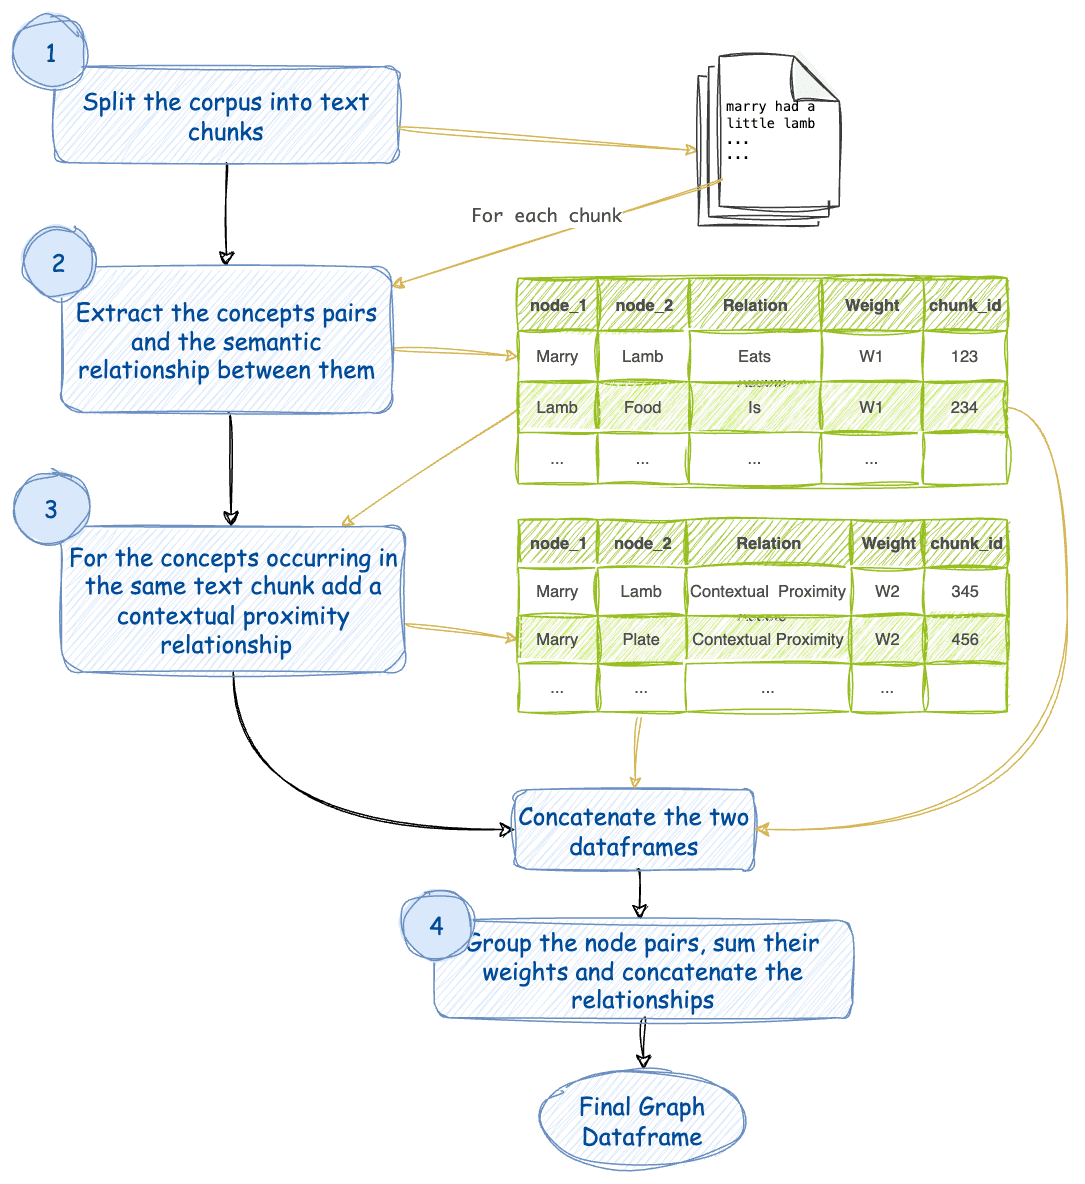 从文本到知识图谱的五阶段处理流程
传统 RAG 使用向量相似度匹配(embedding similarity)来检索相关文本片段,优点是速度快、实现简单,但有一个根本性缺陷:丢失了语义关系。
知识图谱检索则完全不同。给定查询"注意力机制的原理",GRAG 会在图谱中定位 attention 节点,然后通过图遍历找到所有与之直接或间接相连的概念——不仅仅是字面上包含"attention"的文本,更是"self-attention"、"multi-head attention"、"scaled dot-product" 等构成完整理解的知识网络。
这种"关系优先"的检索方式,在以下场景中优势明显:
项目支持两种环境管理工具:
pyproject.toml 定义了完整依赖environment.yml 覆盖主要科学计算包核心依赖包括:langchain(文档处理)、pandas/numpy(数据处理)、networkx(图构建)、pyvis(可视化)、unstructured(PDF 解析)。
项目默认使用 Mistral 7B OpenOrca 模型,通过 Ollama 在本地运行,无需 OpenAI API key,不产生云端费用,也保障了数据隐私。
安装 Ollama:
# macOS/Linux
curl -fsSL https://ollama.com/install.sh | sh

# 下载模型
ollama pull mistral-openorca:latest

# 验证
ollama run mistral-openorca:latest "Hello"
项目提供了 Dockerfile,基于 python:3.11-slim,包含 Poetry 依赖安装,但容器内不会自动安装 Ollama——Ollama 需要与 Docker 一起作为宿主机服务运行。
docker build -t knowledge-graph .
docker run -p 8888:8888 knowledge-graph
# 访问 http://localhost:8888 打开 JupyterLab
http://localhost:11434,确保 Ollama 服务已启动尽管概念令人兴奋,这个项目也有明显的适用边界:
LLM 调用成本:每个 chunk 都需要一次 LLM 调用,处理长文档(如整本书)会产生大量调用。使用本地 Ollama 零边际成本,但 Mistral 7B 的推理速度决定了处理效率。
无 Web UI:所有交互通过 Jupyter Notebook 进行,对非技术用户有一定门槛。项目未提供 Gradio/Streamlit 等开箱即用的 Web 界面。
概念抽取质量依赖 prompt:默认 prompt 是英文设计,中文文本处理需要针对性调整,否则抽取的概念质量和分类准确性会明显下降。
自 2023 年开源以来,该项目在 GitHub 收获 4000+ stars,进入了众多 AI/LLM 学习者的视野。在 LLM + Knowledge Graph 这个交叉领域,它以"简单够用"的实现证明了:不需要复杂的图数据库,一条 NetworkX + Ollama 就能做出可用的知识图谱。
这个方向正在获得更多关注。随着 LLM 推理成本下降和本地部署工具链成熟,GRAG 很可能成为 RAG 的重要补充——尤其是需要深层关系推理的场景。
