
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
先算一笔账。用 Adam 做全量微调,30 亿参数的模型需要同时容纳:参数本身、梯度、优化器的一阶与二阶动量,还不包括激活值。换算下来,一张 24G 的消费级显卡连 70 亿模型都放不下,更别提 300 亿。这道显存墙,把大量想"自己微调大模型"的团队挡在了门外。
普林斯顿团队的 MeZO 用一个反直觉的办法绕了过去:只做前向传播,就能微调模型。
它的数学基础是零阶优化——不去精确求梯度,而是通过比较参数轻微扰动前后的损失差异,反推出梯度的方向。这个过程完全不需要存储反向传播的中间量,于是省掉了梯度和优化器状态这两大块开销。
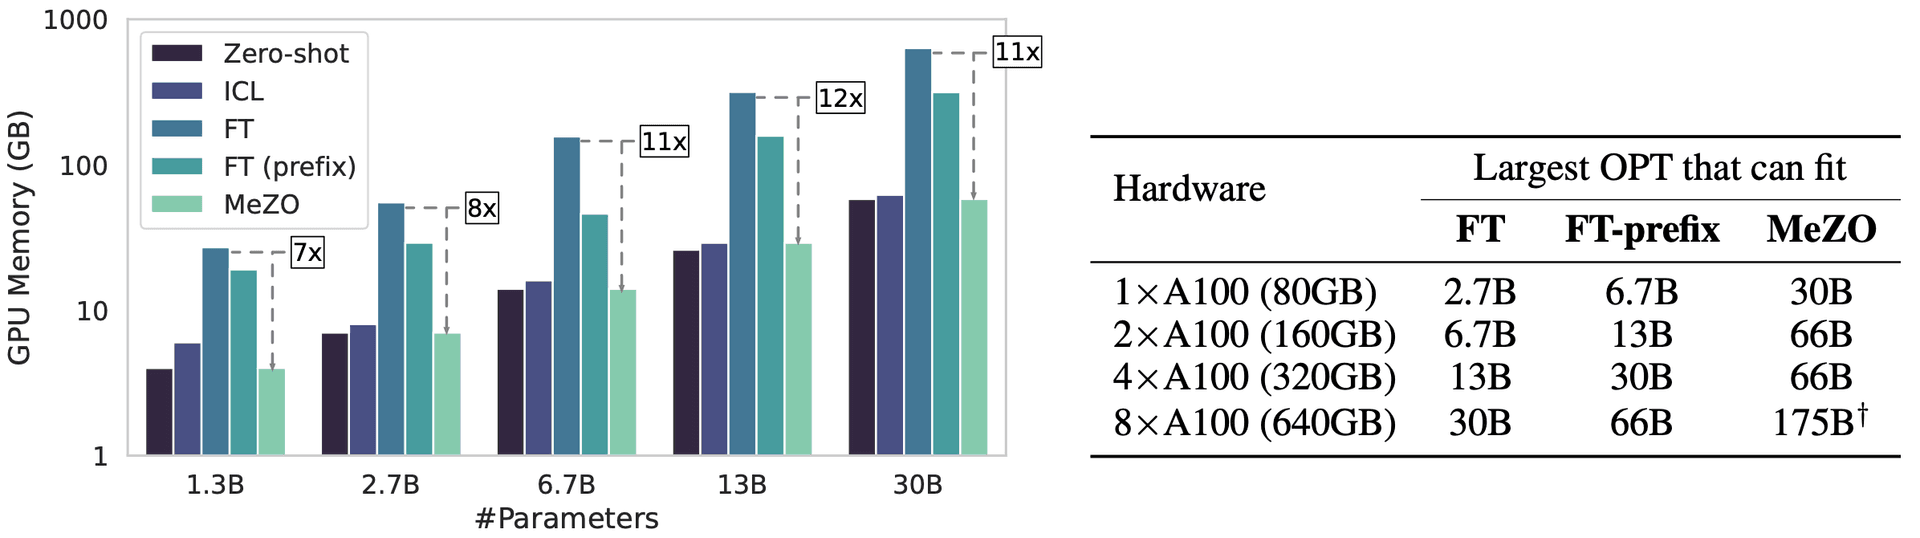
MeZO 与零样本/ICL/全量微调的显存占用对比
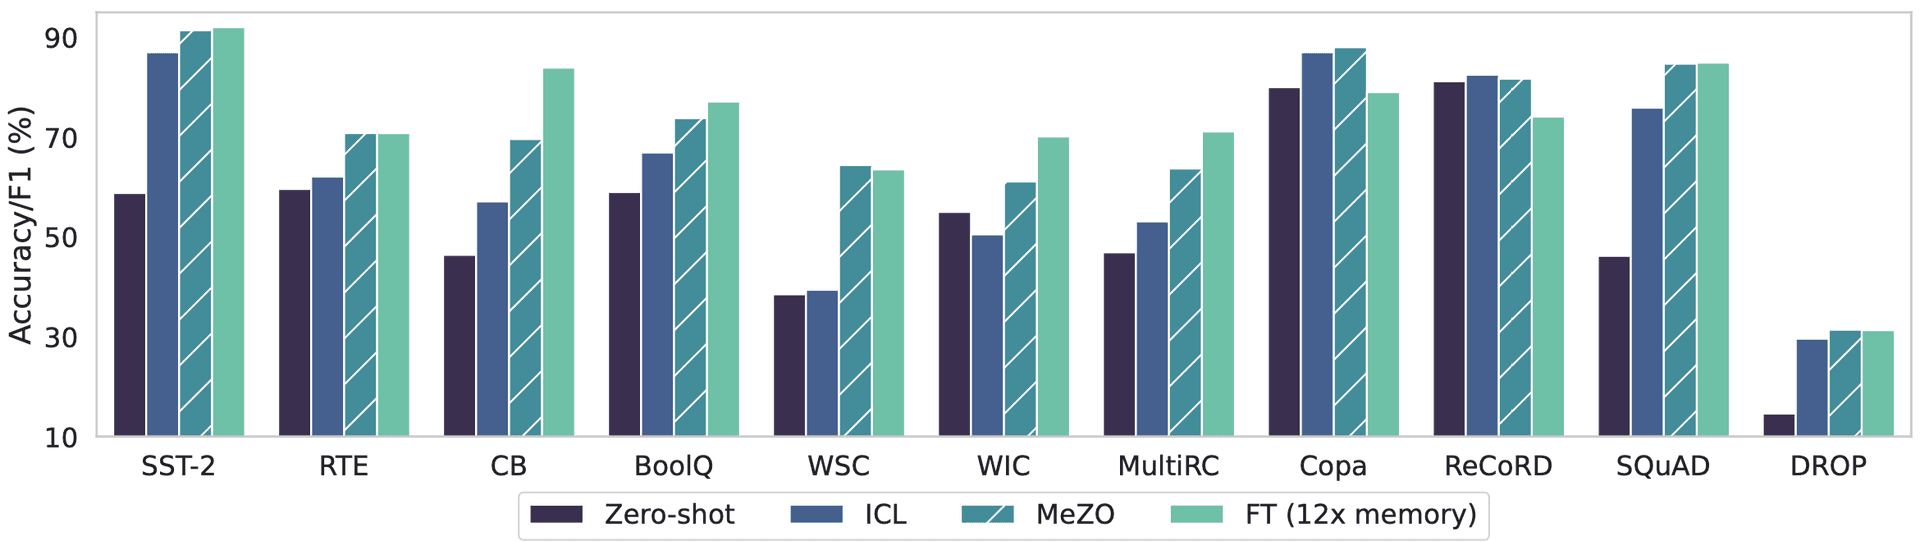
OPT-13B 上各微调方法的效果对比
论文给出的数字相当有冲击力:在十一个标准任务上,其中七个任务的效果与全量 Adam 微调相差不到 1%,而显存占用只有全量微调的十二分之一。这意味着原本需要多卡集群的微调任务,可能被压进单张 A100 甚至更小的卡里。
MeZO 发表于 NeurIPS 2023,作者来自普林斯顿 NLP 实验室(Sadhika Malladi、Tianyu Gao 等)。它的实现方式非常克制——基于 HuggingFace Trainer 做最小侵入式扩展,而不是另建一套训练框架。这一点对工程落地很重要:Trainer 里的日志、调度、混合精度、FSDP、DeepSpeed 等基础设施全部可以沿用,MeZO 只替换了梯度估计这一环。
仓库分成两个目录,面向两种模型规模:
large_models/:自回归大模型(OPT 系列),实现更完整,代码可读性也更好,是理解 MeZO 工作原理的首选入口medium_models/:RoBERTa 等中型模型,训练更快、变体更多,适合快速实验四种对照方案在同一套代码下实现,让比较变得公平:
mezo.sh — 纯 MeZO 零阶微调mezo.sh 配合 LoRA 变体(lora.py)— 零阶 + 低秩适配prefix.py — 零阶 + 前缀微调finetune.sh — 传统 Adam 全量微调,作为对照基线icl.sh — 上下文学习(In-context Learning)基线实现的关键改动集中在 trainer.py:把标准反传换成"参数扰动 → 前向 → 损失差分 → 恢复参数"的循环。tasks.py 负责数据集与提示模板,metrics.py 负责评测口径。
显存对比图(上图第二张)是这个项目最有说服力的部分:零阶微调在 OPT-13B 上的显存占用与上下文学习相当,远低于 Adam 全量微调;而在效果对比图上,MeZO 的成绩全面超过零样本与上下文学习,与全量微调基本持平。
门槛在硬件而非代码。large_models/ 建议 OPT-30B 及以上使用 A100/A6000 级别 48GB 显存,13B 可放宽到 24GB。启动方式是通过 shell 脚本传参:
bash large_models/mezo.sh --task sst2 --model facebook/opt-13b --num_epochs 3
需要自己准备 GPU 环境、装好 transformers 与 bitsandbytes、下载数据集(medium_models/data/download_dataset.sh 提供脚本)。没有 Dockerfile、没有 compose、没有 Web UI,这是一个纯粹的研究代码仓库。
需要清醒认识四点。
第一,正确性验证依赖实验复现而非测试。仓库里没有单元测试,也没有任何 CI 流水线。唯一的"验证"是论文表格能否重现。这在学术研究语境下可以接受,但工程团队直接引入时缺少回归保障。
第二,项目已停止活跃更新。最后一次代码推送在 2024 年 1 月,之后主要是 issue 讨论。它依赖 transformers 的 Trainer 内部接口——而 Trainer 这些年重构过多次,强行在新版本上跑通需要改代码。
第三,安装依赖未锁版本。pip install -r requirements.txt 会拉最新版本,常见结果是 transformers 升级后 Trainer 接口变化导致直接报错。实践中应当主动固定版本。
第四,方法本身有适用范围。零阶优化每步需要多次前向,单步计算量比反向传播高,实际墙钟时间往往长于全量微调,节省的是显存而非时间。如果你的瓶颈是显存,MeZO 是答案;如果瓶颈是吞吐,应该考虑 LoRA 或 QLoRA。
MeZO 改变了"显存"在微调决策中的权重。在它之后,QLoRA 把这条路线推到了消费级硬件,LoRA 成为事实上的默认选择,PEFT 生态也因这篇论文的推动而加速成熟。它证明了:在很多下游任务上,你并不需要更新模型全部参数就能拿到接近全量微调的效果——这个认知比任何单点技巧都更重要。
今天的微调实践中,直接用 QLoRA 往往是更省事的选择。但如果你需要理解零阶优化的实现思路,或者要在超大规模模型上把显存压到极限,MeZO 依然是最直接的参考实现。
