
vecdb-python-sdk
oracle/vecdb-python-sdk加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下:你维护着 Oracle 数据库里数以亿计的客户记录,产品部门突然提出需求——找出所有与家庭喜剧电影语义相关的记录。传统方案需要人工给每条记录打标签,再写 SQL LIKE 模糊匹配——既慢又不准。而向量数据库告诉你:把文本转成数学向量,用余弦相似度一算,答案秒出。
Oracle VecDB Python SDK(oracle-vecdb) 正是 Oracle 给出的答案。它让你在已有的 Oracle AI Database(Oracle Database 23ai+)上,直接获得向量检索能力,而不必引入 Redis Vector、Pinecone 等独立的向量数据库。
本项目由 Oracle 官方维护,遵循 UPL-1.0 开源协议,托管于 GitHub。
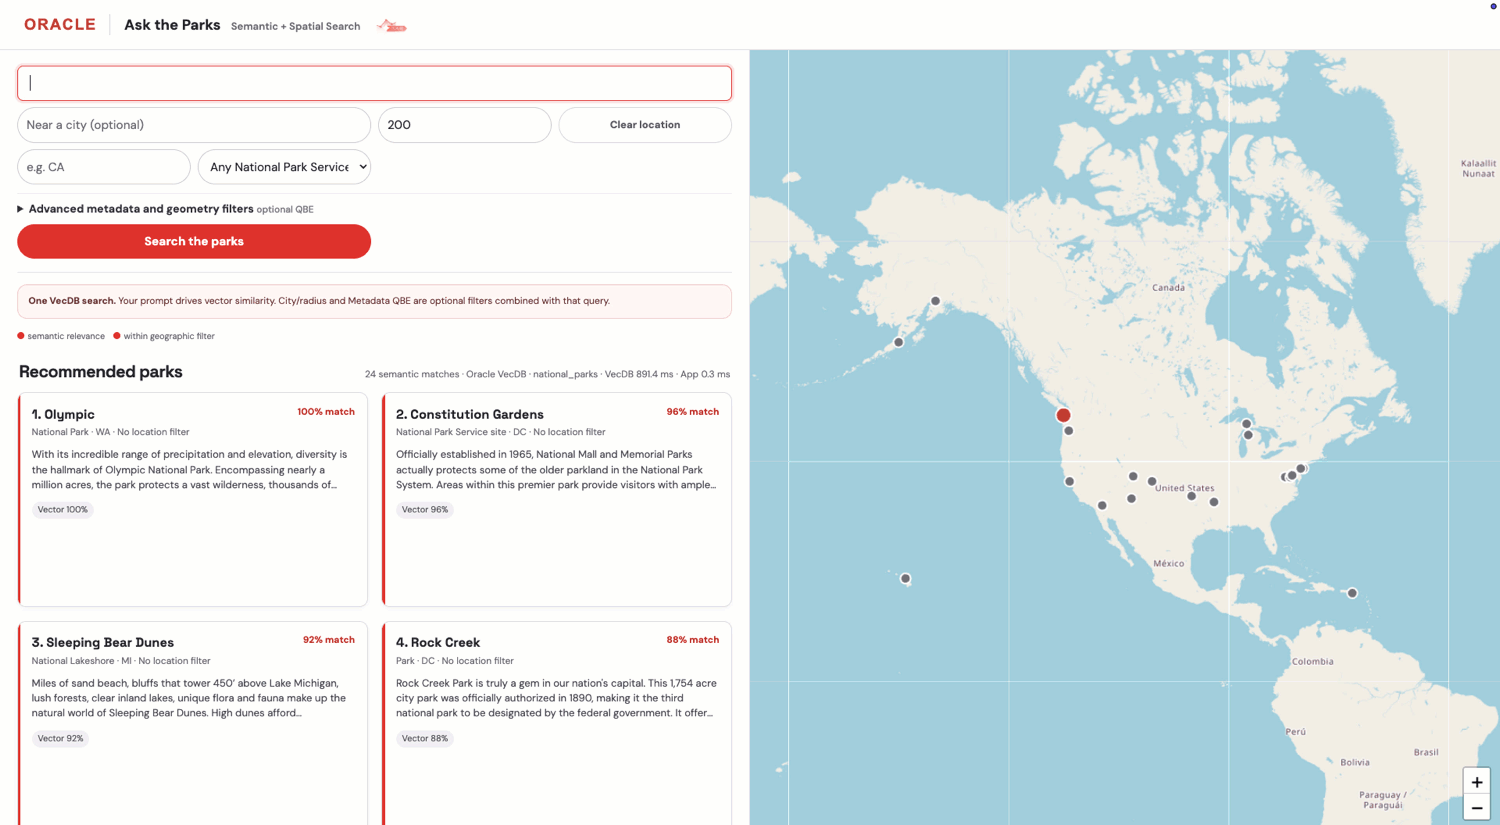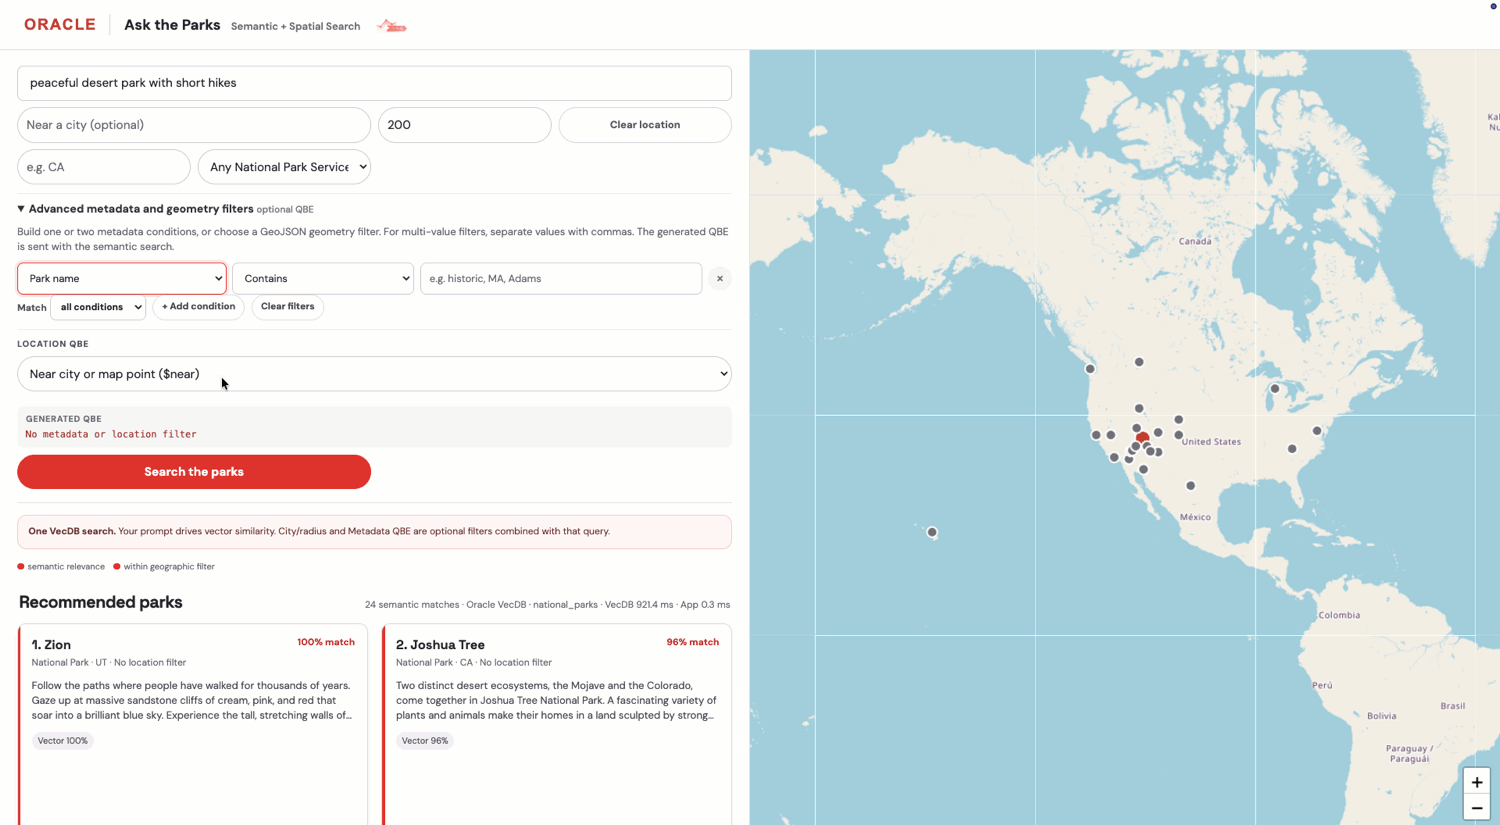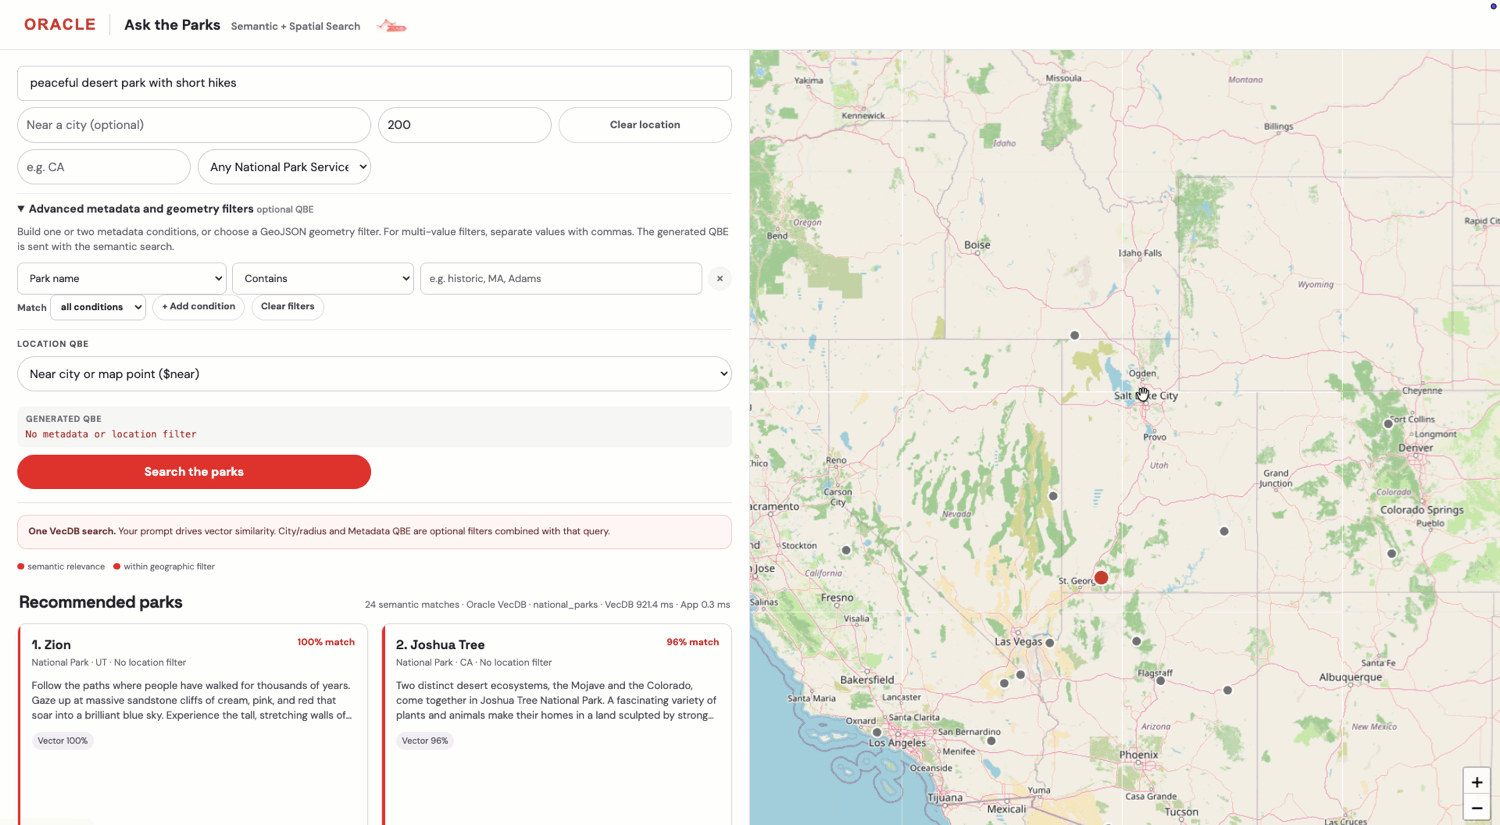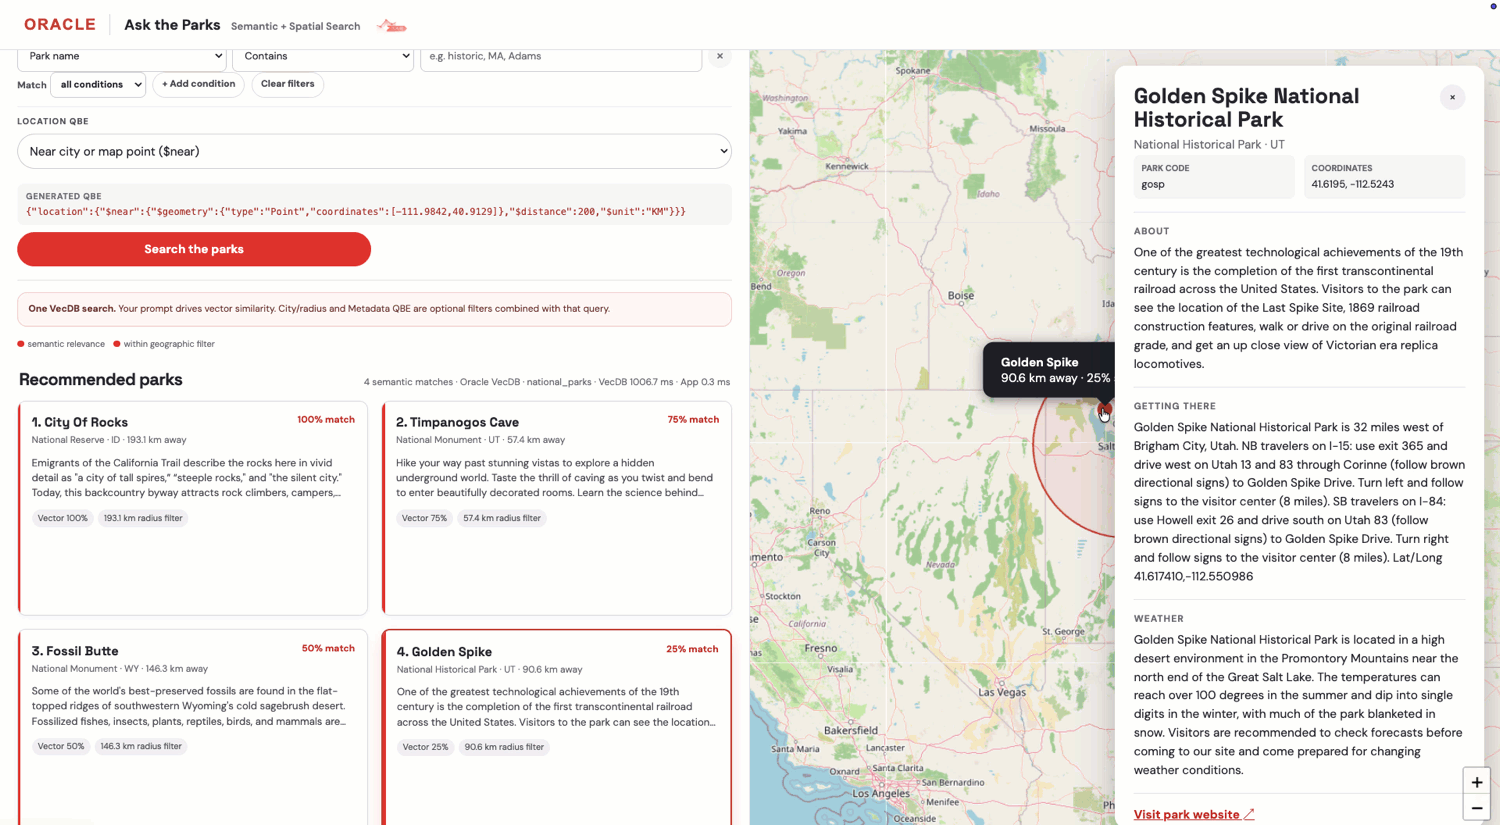
图:Oracle VecDB 在语义搜索中叠加地理和结构化元数据过滤的真实效果——输入家庭喜剧电影,系统同时考虑语义相似度(向量)、类型过滤(元数据)和地理范围(空间查询),一次返回精准结果。
oracle-vecdb 的设计目标不是又一个向量搜索库,而是将向量能力无缝融入 Oracle 数据库全栈。
向量存储与检索:
集成嵌入(Integrated Embeddings):
generate_embedding() 方法,直接调用 Oracle 托管的 embedding 模型,无需自行搭建 embedding 服务与传统数据结合:
模型管理:
oracle-vecdb 的代码结构清晰,体现了 Oracle 一贯的企业级工程风格:
src/oracle_vecdb/
├── client.py              # 顶层 Facade:OracleVecDB 主类,统一入口
├── configuration.py       # HTTPS 强制、URL 格式校验、认证配置
├── ords.py                # ORDS 服务适配层:封装 ORDS REST API 调用
├── ords_response_handlers.py  # 响应处理:重试 555/429 错误
├── service_protocol.py    # VecDBServiceProtocol:抽象接口定义
├── data_types/            # Pydantic 响应模型(自动生成)
├── services/              # 自动生成的 ORDS API 客户端
├── types.py               # 类型别名(向后兼容)
├── validation.py          # 参数校验装饰器
├── vecdb_errors.py        # 错误码体系(VECDB-001 ~ VECDB-xxx)
├── error_messages.py       # 英文错误消息模板
├── vecdb_exception.py     # VecDBException:统一异常类型
└── version.py             # SDK_VERSION = 1.0.2
关键设计亮点:
Facade + Protocol 模式:OracleVecDB 是对外的统一入口,内部通过 VecDBServiceProtocol 抽象接口,可以切换不同后端实现(当前为 ORDS)
Pydantic 数据校验:所有请求参数和响应数据均用 Pydantic 模型定义,在发送到 ORDS 前完成本地校验,失败时抛出 VecDBException 并携带错误码(如 VECDB-003:表名格式错误)
错误处理体系完整:SDK 定义了 10+ 个错误码,每个错误包含 message / cause / action 三段式描述,并支持本地化扩展
协议层重试:ORDSResponseHandler 自动处理 ORDS 服务返回的 555(内部错误)和 429(限流)响应,对 555 最多重试 3 次
大Payload保护:_MAX_UPSERT_PAYLOAD_BYTES = 32MB,超出时报 VECDB-007 错误,防止单次请求数据量过大导致 ORDS 超时
依赖极简:仅 4 个直接依赖——urllib3、python-dateutil、pydantic、typing-extensions,没有任何重型 ML 依赖。这意味着它可以安全地集成到已有的 Python 应用中,不会引入依赖冲突。
from oracle_vecdb import OracleVecDB, Configuration

config = Configuration(
    rest_url="https://<host>:<port>/ords/<schema>/_/db-api/stable/vecdb/",
    access_token="<access-token>",
)
vecdb = OracleVecDB(config)

# 语义搜索 + 元数据过滤
results = vecdb.query(
    table_name="demo",
    query_by={"text": "family film"},  # 自动 embedding
    filters={"genre": {"\$eq": "drama"}},
    top_k=3,
)
注意:SDK 要求 Python 3.10+,且必须连接 Oracle AI Database 23.26.3+ 和 ORDS 26.2.2+ 环境
| 生态 | 集成方式 |
|---|---|
| LangChain | langchain-oracledb 包提供 OracleVS 向量存储实现 |
| OraML | 支持 Oracle Database 23ai 内置机器学习模型 |
| RAG 框架 | 通过 generate_embedding + query 原生支持 RAG 流程 |
| FastAPI / React | 见 Oracle AI Developer Hub 官方示例应用 |
必须有 Oracle AI Database:这不是下载即用的开箱即用方案,必须有 Oracle Cloud OCI 账号并开通 Oracle AI Database 23.26.3+ 环境。对于非 Oracle 技术栈团队,学习和迁移成本较高
ORDS 依赖:通过 Oracle REST Data Services(ORDS)暴露 REST API,必须同时部署 ORDS 26.2.2+,增加了运维复杂度
Python 版本要求:3.10+,不支持更老的 Python 环境
向量索引知识门槛:HNSW 参数(neighbors、efConstruction、efSearch)调优需要一定经验,不当配置可能导致查询慢或内存爆炸
社区活跃度低:70 stars、1 fork 的数据表明目前社区关注度有限,Issue 响应和第三方教程资源较少
Oracle VecDB 代表的趋势是数据库厂商全面拥抱 AI 能力。过去向量数据库是独立赛道(Pinecone、Weaviate、Milvus),而 Oracle 选择在已有成熟关系型数据库中内建向量能力:
对于已在使用 Oracle 的企业,oracle-vecdb 是成本最低的 AI 升级路径;对于新项目,评估 Oracle AI Database 的性价比需要结合实际业务规模和 Oracle 授权成本综合判断。

