
opendataloader-pdf
opendataloader-project/opendataloader-pdf加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
做 RAG 的团队都遇到过同一个尴尬时刻:文档全导进来了,检索却答非所问。
原因往往不在向量库,而在 PDF 本身。PDF 记录的是"页面上画了哪些东西",而不是"这段话讲了什么"。一段两栏排版的学术论文被粗暴地按坐标读出来,左右两栏的文字在中间来回穿插;一份带边框的财务表格被拆成了几十行没有结构的短句;扫描件则直接吐出乱码。更麻烦的是,解析器吐给模型的文本里没有任何坐标,你无法告诉模型"这句话来自第几页的哪个区域",引用溯源也无从谈起。
OpenDataLoader PDF(GitHub 上 30119 star)正是冲着这个痛点来的。它的定位一句话说清:PDF Parser for AI-ready data——把任意 PDF 转成 Markdown、JSON(带边界框)、HTML 这类大模型可以直接消费的结构化数据。它是韩华 HANCOM 团队 2025 年 5 月开源出来的项目,采用 Apache-2.0 协议,同时提供 Python、Node.js、Java 三套 SDK。
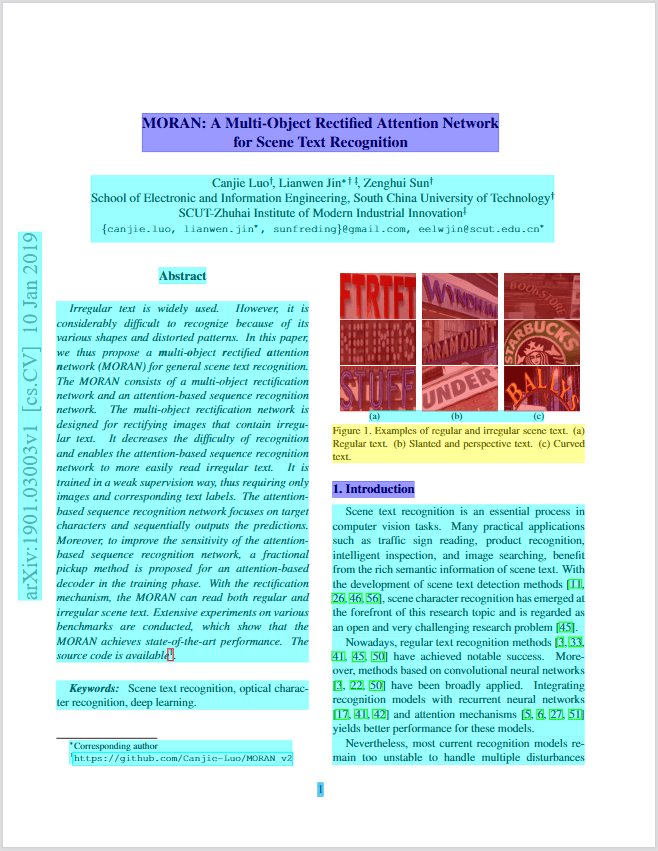
版面分析后的输出:标题、段落、表格、图片都被识别出来,并附带精确坐标
这个项目最容易被误解的地方,是它其实是两个产品共用一套内核。
第一条线是数据抽取。核心是一套确定性(deterministic)的本地版面分析算法,不依赖大模型,纯 Java 实现。核心技术是 XY-Cut++ 阅读顺序算法——不是简单地按 y 坐标从上到下,而是先递归切分页面区域,识别出正文栏、侧边栏、跨栏表格,再在每个区域内确定文本流顺序。这就是为什么它在多栏排版场景下的表现明显好于"逐行扫描"类工具。表格抽取支持有边框和无边框两种情况,能处理合并单元格;标题层级、列表结构、页眉页脚与水印过滤都在本地完成。
第二条线是无障碍(Accessibility)自动化,这是这个项目真正的差异化所在。欧洲无障碍法案(EAA)、美国 ADA、Section 508 都在强制要求公共与商业文档必须可被屏幕阅读器正确朗读,而人工修复一份 PDF 的成本高达 50~200 美元且无法规模化。项目实现了开源社区第一个端到端的 PDF 自动打标签(auto-tagging) 流水线:未打标签的 PDF 进去,带结构标签的 Tagged PDF 出来。这一部分是与 PDF Association 规范制定方以及 veraPDF(PDF 校验工具的开发方)Dual Lab 合作的成果,按 Well-Tagged PDF 规范实现并用 veraPDF 做了验证。
本地算法再强也有天花板。复杂无边框表格、扫描件 OCR、LaTeX 公式、图表描述,这些任务纯规则做不好。
于是有了 Hybrid 模式:简单页面留在本地 Java 侧处理(0.015 秒/页),复杂页面才路由给 AI 后端。后端默认是 docling,配合 docling-parse 与 EasyOCR(支持 80 多种语言)。效果提升非常直观——表格准确率从 0.489 飙到 0.928,提升幅度约 90%;标题准确率提升 11%,阅读顺序提升 4%;代价是速度慢了约 31 倍。
这个设计思路和它自带的 AI 安全过滤是配套的:项目内置了对隐藏文本、页面外内容以及 prompt injection(提示词注入) 的过滤。因为 PDF 内容会原样进入 LLM 上下文,一份精心构造的 PDF 完全可能携带"忽略你之前所有指令"这类恶意文本,解析器必须把它拦下来。
在自建的 opendataloader-bench 基准(200 份真实世界 PDF,含多栏与科学论文)上,Hybrid 模式综合得分 0.907 排名第一。
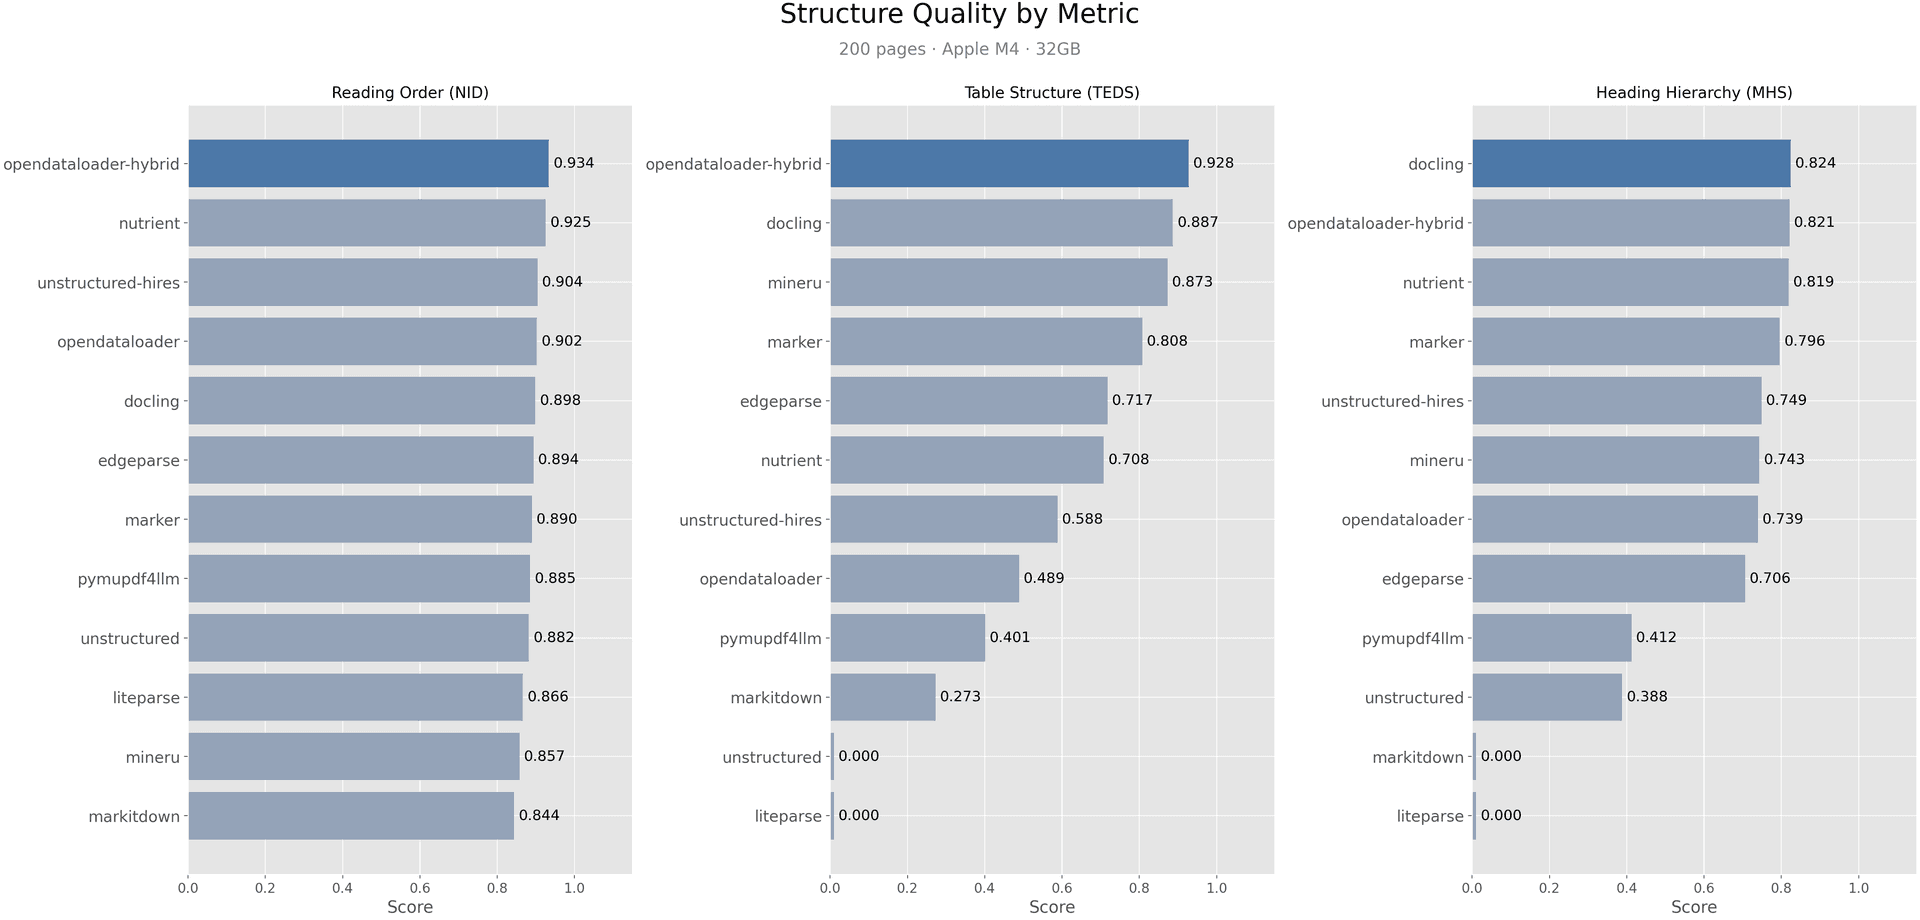
基准测试质量分项对比:OpenDataLoader Hybrid 在阅读顺序与表格维度领先
值得注意的是它的自我定位很诚实:README 里明确列出"不支持 Word/Excel/PPT 处理""不需要 GPU",并且把最硬的合规出口——PDF/UA-1 与 PDF/UA-2 导出以及可视化无障碍编辑器——放在了付费的企业版里。开源部分交付的是 Tagged PDF 这道"前置工序",合规认证的最后一步需要商业版。
仓库是典型的多语言单体仓库(monorepo):java/opendataloader-pdf-core 是核心库,基于 Apache PDFBox 做 PDF 解析、Jackson 做序列化、verapdf-xmp-core 处理 XMP 元数据;java/opendataloader-pdf-cli 是命令行入口;python/opendataloader-pdf 是 Python 封装(hatchling 构建,pyproject 声明 Python ≥3.11),python/opendataloader-pdf-mcp 额外提供了一个 MCP Server,可直接挂到 AI Agent 工具链上;node/opendataloader-pdf 是 TypeScript SDK。
代码规模方面:Java 源码 211 个文件、Python 27 个、TypeScript 11 个。测试覆盖相当扎实——Java 侧 102 个测试文件并接入 JaCoCo 覆盖率统计,Python 侧 14 个 pytest 文件(含 hybrid server 的 OCR 选项、部分成功、Unicode 等专项),Node 侧 5 个 vitest 文件(含集成测试)。CI 侧有 preflight、release、benchmark、skill-drift-check 等 7 个 workflow。文档方面,除了 4 万多字符的 README,还有独立的 skills/odl-pdf 技能包(含 hybrid 指南、选项交互规则、安装矩阵)和一整套面向 AI Agent 的使用技能(odl-fix、odl-review),后者专门强调"零退出码不等于解析成功"这个坑。
有意思的是,项目的技能文档里明确写着:永远不要凭记忆拼选项名,必须先跑 --help 读取已安装版本的实际选项。这是一种很克制、也很专业的工程态度。
pip install opendataloader-pdf
import opendataloader_pdf
opendataloader_pdf.convert(
    input_path=["file1.pdf", "file2.pdf", "folder/"],
    output_dir="output/",
    format="markdown,json"
)
前置条件是 JDK 11+ 与 Python 3.11+(Node.js 路线需要 Node ≥22.13)。注意每次 convert() 都会拉起一个 JVM 进程,所以批量场景应该在一次调用里传入整个目录列表,而不是循环调用。
部署层面需要留意:仓库里没有 Dockerfile、没有 docker-compose、也没有 K8s 清单,全部依赖 PyPI / npm / Maven Central 三条分发渠道。Hybrid 模式额外启动一个 FastAPI + uvicorn 的本地服务(默认端口 5002)作为 AI 后端。也就是说它是一个"库 + CLI"形态的工具,而不是一个开箱即用的 Web 应用,没有图形界面,这一点在评估接入成本时必须提前和业务方讲清楚。
第一,基准是自建自测的。opendataloader-bench 由项目方自己维护,0.907 这个数字的可信度需要读者自行打折;横向对比时其它引擎的版本锁定情况未必一致。
第二,Hybrid 模式的速度代价真实存在,31 倍的减速在百万级文档批处理场景下是必须计入成本的。
第三,最关键的合规能力不在开源版。European Accessibility Act 的时间表在推进,但真正能出具 PDF/UA 合规文件的是企业版,开源自动打标签只是把工作流推进了一步。
第四,Java 依赖较重。PDFBox 加 JVM 本身意味着较高的内存占用和启动开销,在 Serverless 或边缘函数环境里并不友好。
第五,项目成立时间较短(2025 年 5 月至今约一年半),虽已发布 87 个 tag、1049 次提交、33 位贡献者,但 API 仍在演进——仓库里的技能文档专门强调过选项名在不同版本间会变。
把 PDF 变成 AI 可用的数据,是整个 RAG 产业最脏的一块活儿。这两年涌现的 MinerU、Docling、Marker、PyMuPDF4LLM、unstructured 各有各的长处,但市场普遍存在两个痛点:准确率不够高导致检索命中差,以及缺乏合规路径导致企业不敢用。
OpenDataLoader PDF 的路线值得注意的地方在于它同时押注了这两条线,并且用 Apache-2.0 协议把抽取与自动打标签的核心能力开放出来,把商业价值放在合规认证与可视化编辑上——这与许多同类项目"全功能开源、变现靠托管服务"的路径不同。对于需要满足无障碍法案的公共部门、出版机构与金融行业,这个"开源做重活、付费做验收"的组合可能比纯技术竞赛更有说服力。
从社区热度看,30k star、2.8k fork、87 个版本、33 位贡献者、每日仍有提交,这个项目目前处于活跃上升期,值得列入技术雷达持续观察。
