
OpenMetadata
open-metadata/OpenMetadata加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
设想一个场景。团队上线了一个 RAG 客服机器人,接入公司的数据仓库和 BI 看板。半年后,问答准确率却一路下滑。用户问"上季度华东区的复购率是多少",机器人给出 12%,财务说实际是 19%。
问题出在哪?不在模型。模型忠实地检索到了三张表:一张 orders_snapshot、一张 region_mapping、一张 customer_labels。它不知道哪个是权威源、不知道"复购"在这家公司到底怎么定义、不知道 region_mapping 是上个季度重构前的遗留表、也不知道这张表三个月前被上游改过一次口径。
这就是数据世界的常态:数据是有的,上下文是缺的。
AI 直接连数据库,等于给一个极聪明的实习生一本只有表结构的字典,却没有告诉他公司怎么说话、谁负责哪块数据、哪些表能信、哪些数据合同承诺了可用性。
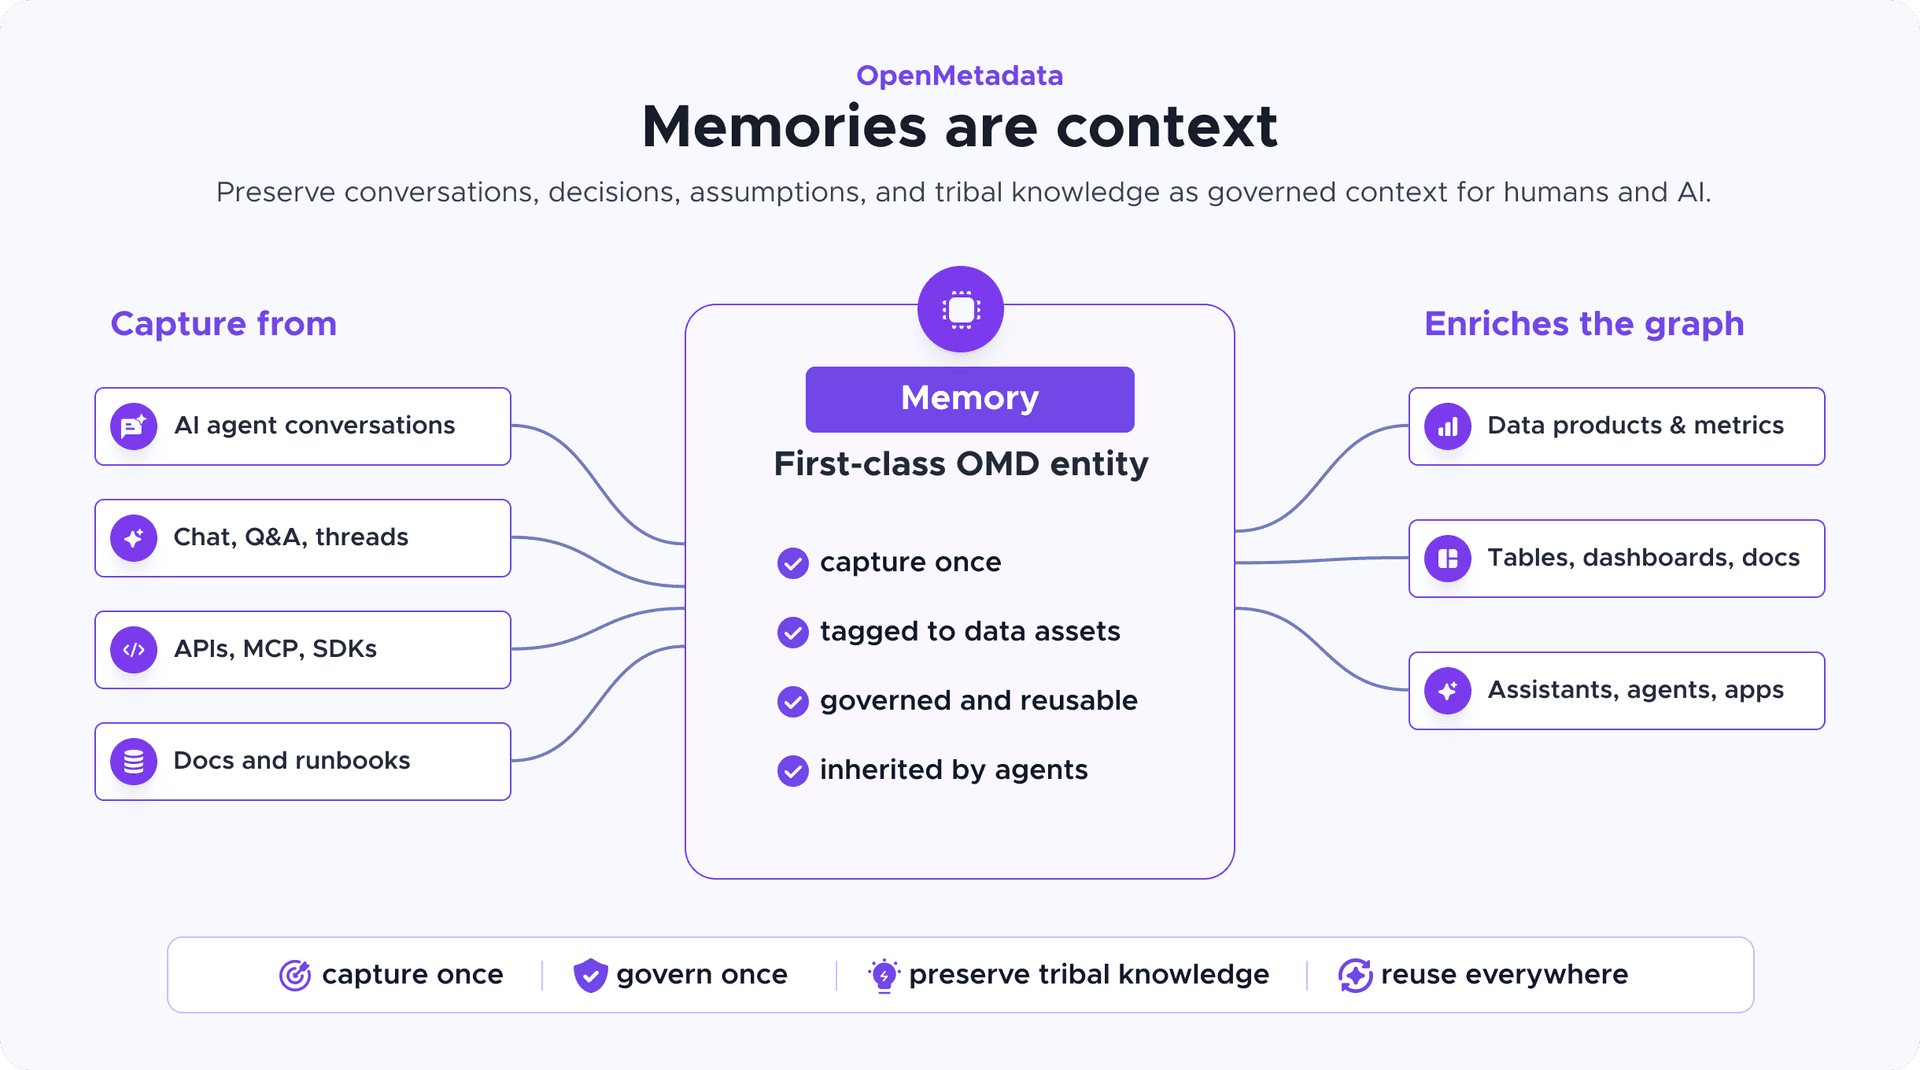
OpenMetadata 就是来解决这个问题的。它的自我定位一句话讲清:"AI 不需要另一个原始数据库连接器,AI 需要的是上下文 + 记忆。"
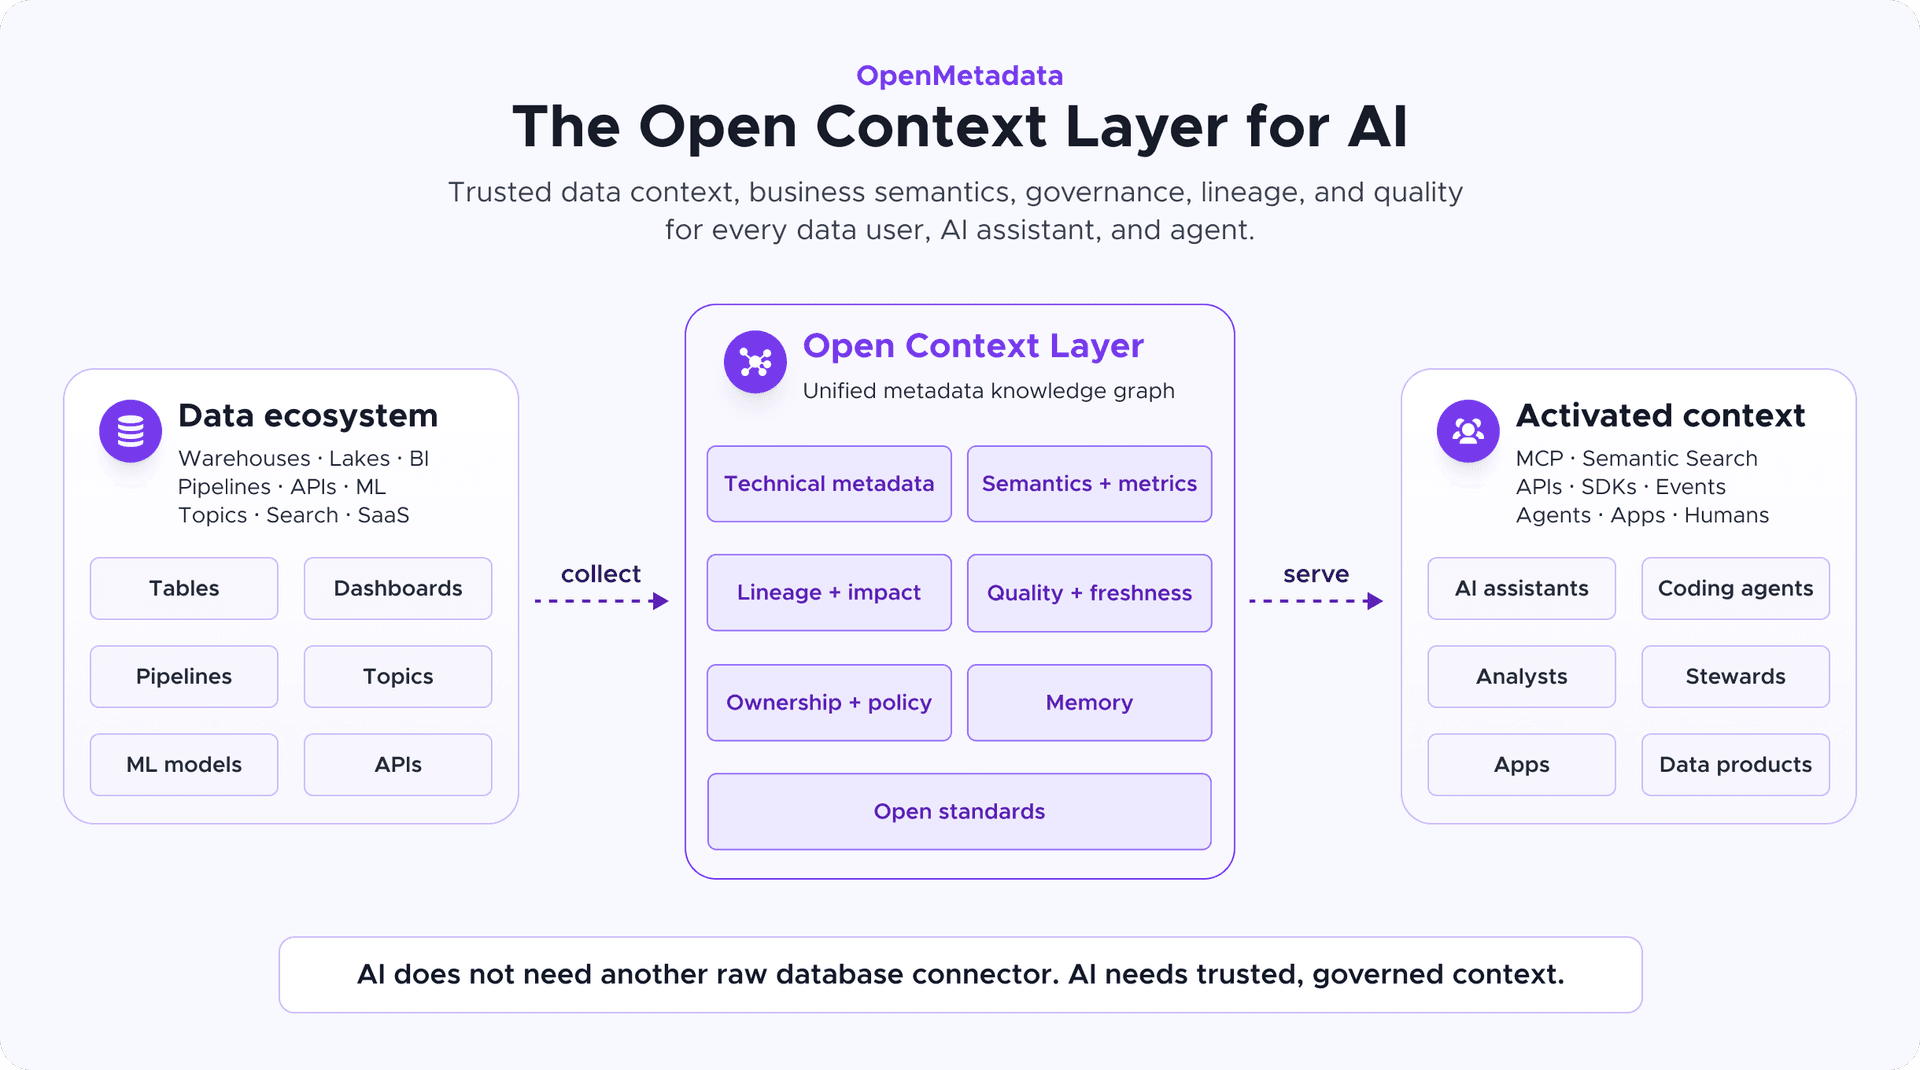
OpenMetadata 起源于 Collate 这家商业公司的一个决定——把原来闭源的数据目录内核开放出来。2021 年 8 月项目在 GitHub 上开仓,Apache-2.0 协议一路走到今天,15,638 star、2,496 fork、426 位贡献者,2026 年 10 月仍在高频提交(最近一次 push 就在 10 月 31 日),当前版本线为 2.0.7 / 2.1.0-rc1。
有意思的是商业与开源的关系:Collate 现在把自己的商业版直接构建在 OpenMetadata 之上,开源项目是地基,商业版是上面盖的楼。这种"开源做地基、闭源做增值"的模式,让它既有社区活跃度,又有商业可持续性——比纯捐赠型开源项目健康得多。
技术上它的定位可以拆成五层:
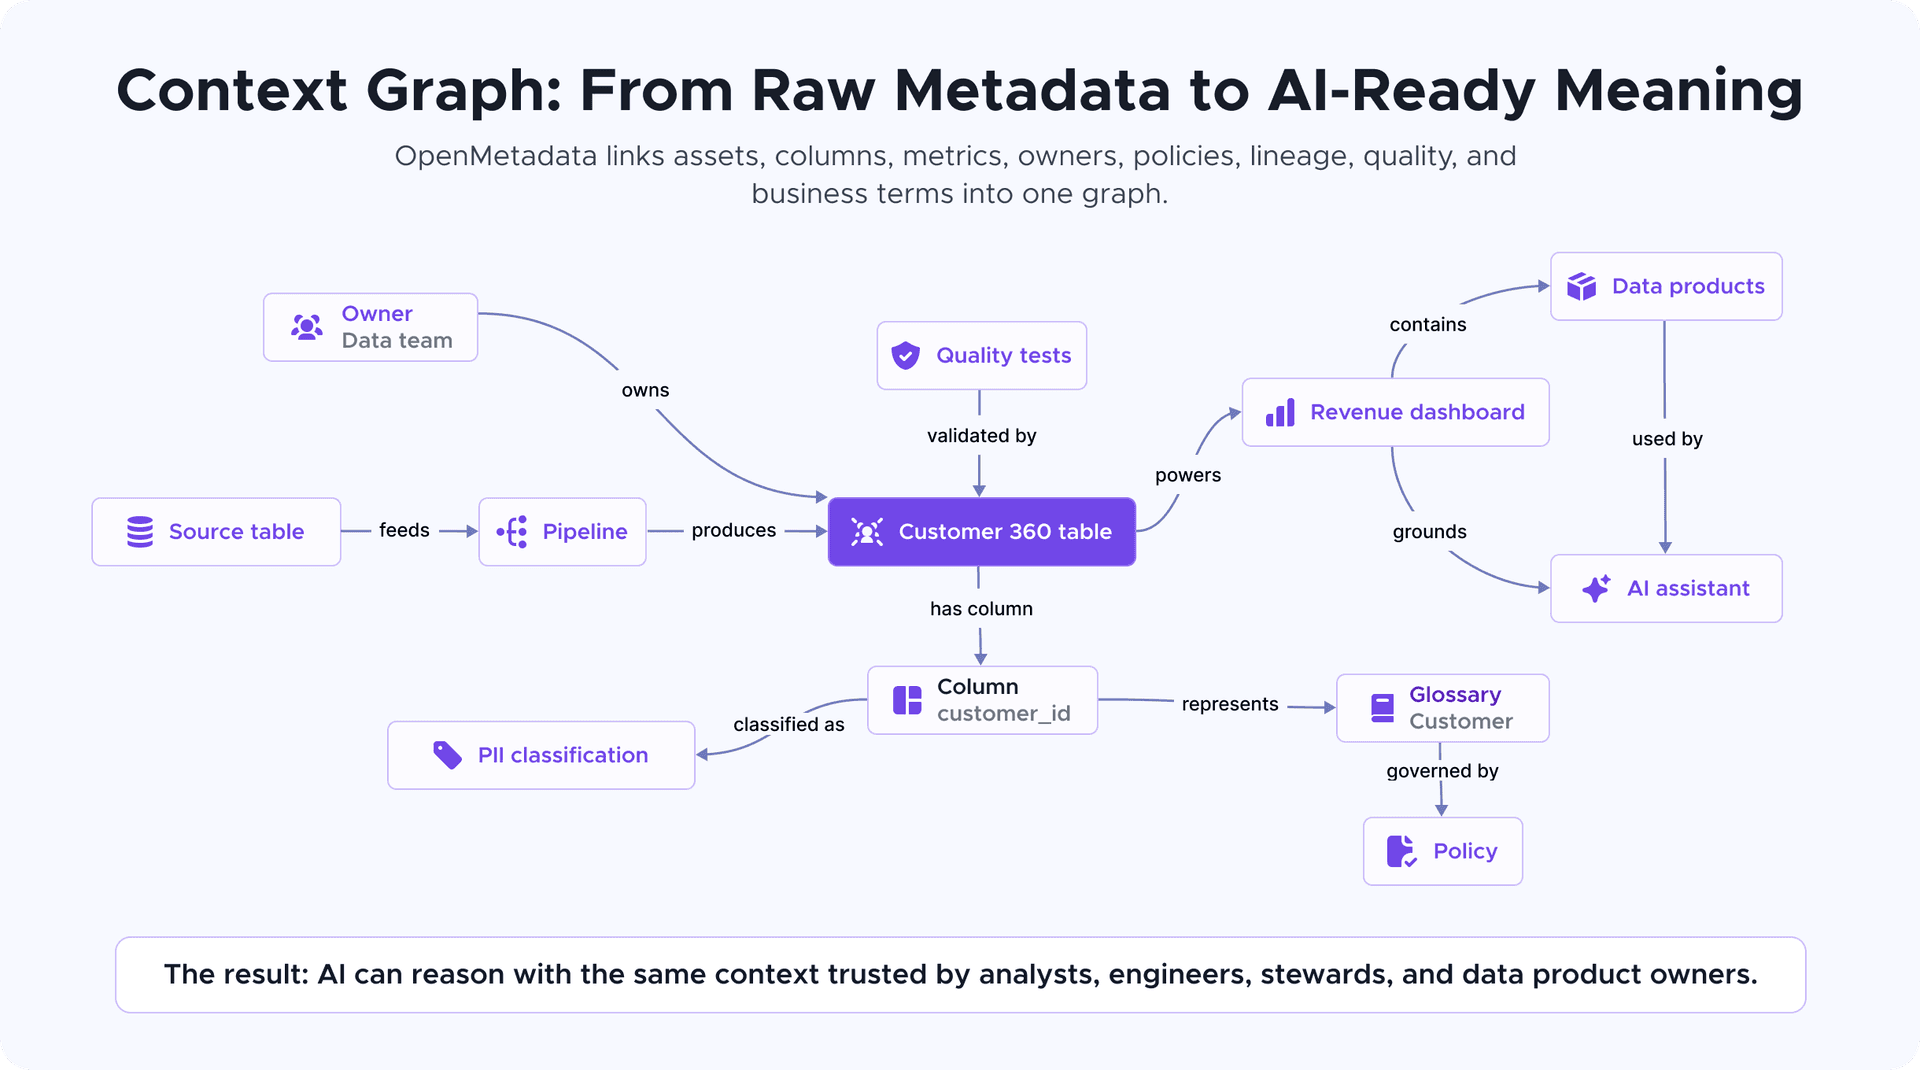
如果非要用一个比喻,OpenMetadata 更像是企业数据的户籍系统。
关键差异在于:这套系统不是被动文档,而是机器可读、可查询、可被 Agent 调用的活数据。
OpenMetadata 的核心资产是一张统一元数据图谱。支持表级和列级血缘,血缘可跨管道、数据库、BI 看板、指标、ML 模型贯通,并且能接收 OpenLineage 标准事件做富化。做影响分析(改这个字段会炸哪些下游)时,图谱是唯一事实来源。
按源码目录实际清点(ingestion/src/metadata/ingestion/source/):
| 类别 | 数量 | 覆盖示例 |
|---|---|---|
| 数据库 | 53 | BigQuery、Snowflake、Redshift、Databricks、Athena、ClickHouse、Cassandra、MongoDB、Oracle、PostgreSQL、Doris、Druid、Trino/Presto、Greenplum… |
| BI 看板 | 19 | Tableau、Power BI、Looker、Metabase、Grafana、Superset、Qlik、MicroStrategy、Sigma、Redash… |
| 管道/编排 | 16 | Airflow、Dagster、dbt Cloud、Fivetran、Airbyte、Prefect、Spline、OpenLineage、Kafka Connect… |
| 消息队列 | 5 | Kafka、Kinesis、NATS、Pub/Sub、Redpanda |
| 搜索/存储/ML | 2+2+2 | Elasticsearch、OpenSearch、S3、GCS、MLflow、SageMaker |
| 其他 | 5 | REST API、Google Drive、SFTP、Drive 类 |
官方 README 宣传的是 "130+ connectors",社区版实际源码目录清点为 100 个连接器目录(不含 common 等公共模块),这个数字差异来自部分连接器在 UI 侧的聚合拆分,做选型时应以 100 为保守基线。
这是 2.0 版本最关键的新增点。openmetadata-mcp 模块实现了完整的 OAuth 2.0 Authorization Code + PKCE 流程(RFC 7636),支持 Google、Okta、Azure AD、Auth0、Cognito、自定义 OIDC、LDAP、SAML 等 SSO,并做了 refresh token 轮转、Fernet 静态加密、CSRF state 校验、session 固定攻击防护。
对 AI 开发者来说,意义是:你的 Agent 可以用用户在 OpenMetadata 里的真实权限访问元数据,而不是拿着一个万能 admin token 横冲直撞。权限边界天然跟着人的身份走。
AI SDK 部分可以把 MCP 工具一行转成 LangChain 格式,Python SDK 则能直接读元数据、跑语义搜索。
支持 ODCS 3.1(Open Data Contract Standard)的导入导出、RDF/OWL + JSON-LD + SHACL、DCAT/DPROD、PROV-O。这不是堆砌词汇——SHACL 意味着图谱可以做形式化约束校验,PROV-O 意味着血缘有标准语义,不同厂商的元数据可以互操作。
uv.lockTHREAT_MODEL.md、SECURITY.md、ARCHITECTURE.md、openspec/ 目录,Jetty 版本锁在 12.1.14(明确注释是为修 CVE-2026-19863 等系列漏洞)技术栈分布(GitHub Languages 字节数):TypeScript 65.1MB(前端 UI)、Java 56.1MB(服务端 Dropwizard 5.0 + Jetty 12)、Python 25.1MB(ingestion 框架,requires-python >=3.10)。
两条路,门槛差很多。
方式一:Docker Compose 一键起(推荐给评估者)
docker/docker-compose-quickstart/docker-compose.yml 提供完整编排,一次拉起 4 个核心服务:MySQL 8、Elasticsearch 9.3(-Xms1024m -Xmx1024m)、OpenMetadata Server、Airflow ingestion。默认账号 admin / admin。端口 8585 是 Web UI。
但要注意内存是真实门槛:ES 自己就吃 2GB,加上 JVM、MySQL、Airflow,8GB 是现实下限,4GB 机器上 ES 容易 OOM 后被 K8s 重启拉起,形成启动循环。
仓库还有更多变体:docker-compose-rdf.yml(挂 Apache Jena Fuseki 做 RDF 存储)、docker-compose-opensearch-standalone.yml、docker-compose-multiarch(含 arm64)、docker-compose-postgres.yml(生产推荐 PostgreSQL + OpenSearch 替代 MySQL + ES)。
方式二:从源码构建(贡献者路径)
Maven 多模块(openmetadata-service / openmetadata-ui / openmetadata-dist),前端 Node >= 22.23.4 + Yarn 1.22 + Vite 6GB 堆内存。仓库 3.4GB size、代码量极大,clone 就要花不少时间磁盘。
方式三:K8s Operator
openmetadata-k8s-operator 提供自定义资源 OMJob,用两阶段执行模式(类似 Argo Workflows 的 onExit handler)保证所有 Pod 终止场景——正常完成、应用失败、崩溃、OOM 被杀、人工终止、节点故障——退出处理器都能可靠执行。这是在 K8s 上跑数据管道的实用解法。
方式四:只做元数据采集
只想把元数据拉出来,不要 Web UI,可以只用 ingestion 模块(Python 包 openmetadata-ingestion,2.0.0.0.dev0),它支持 Airflow Operator、独立脚本和自定义连接器三种用法。
部署重量级。这是典型的"企业级"开源项目病:想快速看一眼效果,也要先准备 Docker + 8GB 内存 + 等待 ES 和 MySQL 健康检查。相比轻量级数据目录工具,评估成本明显更高。
资源消耗大。仓库 3.4GB、代码量在开源数据治理项目里属于第一梯队,全量构建和本地开发都会吃力。ES + JVM 的内存调优是绕不开的运维功课。
商业版边界模糊。开源版与 Collate 商业版的功能界限并不总是清晰。部分高级能力(AI Studio、AI Analytics、Reverse Metadata、AI Governance Studio、托管企业 MCP 工作流)留在商业版。这不是缺点,但选型时要明确自己需要的功能是否在开源侧。
安全策略范围偏窄。SECURITY.md 明确把 CVE 范围限定在"允许未认证攻击者访问平台或其受保护数据的认证类漏洞",明确不把 RBAC/ABAC 授权策略问题视为 CVE。这对依赖它做权限边界的企业是一个需要自己评估的风险点。
迭代节奏快、版本线碎片。63 个工作流、多分支并行(backport、merge queue、daily report),2.0/2.1/1.13/1.12 并存,加上社区版 100 连接器与官方宣称的 130+ 存在口径差异,说明文档与代码之间存在一定滞后。
开源许可友好但集成本高。Apache-2.0 非常友好,元数据模型基于开放标准(JSON Schema、RDF/OWL、ODCS),不存在被厂商锁死的风险——但要真正用起来,团队需要具备元数据建模、图数据库思维和一定 Java 生态运维能力。
2026 年最有意思的趋势是,数据治理的边界正在向 AI 治理外扩。Collate 2.0 的发布说明里已经出现"AI Governance Studio"——把 AI 应用、LLM、MCP Server、Agent 和它们使用的数据放进同一张图里管,还能对齐 EU AI Act、NIST AI RMF、ISO/IEC 42001。
OpenMetadata 2.0 把 MCP Server、语义搜索、AI SDK、记忆原语全部做进开源内核,说明社区已经达成共识:AI 时代的上下文基础设施,形态就是一个带权限的血缘图谱,而不是又一个向量数据库。
它的增长曲线也印证了这个判断——从 2021 年的几千 star 涨到今天的 15.6k,两轮产品形态跃迁(数据目录 → 上下文层)都踩在了风口上。
适合:
不适合:
一句话总结:OpenMetadata 把企业里散落的元数据收拢成一张有权限、有语义、有记忆的图谱,再用 MCP Server 把这张图谱开放给 AI 智能体。它不解决"模型不够聪明"的问题,它解决"模型不知道公司规矩"的问题——而后者才是当前企业 AI 落地的主要瓶颈。
