
ollmo
ollmo-go/ollmo加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:你是企业知识库管理员,手里有大量内部文档——产品规格手册、内部流程规范、技术报告——分散在不同文件夹、不同格式,传统搜索只能靠关键词匹配,用户稍微换个说法就找不到想要的内容。更麻烦的是,AI 助手的回答常常"一本正经地胡说八道",因为它根本不知道你公司的私有知识。
ollmo 解决的正是这个问题:把私有文档变成能够对话的 AI 知识助手,答案直接引用原文,回答有据可查。
市面上主流的 AI 应用编排平台往往存在一个共同问题:系统本身比业务还复杂。几十个节点类型、上百项配置项,想让 AI 回答一个简单问题,先得花两三天学会整套系统。
ollmo 的设计哲学是极度克制:三步走——上传文档、提出问题、拿到带出处的答案。一条命令部署,十分钟上手。
背后推动这一理念的是 DSH 团队,他们长期服务企业级知识管理场景,深知"让 AI 用起来简单"比"让 AI 能力强大"更难做到。ollmo 因此选择了一条少有人走的路:用 Go 语言重写核心逻辑,用 Milvus 做向量检索,用 MinIO 实现真正的私有化部署。
ollmo 采用 Milvus 稠密向量 + MySQL FULLTEXT 词法匹配 的混合检索方案,并通过 RRF(Reciprocal Rank Fusion) 融合两种检索结果。这种设计兼顾了精确匹配和语义理解:关键词检索保证了品牌名、型号的召回,语义向量检索则处理"找类似的解决方案"这类语义查询。内置检索测试面板可实时调整权重,观察不同配置下的检索结果。
ollmo 在 MySQL、Milvus、MinIO 三个数据层全部实现了逻辑租户隔离,每张表都携带 tenant_id,任何租户都无法访问其他租户的数据。
文档处理流水线:上传(拖拽、粘贴、多文件)→ 解析(MinerU 或本地解析器)→ 分块 → 向量化 → 索引,全程由 Asynq + Redis 驱动,完全异步执行。可视化入库 DAG 画布让非技术人员也能理解文档加工流程。
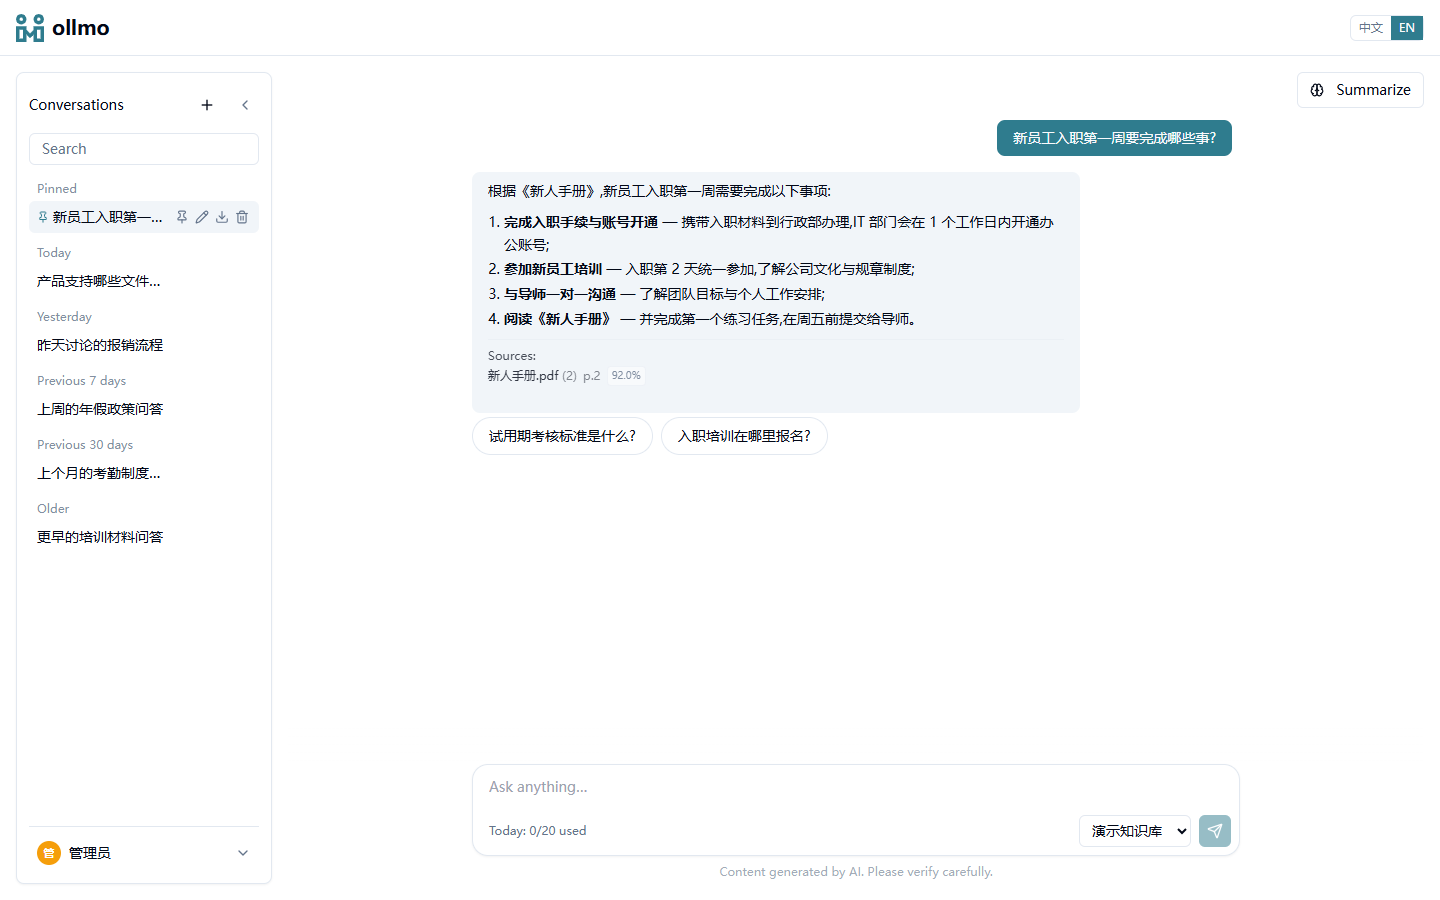
ollmo 以 SSE 流式输出实时返回回答,答案中的每句话都可点击对应引用标注,直接打开源文档并高亮命中段落。PDF 原版渲染、解析视图翻页导航、对话与文档并排对照——"答案即出处"极大提升了用户对 AI 回答的信任度。
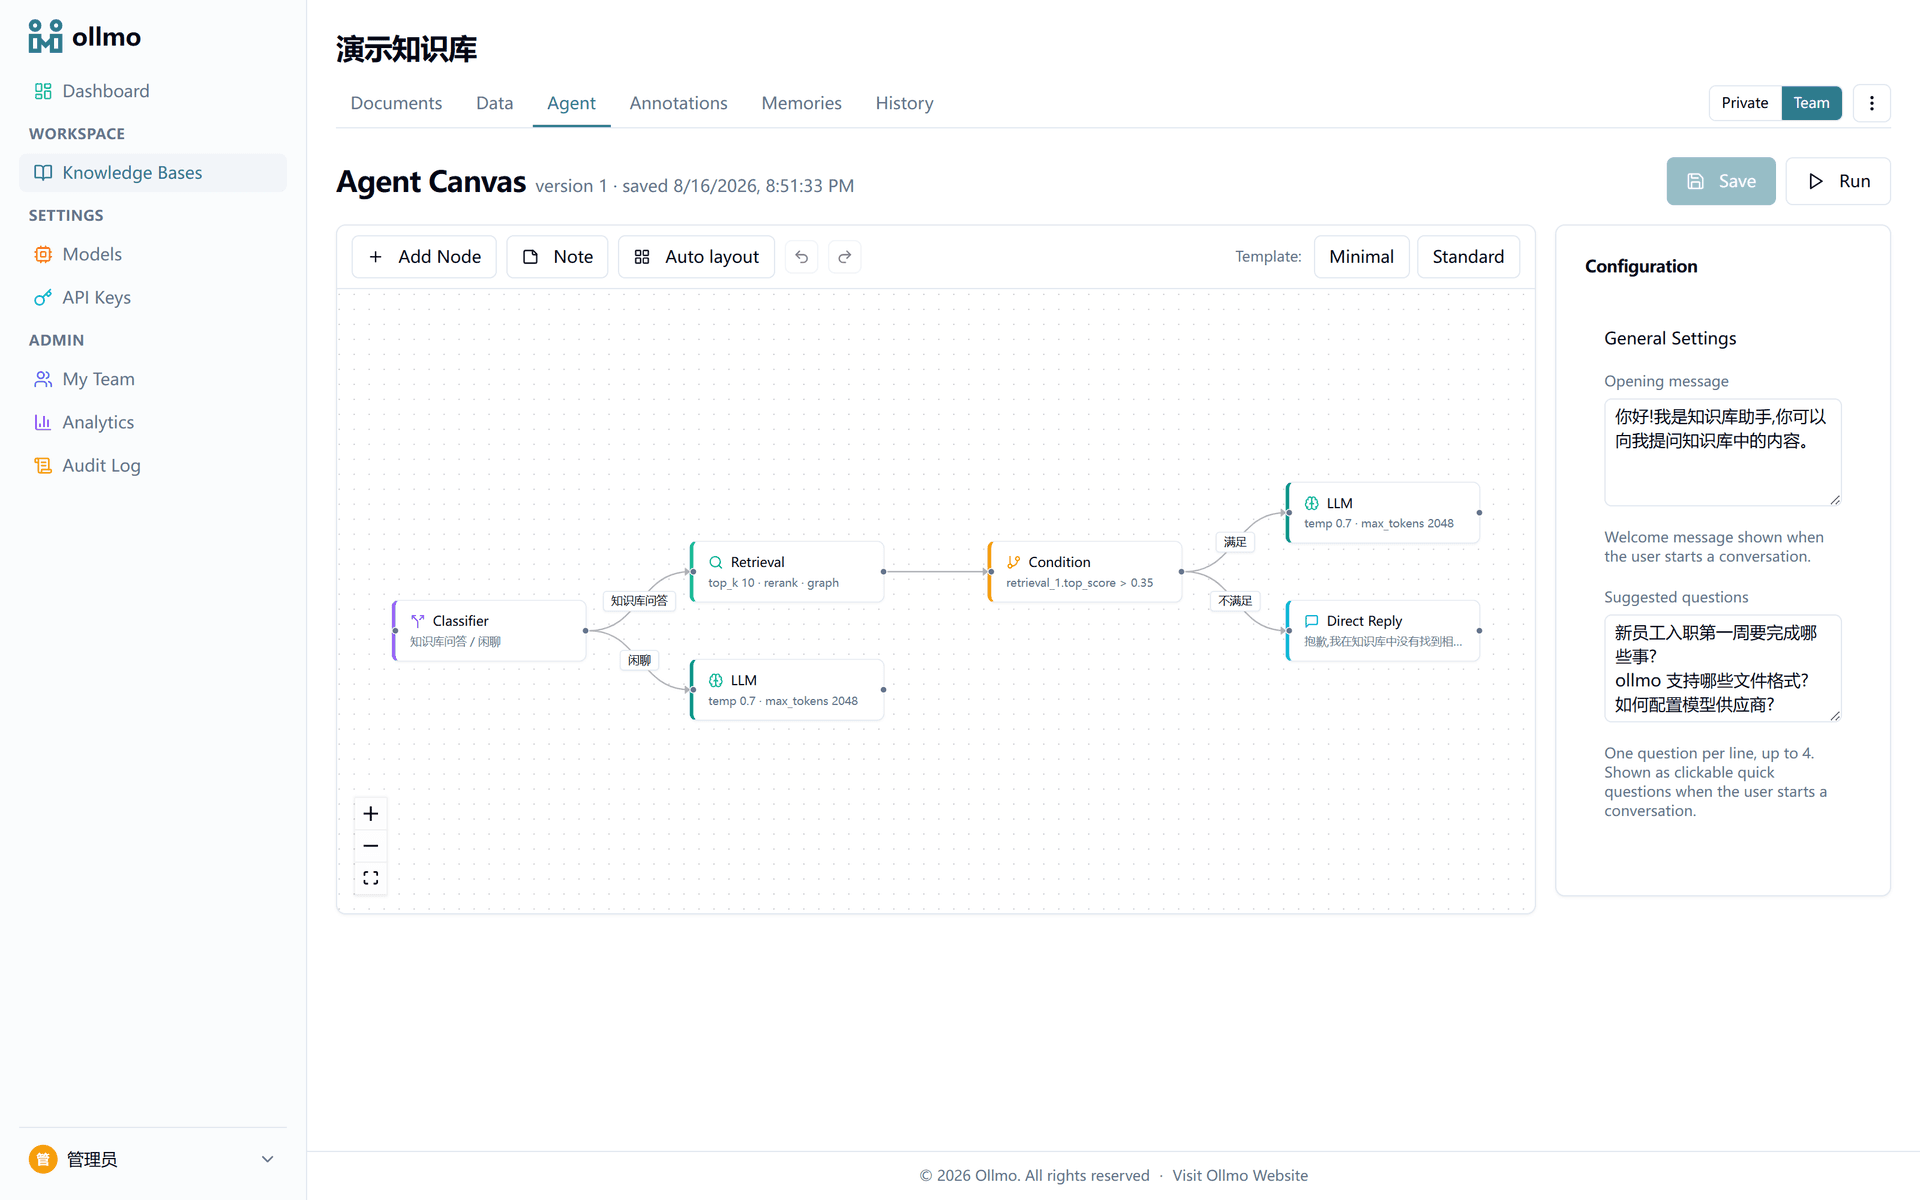
基于 React Flow 的 Agent 画布支持可视化编排:意图分类 → 检索 → 条件分支 → LLM → 直接回复,节点间通过变量引用传递输出,支持单节点调试和运行时节点高亮。
ollmo 原生支持 GraphRAG:入库时由 LLM 抽取实体与关系构建知识图谱,查询时通过实体匹配增强检索上下文,对多跳关系查询有明显优势。长对话自动摘要功能实现了跨对话上下文延续。
ollmo 选择 Go + Fiber 作为后端——这在 AI 应用领域相当罕见。大多数 RAG 项目后端是 Python FastAPI,但 Go 带来了显著优势:并发处理能力强(适合高并发流式对话)、二进制部署简单(无需 Python 环境管理)、内存占用低(相比 Python 节省约 70% 内存)。
前端基于 Next.js 15 App Router + shadcn/ui + React Flow,shadcn/ui 保证 UI 一致性,React Flow 支撑了 Agent 画布和数据流水线画布两大可视化核心。
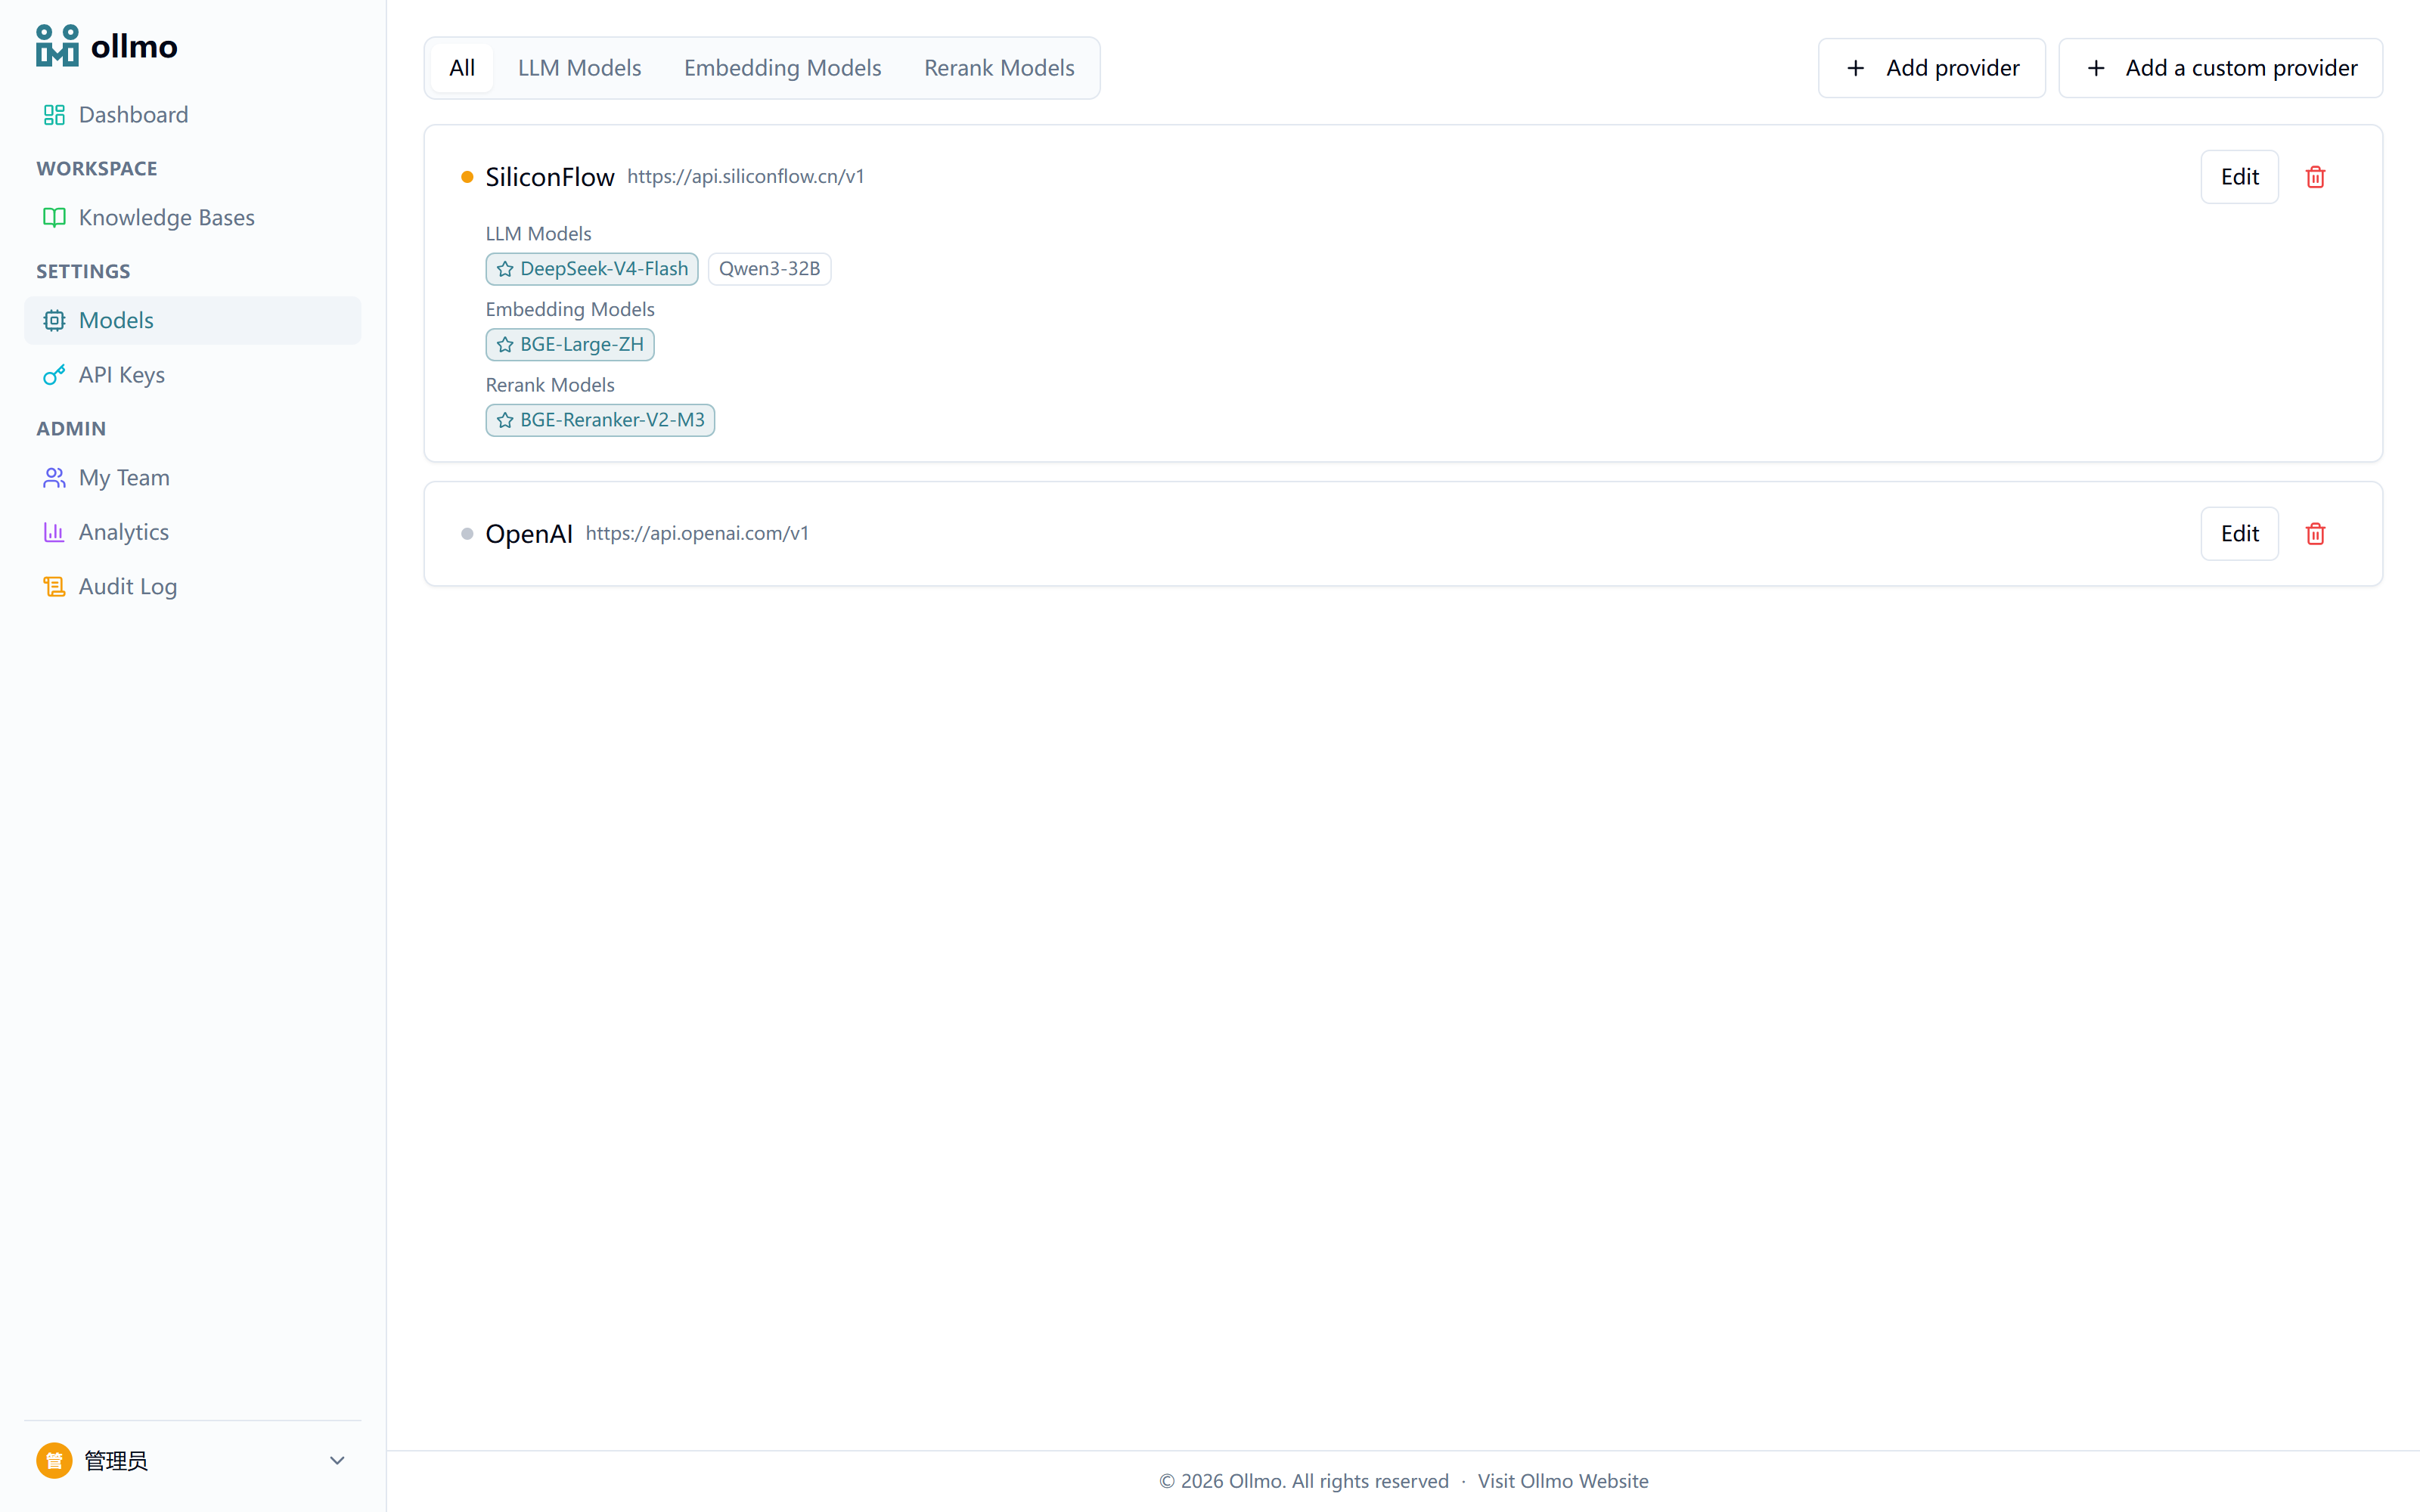
数据层:MySQL 8.0(元数据)、Milvus 2.5(向量检索)、MinIO(S3 兼容对象存储)、Redis + Asynq(异步任务队列)。文档解析支持本地解析器和 MinerU(容器化,GPU 加速)。
git clone https://github.com/ollmo-go/ollmo.git
cd ollmo && docker-compose up -d
整个集群包含 6 个服务,启动后约 30 秒内就绪。访问 http://localhost:3001,用 demo@ollmo.com / ollmo123 登录即可体验完整功能。
ollmo 代表了一个值得关注的方向:RAG 平台从"功能堆砌"走向"极致简单"。在 Dify、Flowise 等平台追求大而全时,ollmo 选择用克制换取上手速度。
Go + Fiber + Next.js 的技术栈组合在开源 RAG 领域独树一帜,虽然牺牲了 Python 生态的灵活性,但换来了运维简便性和资源效率——这对资源有限的中小团队具有现实吸引力。随着企业私有化部署需求持续增长,这样"开箱即用"的轻量级 RAG 平台有望在垂直领域找到自己的生态位。
