
nunchaku
nunchux-ai/nunchaku加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你在一张 16GB 的消费级 4090 上想跑 FLUX.1-dev 出图,官方 12B 模型 BF16 权重塞不进显存,开了 CPU offload 后单张图要等好几分钟——这时 Nunchaku 就是那个「把 12B 压成 4-bit 还跑得更快」的解药。
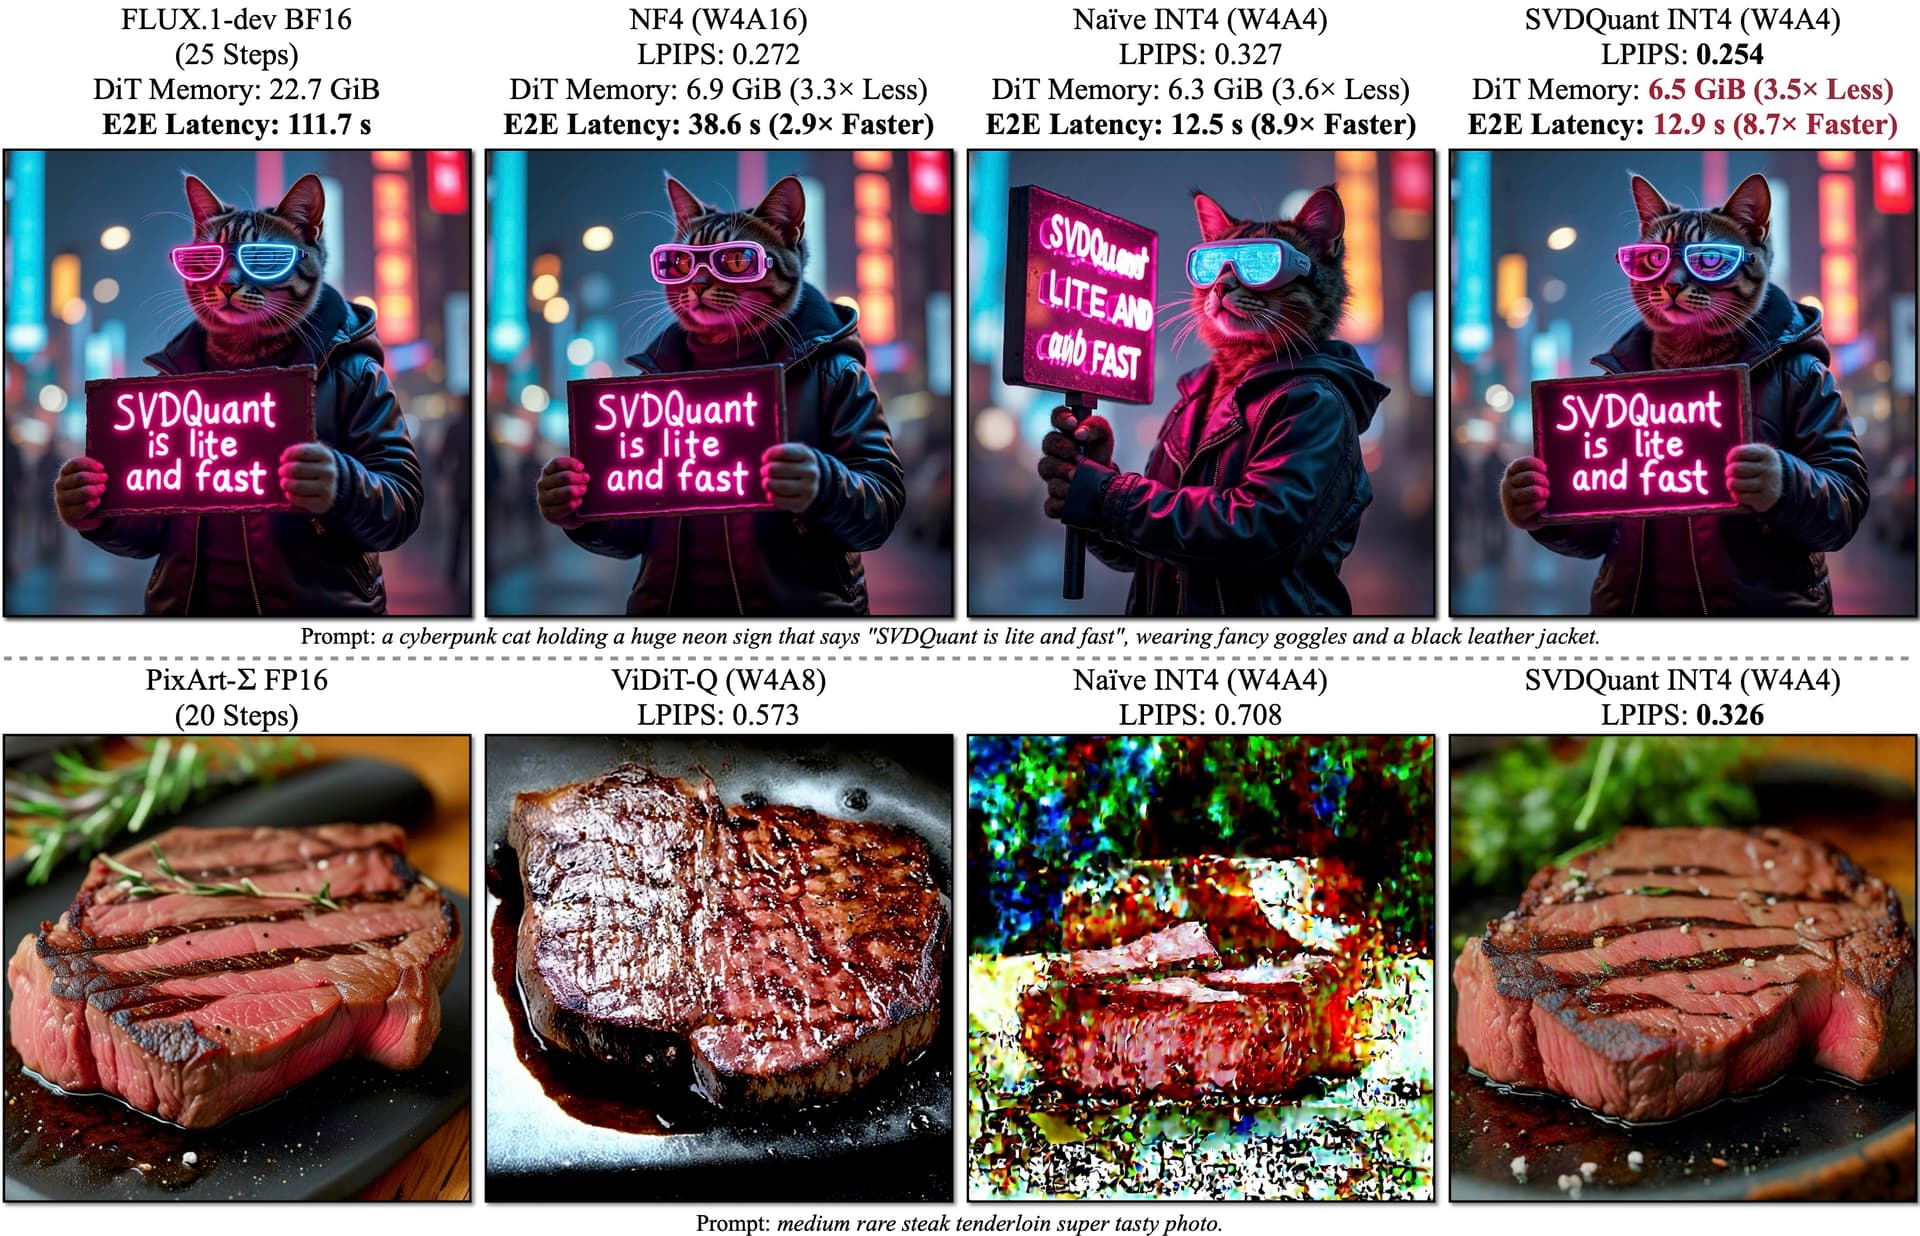
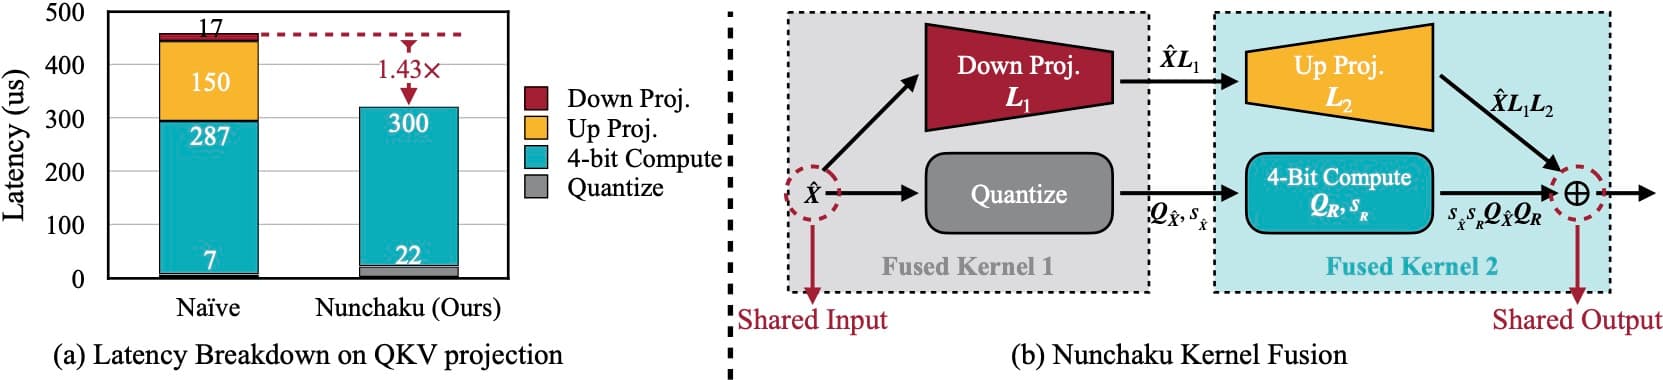

Nunchaku 源自 MIT HAN Lab 与 NVIDIA 等团队合作、2025 年被 ICLR 收为 Spotlight 的论文 SVDQuant(arXiv:2411.05007)。论文要解决的问题很具体:扩散模型的激活值和权重里存在大量离群通道(outlier channels),一旦压到 4-bit,量化误差直接毁掉画面质量;而传统 W4A16(只量化权重)虽然精度保住了,推理速度却不一定快。SVDQuant 的做法是同时量化权重和激活(W4A4),再用低秩分量把离群点「吸收」掉,让两边都变得可量化。
仓库目前 3963 star、288 fork,Apache-2.0 许可,未归档,最后一次推送在 2026 年 9 月,已迭代到 v1.2.0。配套的量化算法库在姊妹项目 DeepCompressor,权重发布在 Hugging Face 与 ModelScope。
可以把它想成给一幅油画做「低分辨率打印 + 局部高清修复」。朴素做法是把整张画降到 4-bit 打印,某些关键笔触(离群值)就糊了。SVDQuant 的做法是:先把所有离群笔触从画布上「吸」出来转移到一个单独的低秩补偿层里,这层用 16-bit 精确保存;剩下的主体部分此时已经足够均匀,可以放心用 4-bit 打印。最后把两层叠回去。
工程上对应三步:Stage 1 权重与激活都含离群值;Stage 2 通过一个可逆变换把激活中的离群值迁移到权重侧,激活变得好量化但权重变难;Stage 3 对被「加权」的权重做 SVD 分解,拆出一个低秩分支 L1·L2(跑 16-bit)和一个残差(跑 4-bit),难点被低秩分支吸收。
推荐装预编译 wheel(不需要自己编译 CUDA):先按文档装 PyTorch ≥ 2.5(Blackwell 需 PyTorch ≥ 2.7 + CUDA ≥ 12.8),再从 GitHub Releases / Hugging Face / ModelScope 下载对应 torch2.7-cp311-linux_x86_64.whl 形式的 wheel 安装。ComfyUI 用户可以用 ComfyUI-nunchaku 插件的 install_wheel.json 工作流直接装。
从源码编译则需要 CUDA(Linux ≥ 12.2、Windows ≥ 12.6)、gcc/g++ ≥ 11 或 MSVC,git clone --recurse-submodules 后 pip install -e ".[dev,docs]";setup.py 会自动探测本机 GPU 架构生成 -gencode 编译参数,NUNCHAKU_INSTALL_MODE=ALL 可编全架构。
命令行示例在 examples/ 目录,覆盖 flux.1-dev.py、flux.1-dev-lora.py、flux.1-dev-double_cache.py、sana1.6b.py、v1/z-image-turbo.py 等;Web 端则是 app/ 下的 Gradio demo(flux.1 的 t2i/fill/kontext/redux/sketch/depth_canny,以及 sana),另有官方线上 Demo nunchaku.ai。
scripts/build_docker.sh 引用了 docker/Dockerfile,但该目录当前在仓库中不可见,说明容器化构建路径并未完全开源(疑似通过 sync-to-private 私有化),对想自建镜像的用户不友好。Nunchaku 把「量化」从 LLM 推理圈的舒适区搬到了扩散与视频生成领域,证明 W4A4 在视觉生成上可行并且是净收益而非妥协。这直接改变了本地部署的经济性:一张中端显卡从「跑不动」变成「跑得比 16-bit 更快」,把 4-bit 推理从「能省钱」升级为「能提效」。它也把「低秩补偿 + 算子融合」确立为量化引擎的标准打法——后续同类引擎基本都在跟进这种结构分层思路。对 ComfyUI 生态而言,官方插件 + 官方量化权重让它迅速成为事实标准之一。
