
FastCuRL
nick7nlp/FastCuRL加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象你让一个数学基础薄弱的学生直接去做高考压轴题,他会怎么反应?大概率是抓耳挠腮、随机蒙答案,最后交白卷。但如果你把这个题目拆解成 10 道由易到难的阶梯练习,循序渐进地引导呢?
大语言模型(LLM)做复杂推理任务时,面临着同样的困境。直接让 1.5B 参数的小模型去挑战 AIME(美国邀请赛数学考试)级别的题目,它的表现往往差强人意——不是因为它"笨",而是因为训练方式没有给它足够的"台阶"。
FastCuRL(Fast Curriculum Reinforcement Learning)正是为解决这一问题而生。这个由 7 位研究者(Song Mingyang、Zheng Mao、Li Zheng 等)共同开发的开源项目,在 2025 年 3 月发布后迅速引发关注:它让一个仅有 1.5B 参数的小模型,在仅用 DeepScaleR 一半训练步数的前提下,实现了超越后者的数学推理表现。
FastCuRL 的核心创新是阶段性上下文长度扩展的课程强化学习框架(Curriculum RL with Stage-wise Context Scaling)。
传统的 LLM 推理训练往往是在固定的上下文窗口内进行的——模型要么训练短推理链,要么直接训练长推理链。前者导致模型无法处理复杂问题,后者则让模型在简单问题上浪费大量计算资源,训练效率低下。
FastCuRL 提出的方法更聪明:它将训练过程分成多个阶段(Stage),每个阶段逐步增加上下文长度。以 FastCuRL-1.5B-Preview 为例,训练被分为 4 个阶段:
这样设计的好处是:模型先在较短的上下文中学习基础推理模式,再逐渐扩展到更长的推理链。每进入新阶段,模型都能在前一阶段的"肌肉记忆"基础上继续攀升,而不是从零开始。
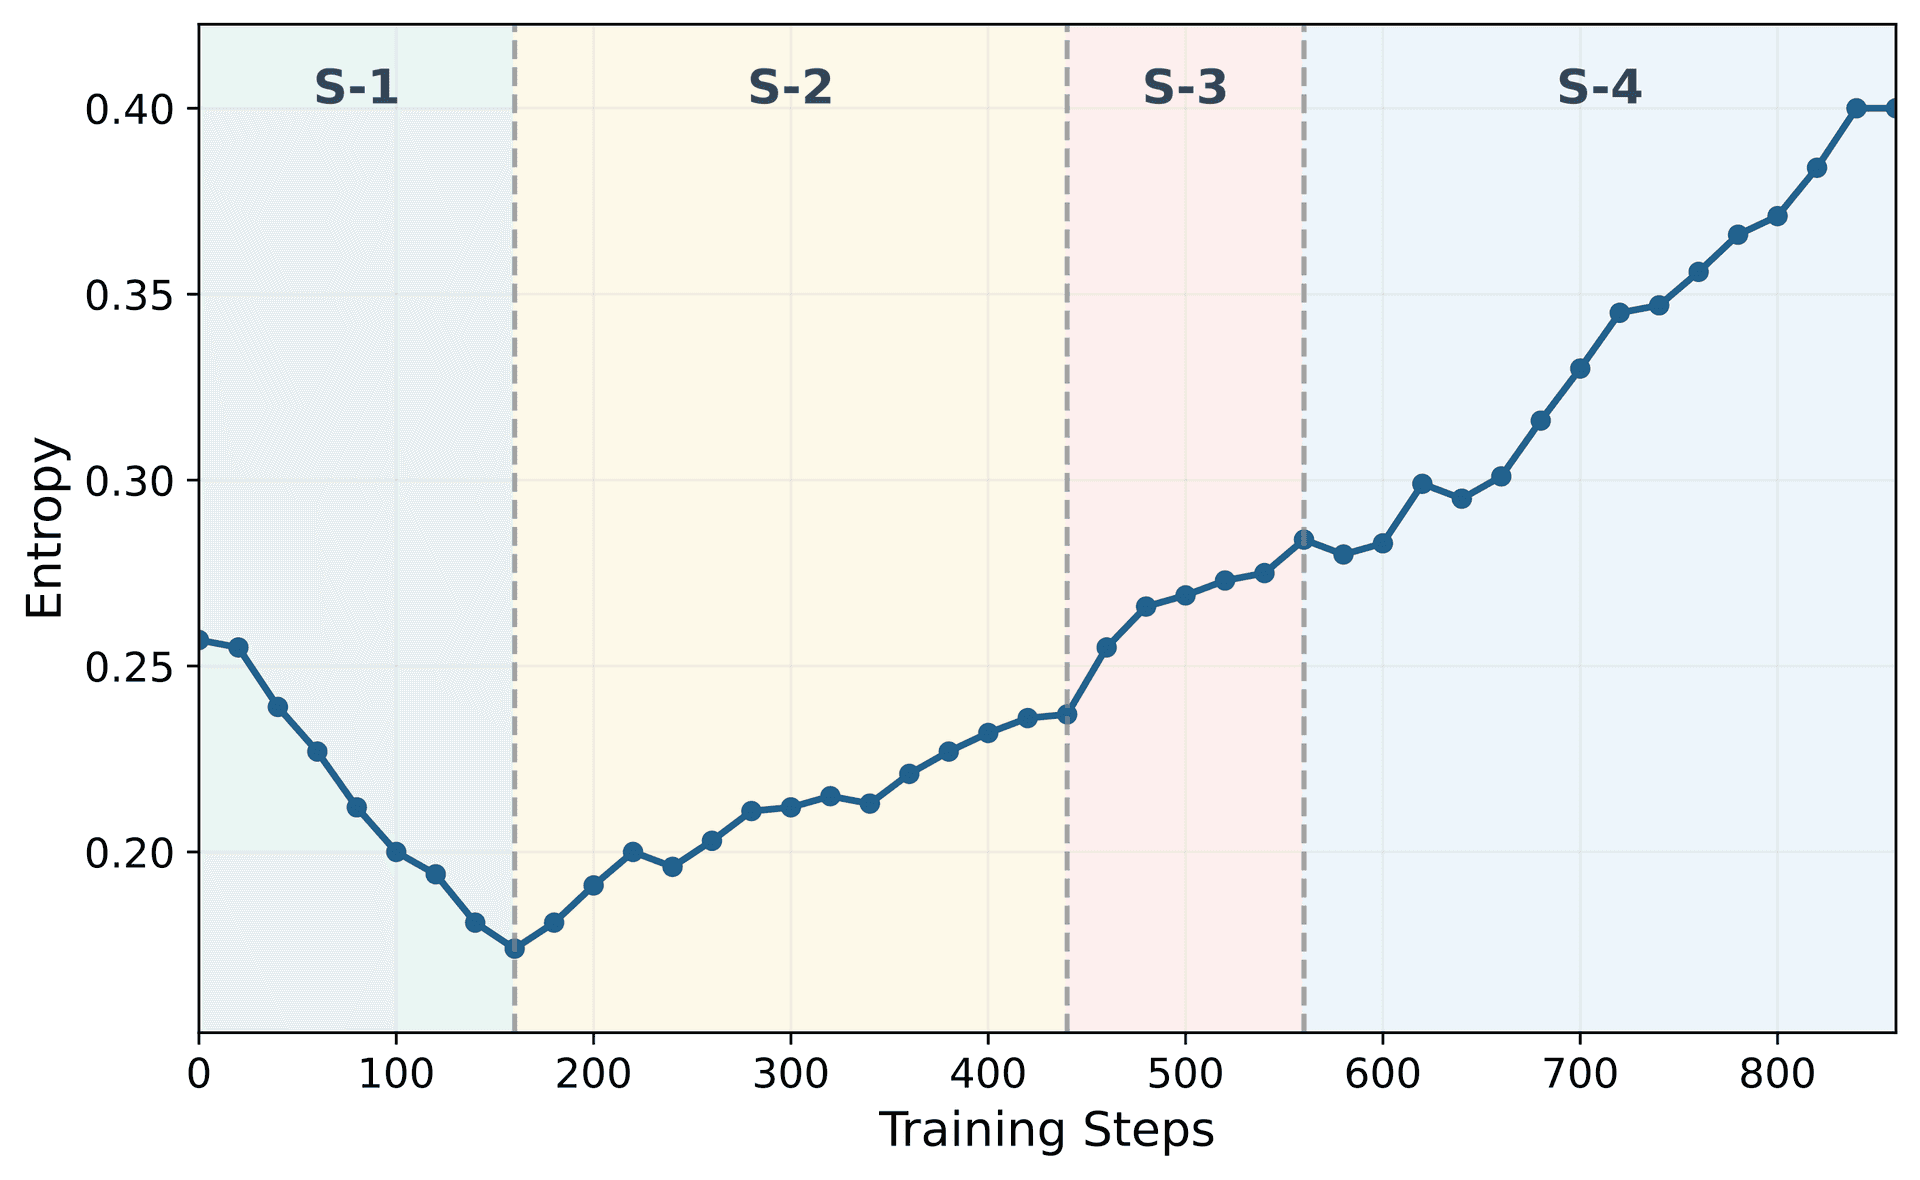
同时,研究者还监控了训练过程中的**熵(Entropy)**变化。熵代表了模型输出分布的不确定性——熵过高说明模型过于随机,熵过低则说明模型陷入模式化。通过精心设计课程,FastCuRL 实现了熵的平稳过渡,确保模型在每个阶段都保持良好的探索-利用平衡。
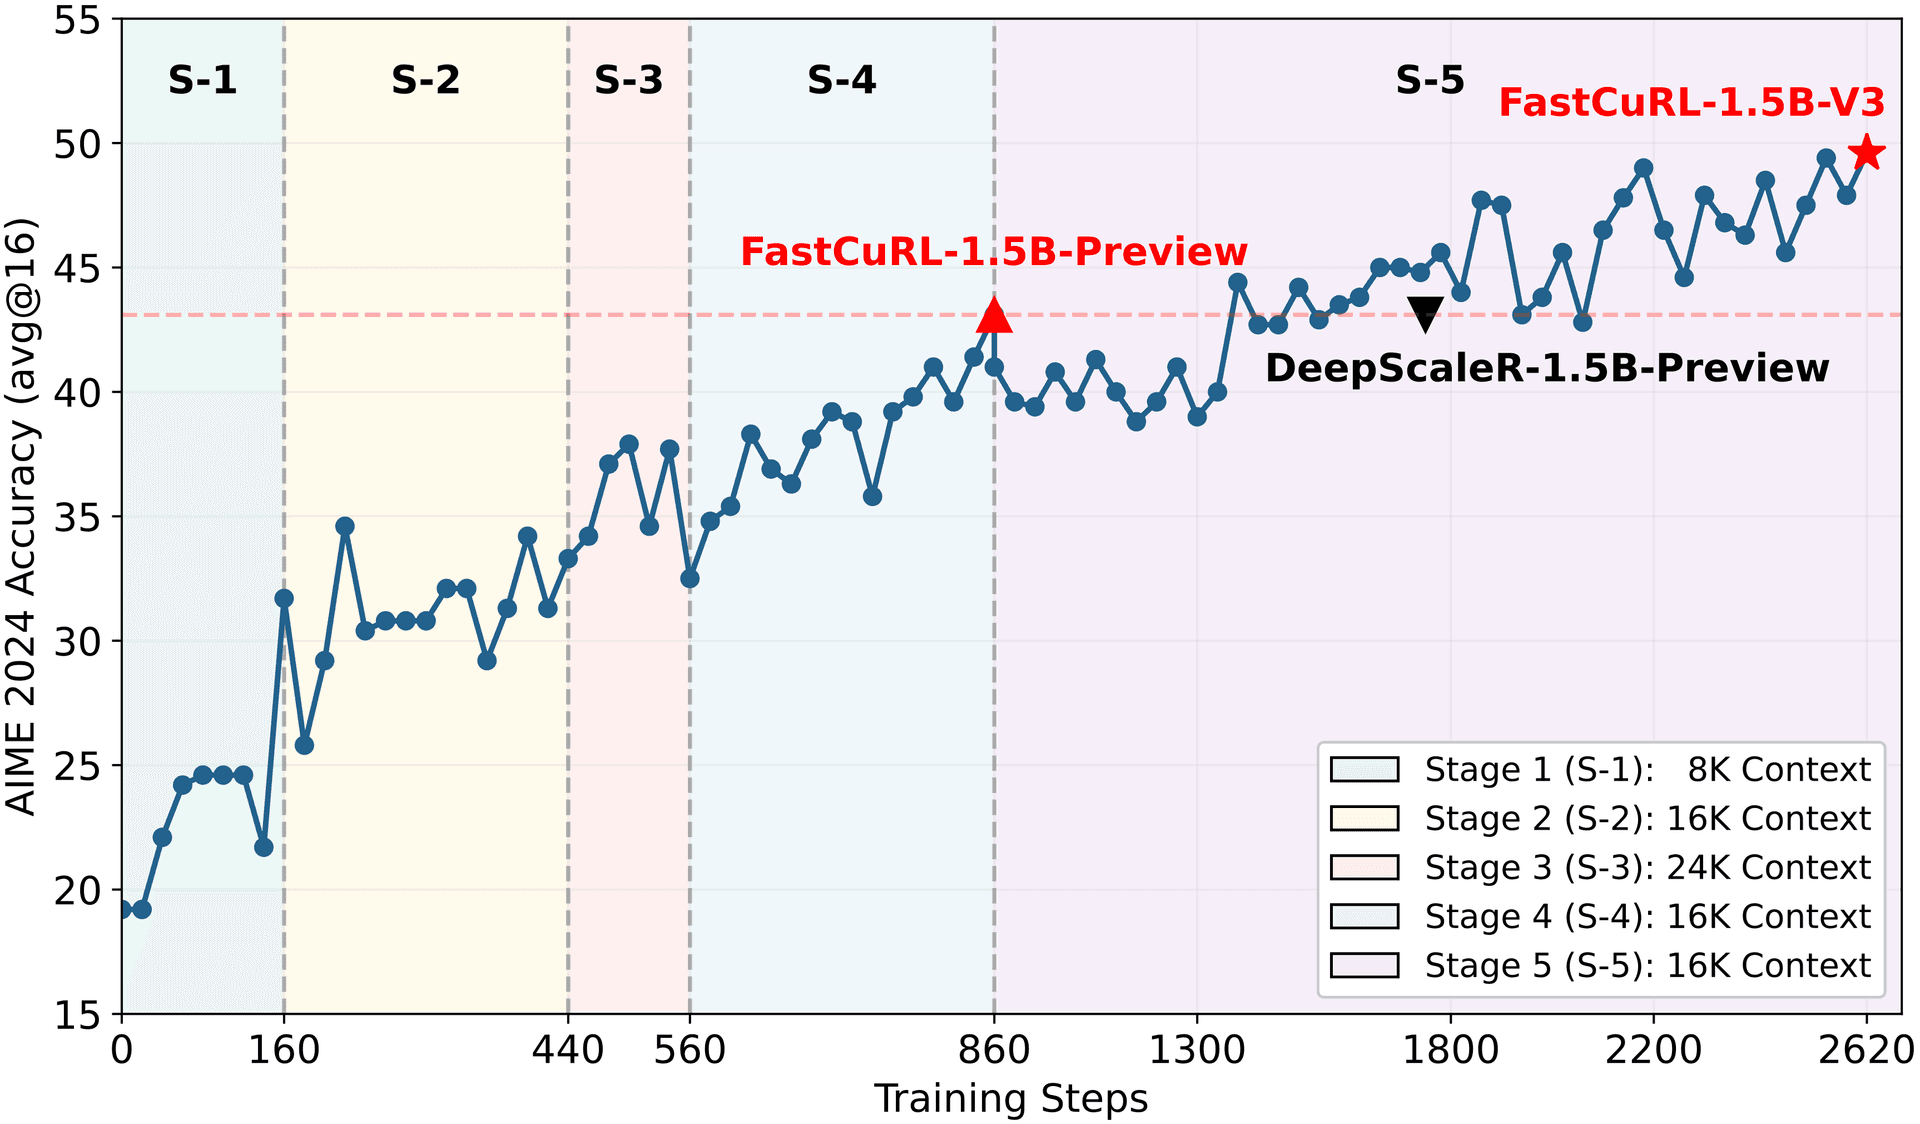
用一句话概括 FastCuRL-1.5B-V3 的成绩:在 AIME 2024 基准上,1.5B 参数的模型超越了绝大多数 7B 参数模型。
| 模型 | AIME 2024 | MATH 500 | AMC 2023 | 平均 |
|---|---|---|---|---|
| DeepScaleR-1.5B-Preview | 43.1 | 87.8 | 73.6 | 57.0 |
| FastCuRL-1.5B-Preview | 43.1 | 88.0 | 74.2 | 57.5 |
| FastCuRL-1.5B-V3 | 49.6 | 90.5 | 78.5 | 61.6 |
| Qwen2.5-7B-SimpleRL | 26.7 | 82.4 | 62.5 | 50.9 |
| rStar-Math-7B | 26.7 | 78.4 | 47.5 | — |
值得注意的是,FastCuRL-1.5B-Preview 仅用了约 860 步训练(batch_size=128),而 DeepScaleR 用了约 1,750 步——FastCuRL 用不到一半的训练成本,实现了略优的结果。V3 版本更是将训练步数扩展到约 2,620 步,在保持 8 GPU 资源的前提下,实现了显著的性能提升。
FastCuRL 的工程实现基于字节跳动的 veRL(Volcano Engine Reinforcement Learning)框架,这是一个生产级的 LLM 强化学习训练框架,源自论文 HybridFlow: A Flexible and Efficient RLHF Framework。
核心技术栈:
项目代码结构清晰,核心模块包括:
fastcurl/fastcurl/
├── rewards/           # 奖励函数(math_reward.py)
├── data/              # 训练与测试数据集
├── system_prompts.py  # ORM 提示词工程
└── utils.py           # vLLM / Gemini / OpenAI API 调用封装
FastCuRL 是典型的 CLI 驱动项目,没有 Web 界面,所有操作通过 shell 脚本完成。
训练(需要 8x GPU):
export CUDA_VISIBLE_DEVICES=0,1,2,3,4,5,6,7
export VLLM_ATTENTION_BACKEND=XFORMERS

# Stage 1: 8K 上下文
bash ./scripts/train/run_fastcurl_1.5b_8k_stage1.sh

# Stage 2: 16K 上下文
bash ./scripts/train/run_fastcurl_1.5b_16k_stage2.sh
# ... 以此类推
评估:
python3 -m verl.trainer.main_generation \
    trainer.nnodes=1 trainer.n_gpus_per_node=8 \
    model.path=${MODEL_PATH} \
    rollout.response_length=32768 \
    rollout.gpu_memory_utilization=0.9
硬件门槛方面,训练阶段要求 8 GPU(官方使用 NVIDIA A100 40GB),推理阶段单个 1.5B 量化模型可在约 12GB 显存内容纳。verl 子模块提供了完整的 Dockerfile,可基于 NVIDIA PyTorch 24.05 镜像快速构建训练环境。
FastCuRL 并非完美无缺,以下几点值得注意:
1. 领域局限:当前训练数据全部来自数学竞赛,模型在开放式推理、代码生成、多轮对话等场景的能力尚未被充分验证。课程学习的思想是否可以迁移到其他领域,仍是开放问题。
2. 训练资源门槛:虽然推理端对硬件要求不高,但训练需要 8 GPU 集群。对于个人开发者和小型实验室而言,复现完整训练流程仍存在较高门槛。
3. ORM 验证的开销:项目默认关闭了 ORM(Outcome Reward Model)验证功能。开启后虽然能更准确评估答案正确性,但 LLM 调用成本显著增加。
4. 基座模型的依赖性:所有实验均基于 DeepSeek-R1-Distill-Qwen-1.5B,不同基座模型是否适用相同的课程策略,需要进一步消融实验验证。
FastCuRL 的出现,再次印证了一个趋势:在特定领域,通过精心设计的训练策略,小模型可以逼近甚至超越比自己大数倍的大模型。
从更宏观的视角看,FastCuRL 代表了 2024-2025 年 LLM 推理训练领域的几个重要方向:
如果你正在研究 LLM 的推理能力提升、或者希望在自有数据集上复现 R1 类的慢思考能力,FastCuRL 是一个值得深入研究的参考实现。它的代码结构清晰、文档完整,且提供了多个版本的预训练模型(Preview / V2 / V3),可以直接下载到 HuggingFace 进行推理评测。
相关资源:
