
Vidura
narenaryan/Vidura加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你上一次找回了那个效果惊人的 Prompt 是什么时候?
想象一下:凌晨两点,你灵感迸发,写出了一条堪称"神咒"的 ChatGPT Prompt。你自信地保存了它——然后再也找不到。
这不是段子,是真实痛点。随着 GPT-3、GPT-4 的能力边界不断扩展,每个 AI 爱好者都在积累自己的 Prompt 资产:创意文案生成、代码审查、数据分析、翻译润色……个人 Prompt 库从几条变成几十条,分类混乱、重复存储、跨设备无法同步的噩梦随之而来。
Vidura 就是为解决这个痛点而生的。它取名自古印度史诗《摩诃婆罗多》中的贤臣 Vidura(毗德罗),寓意"智慧的管理者"。开发者 narenaryan 构建了一套完整的提示词管理后端 + Web UI,让用户可以优雅地组织、搜索、分享自己的 Prompt 资产。

Vidura 的定位并非简单的文本仓库,而是一个功能完善的提示词工作台。
分类与标签双维度组织:每个 Prompt 必须归属一个 Category(分类),同时可以打多个 Label(标签)。支持按标签聚合——点击任意标签,系统自动筛选出所有相关 Prompt。这套二维索引体系比单纯的文件夹分类灵活得多,特别适合拥有跨类别 Prompt 资产的创作者。
全文搜索:顶部搜索栏支持跨分类、跨标签的全局检索,输入关键词即可找到所有相关 Prompt,解决了层层目录翻找的低效问题。
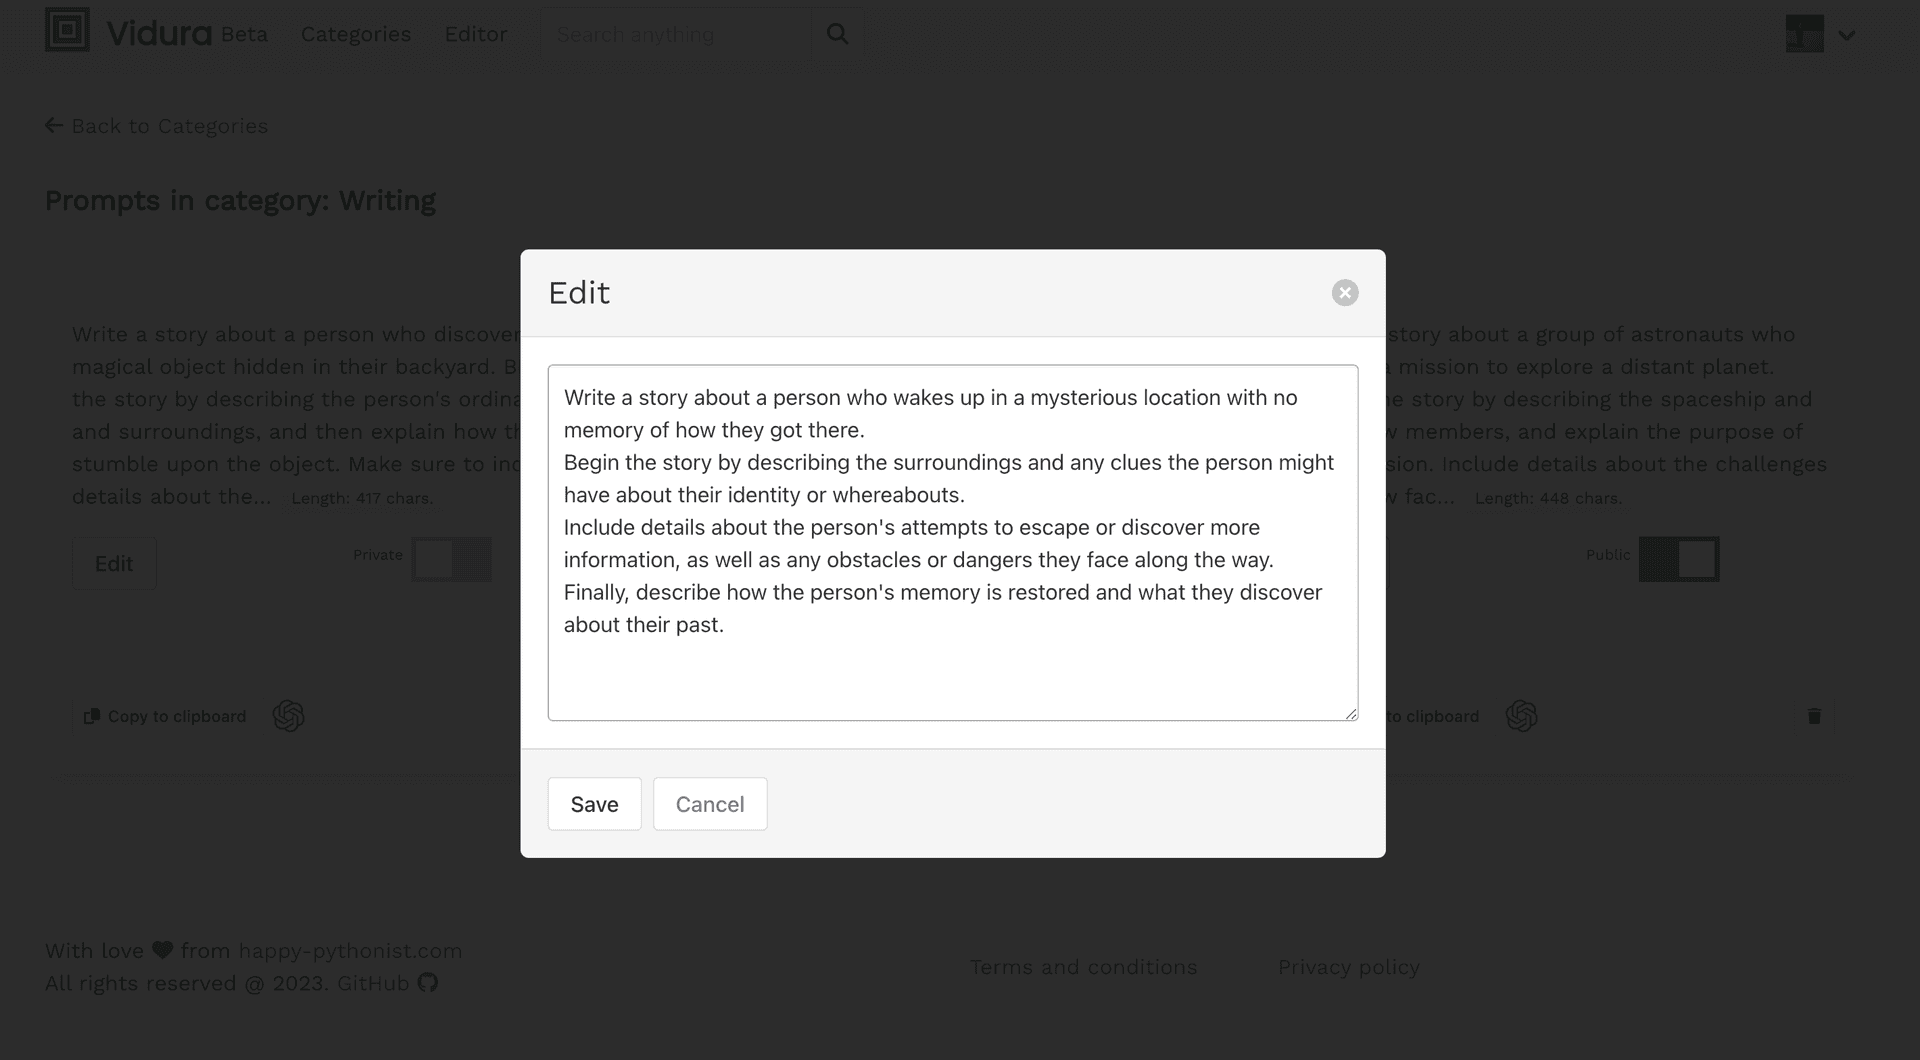
公开分享与社区发现:每个 Prompt 可以一键设为公开(is_public=True)。公开后的 Prompt 自动出现在社区活动流(Activity Stream)中,其他用户可以浏览、克隆到自己的分类中。系统使用 django-activity-stream 记录所有用户行为,形成动态的兴趣社区。
一键复制 + 直达 ChatGPT:点击"Copy to Clipboard"按钮复制 Prompt 内容,再点击 ChatGPT Logo 直接在新窗口打开 ChatGPT,Cmd/Ctrl+V 粘贴——两秒完成从管理到使用的闭环。这个细节体验大幅降低了使用摩擦。
| 层级 | 技术选型 |
|---|---|
| Web 框架 | Django 4.1.7 |
| REST API | Django REST Framework 3.14 |
| 认证 | django-allauth(支持 Google OAuth 登录) |
| 动态记录 | django-activity-stream |
| 数据库 | PostgreSQL(psycopg2-binary) |
| 生产服务器 | Gunicorn + uvicorn(ASGI 支持) |
| 前端 | Django Templates + 原生 HTML/CSS |
| 容器化 | 多阶段 Dockerfile |
核心实体包括:
MD5(text + username) 的去重哈希Prompt 模型通过 text_hash + owner + category 的联合唯一约束防止同一用户在同类下重复添加相同 Prompt,这个设计既保证了数据一致性,也避免了社区内的无意义重复。
系统通过 Django REST Framework 暴露了 Category 的读写接口(GET/POST /api/categories/),支持外部系统对接。README 中提到未来计划提供 Prompt 的导入导出 API。
项目提供了完整的多阶段 Dockerfile,基于 python:3.9-slim 构建,最终镜像包含所有运行时依赖。生产环境配合 Nginx + Gunicorn:
# 构建镜像
docker build -t vidura .

# 运行(需配置环境变量)
docker run -p 8000:8000   -e SECRET_KEY=your-secret-key   -e DATABASE_URL=postgres://...   vidura
对于本地开发,项目明确要求 Python 3.9+:
pip install -r requirements.txt
python manage.py migrate          # 数据库迁移
python manage.py loaddata promptbook/fixtures/init_data.yaml  # 导入初始分类
python manage.py createsuperuser  # 创建管理员账户
python manage.py runserver        # 启动服务
访问 http://127.0.0.1:8000 登录后台即可使用。
psycopg2-binary,项目强制使用 PostgreSQL 而非 SQLite,开发环境也需要准备 PG 实例django-allauth 集成 Google 第三方登录,需配置 GOOGLE_CLIENT_ID 和 GOOGLE_CLIENT_SECRET,无 Google 账号则使用本地用户名密码认证Vidura 最大的特色是内置的社区发现机制。每个用户的公开 Prompt 会出现在 Activity Stream 中,形成一种去中心化的 Prompt 社区。
项目在 README 中披露了 v2 路线图:
这些功能在 https://vidura.ai 的在线版本中已部分实现,本地开源版本目前尚不支持。
前端技术保守:项目使用纯 Django Templates + 原生 HTML/CSS,而非现代 SPA 框架。对于习惯 React/Vue 的前端开发者而言,代码复用和维护成本较高。
数据库强依赖 PostgreSQL:不支持 SQLite,部署复杂度略高。
无 API 管理 Prompt 本身:当前 REST API 仅暴露了 Category 资源,Prompt 的 CRUD 未通过 API 暴露,不便于程序化管理。
License 标注为 NOASSERTION:项目实际使用 LICENSE 文件(需验证具体许可证),但 GitHub API 返回 license 字段为 null,可能影响商业使用判断。
Vidura 代表了一种趋势:从"用好 AI"到"系统化管理 AI 提示词"。随着 GPT、Claude、Stable Diffusion 等模型的普及,Prompt 资产管理的需求正在从个人开发者的桌面笔记工具演变为专业化的系统软件。
这个项目的代码规模不大(核心 Django 应用仅约 500 行),但覆盖了认证、权限、分享、搜索等完整功能域,适合作为学习 Django 全栈开发的参考项目。
项目信息
| 属性 | 值 |
|---|---|
| GitHub | narenaryan/Vidura |
| 语言 | Python / HTML |
| 框架 | Django 4.1.7 |
| Stars | 108 |
| Fork | 15 |
| 许可 | LICENSE 文件(需进一步确认) |
| 在线体验 | https://vidura.ai |
