
vector-db-benchmark
myscale/vector-db-benchmark加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
凌晨两点,一位 AI 工程师在十几个向量数据库之间反复横跳:Qdrant 宣传"业界最快"、Pinecone 标榜"零运维"、Weaviate 强调"全能型"……每家的 benchmark 都声称自己第一。她最终凭感觉选了 Qdrant——但这个选择到底对不对?她自己也不确定。
这正是向量数据库领域的真实写照:缺乏统一的评测标准,每家都只展示对自己有利的数据,而用户真正关心的——在真实生产环境下,某款数据库到底表现如何——始终是个黑箱。直到 MyScale 开源了这份 benchmark 框架,事情开始有了转机。
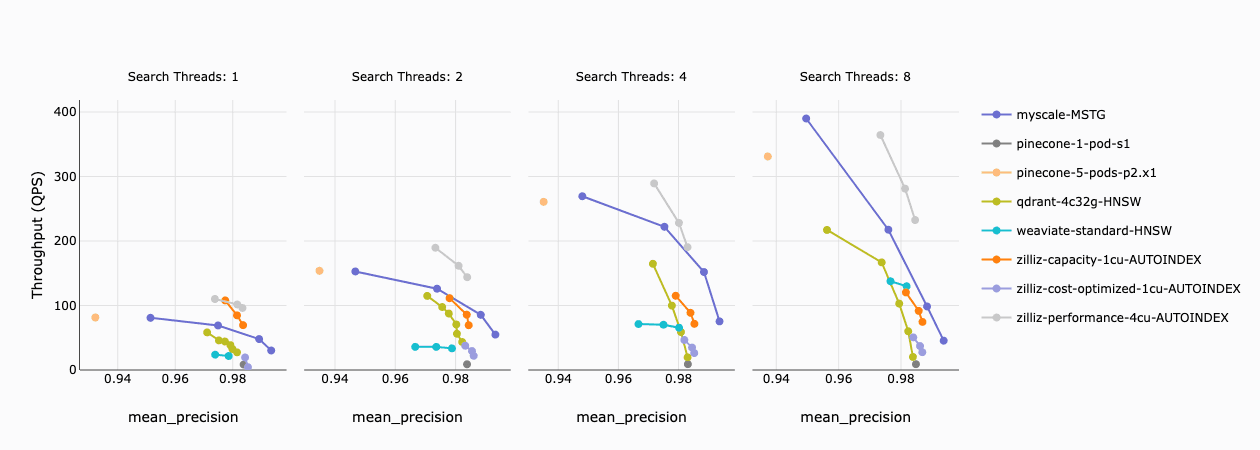
MyScale 是 ClickHouse 公司推出的云端向量数据库,基于 ClickHouse 强大的列式存储和向量化执行能力构建。2023 年,随着向量数据库赛道急剧升温——Qdrant、Pinecone、Weaviate、Milvus、Zilliz、Pgvector 等产品层出不穷——MyScale 团队发现一个问题:市面上缺乏一个公正、统一、可复现的向量数据库性能评测框架。
现有 benchmark 存在几个致命缺陷:
MyScale 的工程师在 GitHub 上 fork 了 Qdrant 的 benchmark 项目,针对全托管云服务场景做了深度定制,并在 2023 年发布了这一框架。开源的动机很明确:与其让竞品们各说各话,不如提供一套透明的工具,让数据说话。
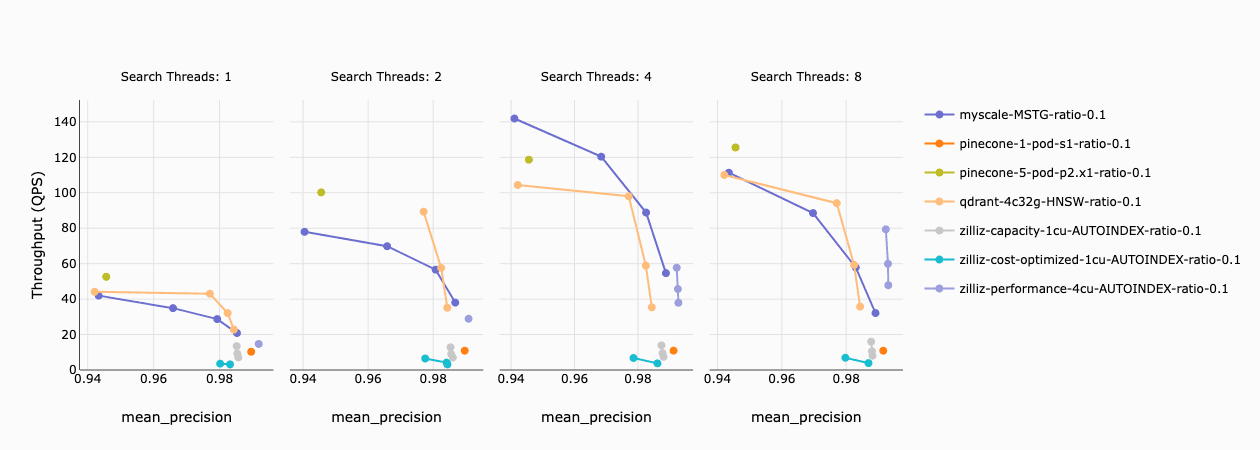
可以把这个 benchmark 框架类比为高考录取排名系统:
这样一来,原本抽象的"性能对比"就变成了普通用户也能理解的直观排名。
框架的核心引擎位于 engine/clients/ 目录,通过工厂模式(ClientFactory)为每个数据库提供统一的抽象接口。目前已支持 11 种主流向量数据库和云服务:
| 数据库 | 类型 | 接入方式 |
|---|---|---|
| MyScale | 云服务(全托管) | config.py + API |
| Pinecone | 云服务(全托管) | REST API |
| Qdrant | 自托管 / 云 | gRPC |
| Weaviate | 自托管 / 云 | REST API |
| Milvus / Zilliz | 自托管 / 云 | gRPC |
| OpenSearch | 自托管 | REST API |
| Elasticsearch | 自托管 | REST API |
| Pgvector | 自托管 | PostgreSQL |
| Redis | 自托管 | Redis protocol |
| Proxima | 自托管 | 自有协议 |
新增一个数据库的接入成本很低,只需在 engine/clients/ 下创建对应目录,实现 __init__.py、config.py、search.py 等标准文件即可。代码中大量使用了泛型接口设计,避免了 if-else 分支爆炸的问题。
benchmark/dataset.py 实现了标准化的数据集下载逻辑,支持 .h5(ANN H5 格式)、.jsonl 和 .tar.gz 三种数据集格式。框架自动从公开链接下载 ANN Benchmark 标准数据集(ANN-1B、GloVe、NQ 等),无需用户手动准备训练和查询数据。
from benchmark.dataset import Dataset
# 按配置初始化数据集并自动下载
dataset = Dataset(config)
dataset.download()
框架不只测 QPS,还采集了召回率、延迟、成本等多个维度:
结果以 JSON 格式输出到 results/ 目录,并可通过 scripts/process_result_files.py 聚合为统一格式。
框架与 MyScale 的 benchmark 官网 深度集成,支持将测试结果上传至腾讯云 COS 并渲染为 Plotly 交互图表。用户可以通过 docs/results-visualization.md 中的步骤,把自己的测试结果合并到官网的公开 benchmark 中。
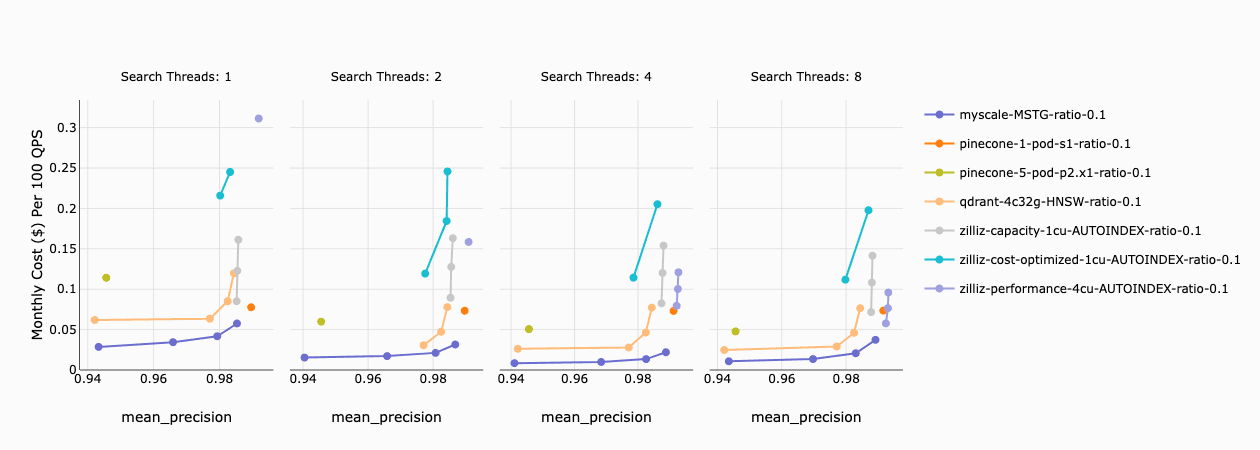
这个项目没有 Web UI,完全通过命令行驱动,对开发者的技术素养有一定要求。
# 1. 克隆项目
git clone https://github.com/myscale/vector-db-benchmark.git
cd vector-db-benchmark

# 2. 安装依赖
pip install -r requirements.txt

# 3. 按文档配置各云服务的连接参数
# 需要在各数据库官网注册账号并获取 API Key
# 测试所有数据库(通配符匹配)
python3 run.py --engines * --datasets glove-*-m-16-*

# 只测 MyScale,使用 glove 数据集
python3 run.py --engines myscale-* --datasets glove-*-m-16-*

# 指定云服务器地址
python3 run.py --engines myscale --datasets glove --host your-host --port 8123
项目提供了 Dockerfile,基于 mochix/ubuntu_22.04:latest 镜像,内置了主要依赖库。但需要注意:
python >=3.8, <3.11)框架采用分层模块化设计,顶层为 CLI 入口(run.py,使用 Typer 构建),中间层为数据集管理和引擎配置层,底层为各数据库的客户端适配器。
# run.py: CLI 入口,使用 typer 框架
app = typer.Typer()

@app.command()
def run(engines: str = "*", datasets: str = "*", host: str = "localhost", ...):
    selected_engines = read_engine_configs()
    selected_datasets = read_dataset_config()
    # 遍历执行 benchmark
核心架构亮点:
使用的主要技术栈:Python 3.8~3.10、Poetry(依赖管理)、Typer(CLI)、h5py(ANN H5 数据格式)、clickhouse-connect(MyScale 数据源)、boto3(S3 结果上传)。无 AI/ML 训练框架依赖,专注于数据采集和性能评测本身。
这是最核心的争议:benchmark 由 MyScale 维护,结果难免被质疑"偏心"。虽然框架本身完全开源、代码透明,但用户在看到"MyScale 在多个维度领先"时,仍然会问:谁来做裁判的裁判?
框架的设计者在文档中承认这一点,并将完整测试结果公开在 benchmark 官网,允许任何人 fork 项目并复现测试——这是对质疑的最好回应。
框架面向"全托管向量数据库",对于 Milvus、Qdrant 等自托管方案,配置过程较为繁琐(需要手动部署服务器、配置连接参数),不像云服务那样输入 API Key 即可开始测试。engine/servers/ 目录的存在说明框架曾考虑自托管场景,但目前维护重点明显偏向云端。
作为云服务 benchmark,网络延迟(客户端到云端 RTT)会显著影响 QPS 数值。框架本身无法消除这一干扰因素,用户需要在自己的网络环境下复现测试才能得出有意义的结论。
pyproject.toml 中 python = ">=3.8,<3.11" 限制了 Python 3.11+ 用户的使用,在 2024 年这个约束已经偏保守。
MyScale Vector Database Benchmark 的出现,填补了向量数据库领域缺乏中立评测标准的空白。它的意义不仅在于为 MyScale 打广告,更在于:
在 AI 应用爆发的 2023-2024 年,向量数据库成为 RAG(检索增强生成)和语义搜索的基础设施选型热点。MyScale 的这份 benchmark 工具,虽然在公正性上仍有改进空间,但已经迈出了关键的第一步:让数据开口说话,而不是让营销话术占主导。
本报告基于 GitHub 仓库 v0.1.0 版本(master 分支)分析,测试数据截至 2024 年 1 月。
