
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
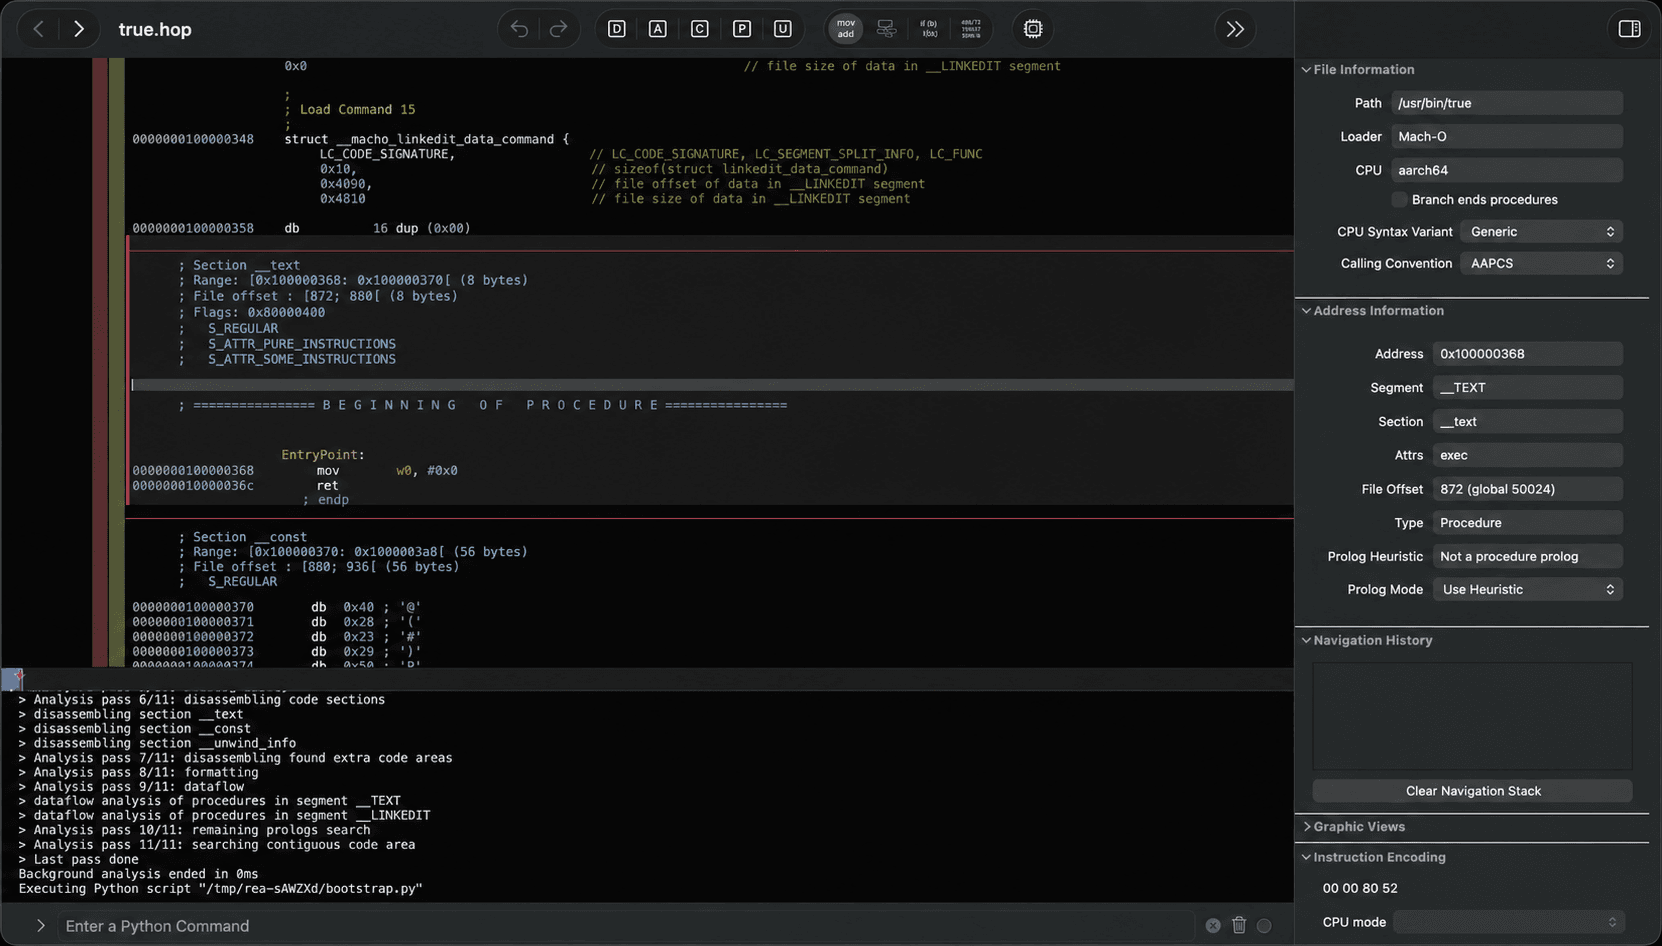
图:REA 的二进制分析结果示例
产品经理看到竞品 App 里一个很顺手的交互,想在自己的产品里复现。传统的做法是:找资深逆向工程师,用 Hopper 打开二进制,啃汇编,逆出协议,然后手写一份文档交付给开发。整个流程以周为单位计,费用以万计。
REA 想做的是把这条链路压成一句话:
"Understand how search works in the Notes app, show me the evidence, and build a similar feature for my project."
REA 的定位是面向 AI Agent 的逆向工程 MCP 服务器——对外只暴露一个标准协议接口,内部把逆向能力拆成一组可组合的分析动作。
它能处理的对象覆盖面很宽:
docs/ 目录按分析对象分成了几十篇独立文档,每一篇都是一份完整的操作指南。这个组织方式本身就说明了它的能力边界——不是「能分析点东西」,而是「每个目标类型都有专精路径」。
REA 输出的每个结论都附带两样东西:支撑它的证据和这次分析的局限。
这一点比听起来更重要。AI 助手最典型的失败模式是给出听起来合理但无法追溯的答案——它说「这个 App 用的是 AES-128 加密」,你无法判断这是它真读出来的,还是它猜的。REA 的设计直接针对这个痛点:证据让人可以验证,局限说明让人知道边界在哪。
它还支持构建 RL 环境(README 里有专门的 "Build RL environments" 章节),意味着这些取证过的分析过程可以被组织成强化学习的训练信号——让模型从「会描述」走向「会查证」。
接入 AI 客户端(推荐):
npx rea-agents setup
命令会交互式让你选择 Agent(支持 Claude Code、Codex、Cursor、Gemini CLI、Grok Build 等),展示将要做的修改,确认后写入 MCP server 配置和配套的工作流指令——已有配置会先备份。完成后重启 Agent 即可。
纯命令行:
npx -y rea-agents@latest analyze-javascript-application /absolute/path/to/app --json
输出是结构化 JSON,包含模块列表、导入关系、Electron 边界和各自的证据。
常规安装:
npm install --global rea-agents
rea --help
rea update
rea update 有个细节做得很克制:更新命令的 stdout 和 stderr 合并后最多保留 4 MiB,超限的元数据回复在进程退出后被拒绝——这是在防日志炸屏。
MCP 最大的痛点是工具描述会吃掉大量上下文。REA 为此做了两套 profile:
REA_MCP_INPUT_SCHEMA_PROFILE=full —— 完整字段说明与嵌套校验细节输出侧同理,REA_MCP_OUTPUT_SCHEMA_PROFILE 可设为 compact 或 off,用于应对客户端对 tools/list 帧大小的限制。两边都保留完整工具集和服务端规范校验,只调整描述长度。
这是有实际经验才会做的设计——说明作者踩过「工具太多把 Agent 上下文撑爆」的坑。
仓库结构:
src/ —— 核心分析引擎bridge/ —— MCP 契约与工具目录定义native/ —— Hopper / Ghidra / IDA 原生集成examples/ —— 示例分析目标docs/ —— 按对象分类的完整指南tests/ + stryker.config.mjs + stryker.semantics.config.mjs —— 测试与变异测试knip.json / knip.production.json —— 未使用依赖清理.jscpd.json —— 重复代码检测patches/、scripts/ —— 构建与补丁维护两套 stryker 变异测试配置(普通版 + 语义版)说明它对「测试是否真的有效」有要求,变异测试正是用来验证测试断言强度的。knip 清理未使用依赖、jscpd 检测复制粘贴——这些通常出现在追求长期维护的团队仓库里。
install.sh 顶部有一段很有意思的注释:脚本用 { 包裹整个函数体做截断守卫,因为 curl | bash 模式下如果下载被截断在 set 之后,bash 会把裸内建命令当命令执行并打印所有 shell 变量。这种「防御自己被截断」的写法,说明作者踩过坑。
依赖外部商业工具。 静态 JS/Electron 分析不需要额外依赖,但原生二进制分析需要 Hopper、Ghidra 或 IDA 三者之一。Hopper 是商业软件(有免费的个人额度),Ghidra 开源。原生层的能力边界,实际上被这三个工具的能力边界框住了。
许可证合规是绕不开的问题。 逆向工程在多数司法辖区有合法空间,但「复现竞品功能」和「规避保护措施」的界限并不清晰。REA 自己在仓库里放了 DISCLAIMER.md——做企业合规评估时,这份文件值得逐字读。
样本是攻击面。 分析目标通常是未知的、可能恶意的二进制。REA 强调分析在本地执行、不上传样本,这是对的;但真正的隔离(容器、虚拟机)责任仍在使用者。docs/installation.md 里还提到 Linux 上需要 procps 兼容的 ps 命令来做进程归属检查——这本身就说明它会去查看和分析系统进程。
热度与成熟度的落差。 39 万星标、3.4 万 fork,但项目创建于 2026 年 4 月,到今天才半年多。高星标部分来自 AI 编程社区的爆发式关注,工具链还在快速迭代。
中文文档是加分项。 README 提供简体中文、繁体中文、日语、韩语等 20 多种语言版本,对中文团队上手友好度很高。
REA 代表了一个新方向:AI 工具链正在从「写代码」向「理解既有系统」延伸。
当 AI 能写代码时,瓶颈就转移到了「拿到一个陌生系统并搞懂它」——接手遗留系统、竞品调研、安全审计、协议兼容,这些都是 AI 至今啃不动的硬骨头,因为它拿不到证据。
REA 的做法值得借鉴:把「取证」标准化成一组可被 Agent 调用的工具,并强制要求每个结论附带证据。这比单纯地让模型「更聪明」务实得多。
对我们的业务,短期内可以想到两个直接场景:一是老旧系统的接手与迁移——把没人看得懂的 Delphi/C++ 后端丢给 Agent,让它逆出接口;二是竞品功能调研——不是抄,而是理解某个功能在技术上如何实现,判断我们的实现路径是否更优。这两件事过去都要排队等资深工程师。
